Direction les bureaux de NVIDIA France qui ont été perquisitionnés il y a deux jours. L’entreprise est soupçonnée de pratiques anticoncurrentielles d’après l’autorité de la concurrence.
Les bureaux de NVIDIA France perquisitionnés !
Dans cette histoire, on n’en sait pas des masses, seulement que les bureaux français de l’entreprise ont été perquisitionnés. Effectivement, ni l’autorité compétente ni l’entreprise n’a laissé de commentaire ou de communiqué officiel. Cependant, nous apprenons toutefois que ce genre d’intervention reste relativement rare et n’est déclenchée qu’en cas de remontées de preuves dixit cafetech.
Maintenant, ne reste plus qu’à savoir ce que les autorités auront trouvé dans les locaux de l’entreprise. Par ailleurs, il n’est pas impossible que les bénéfices records récents de la marque aient attiré leur attention. Rappelons que le secteur de l’intelligence artificielle a boosté les revenus de l’entreprise. Les puces A100 et H100 partent comme des petits à tel point que les délais de livraison deviennent longs… Très long… D’autant que le matériel des verts se retrouve beaucoup dans tout ce qui est serveur et data center.
Par ailleurs, cela ne serait pas la première fois que l’entreprise s’adonnerait à des pratiques, parfois douteuses. On se souvient du GeForce Partner Program que l’entreprise a tenté de mettre ne place il y a quelques années en arrière. Ce contrat prévoyait des clauses clairement anticoncurrentielles. Fort heureusement, l’entreprise a fait machine arrière.
Bien sûr, il faudra attendre que l’autorité rende ses conclusions sur l’affaire. En attendant, tant que le jugement n’est pas rendu, l’entreprise est présumée innocente.
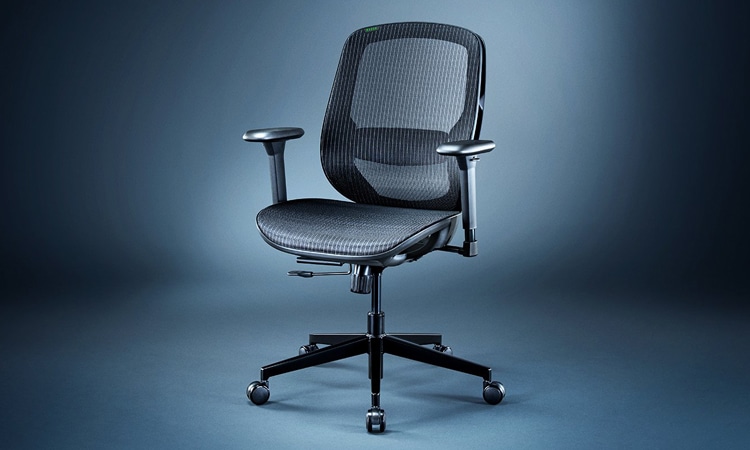
Direction la marque Razer qui nous propose maintenant de nouveaux fauteuils. Cependant, la marque vise le secteur des chaises ergonomique avec sa nouvelle série Fujin. Deux chaises sont au programme avec le modèle de base et la déclinaison Pro !
Fujin, des chaises basiques et Pro pour Razer !
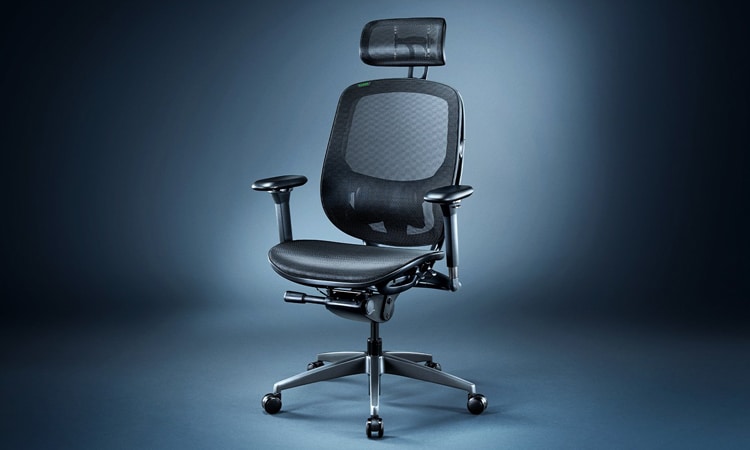
D’un point de vue design, Razer ne fait pas vraiment preuve d’originalité puisque le look des chaises reste classique pour un modèle ergo. Nous retrouvons alors un tissu maillé tendu sur le dossier ainsi que sur l’assise. Le tout étant supporté par une armature externe en alliage d’aluminium pour la version pro. Le modèle de base sera quant à lui en plastique… Enfin, en nylon.
Cependant, ce qui nous intéresse le plus dans le cas d’une chaise ergo, c’est la richesse des réglages. La chaise de base ne permettra que le réglage de la hauteur de l’assise, de ses accoudoirs ainsi que du support lombaire. Par ailleurs, le modèle Pro, c’est la fête puisque l’on pourra gérer la hauteur et la profondeur du support des lombaires. Les accoudoirs sont de type 4D et non 3D et on retrouve un appuie-tête réglable.
[affilizz-publication id= »tacnmvibd »]
En ce qui concerne les prix, on sait que les chaises ergo on tendance à être assez onéreuse, du moins, plus que les chaises gaming bêtes et méchantes. Néanmoins, avec Razer, on atteint rapidement des sommets puisqu’il faut compter 699,99 € pour la chaise de base contre 1199,99 € pour la version Pro. Comment dire que les prix sont complètement fumés ? D’autant que des chaises comme les ThunderX3 Yama 1 et Yama 5 proposent les mêmes réglages, peut-être un peu plus, pour des prix deux à trois fois moins élevés !
Si le SSD domine plus ou moins le secteur du stockage, les investissements ainsi que la recherche se poursuit côté disque dur. Si ce type de stockage peut semble préhistorique face aux SSD actuels, les disques durs continuent de proposer des capacités bien supérieures. Cette fois-ci, nous apprenons que Toshiba atteint également la capacité de 22 To avec sa série MG10 !
MG10 : du disque dur de 22 To chez Toshiba !
Avec ce nouveau disque dur, la marque nous propose alors un modèle au format 3,5″, format classique pour ce type de stockage. En interne, nous apprenons qu’il dispose de dix plateaux, tout comme la version de 20 To. Cependant, pour parvenir à cette capacité de 22 To, la marque a amélioré la densité des plateaux d’une manière ou d’une autre !
Sinon, il est question d’un modèle fonctionnant à une vitesse de 7200 tr/min. Néanmoins, les débits ne sont pas précisés, mais nous pouvons supposer qu’ils seront au moins égaux à 281 Mo/s… Ce que propose la version de 20 To actuellement. Sinon, un cache de 512 Mo répond aussi présent. Pour finir, on retiendra une consommation annoncée à 9,6W ainsi que sa capacité à fonctionner 24h/7j et sa garantie de 5 ans.
Pour la suite, nous apprenons que les concurrents, Seagate notamment, prévoient d’atteindre les 32 To grâce à la technologie HAMR. Chez Western Digital, actuellement, la marque met en avant des disques de 26 To avec des plans pour du 28 To prochainement.
Direction ADATA qui nous propose un nouveau boîtier avec son Battlecruiser II. Il est question d’un modèle équipé de nombreuses vitres en verre, le tout, afin d’assurer une vue bien dégagée sur votre configuration.
Battlecruiser II : une vue bien dégagée sur la configuration !
Dans les grandes lignes, on retiendra le fait qu’il s’agisse d’un boîtier au format moyen tour. Ce dernier accueillera donc une carte mère E-ATX sans broncher. Pour le reste de la configuration, nous pourrons miser sur une CG de 39 cm de long, un ventirad CPU de 175 mm de haut et une alim de 225 mm de profondeur.
Clairement, c’est un modèle qui met l’accent sur le verre trempé avec des vitres présentes en façade, sur les côtés et le dessus. Maintenant, la question que l’on se pose, c’est de savoir si la configuration pourra bien respirer.
Par ailleurs, le boîtier semble proposer un certain nombre d’options bienvenues comme le support de carte graphique. Idem, afin de faciliter le câblage, le boîtier propose un certain nombre de bandes velcro à l’arrière du plateau de la carte mère. Quant au refroidissement liquide, la compatibilité avec les radiateurs en 420 mm à l’avant ainsi qu’en 360 mm dans le haut est assurée !
Pour l’instant, pas de prix de connu, il faudra encore patienter.
Les GPU H100 et A100 de NVIDIA ont un sérieux succès dans le domaine de l’intelligence artificielle. La marque expédie des cargos entiers de cartes, mais le vent commence à tourner et on apprend que les cartes sont victime de leur succès. Effectivement, une pénurie se profile à l’horizon et les délais de livraison explosent, on parle d’un an d’attente ! Pour cette raison, la PDG de l’entreprise Lamini, une startup spécialisée dans l’IA et les modèles LLM se moque de la présentation de NVIDIA dans une vidéo.
Lamini se moque de NVIDIA et de ses H100 dans un vidéo !
Dans sa vidéo, nous y découvrons Sharon Zhou, PDG et cofondatrice de Lamini, dans une cuisine. Cette dernière ouvre le four pour voir ce qui se prépare, malheureusement rien de prêt avant 52 semaines. Puis elle se dirige sur la terrasse pour y sortir une RADEON Instinct du barbecue. Bref, toute cette mise en scène est une manière de tourner en dérision la présentation des A100 faite par Jensen Huang dans sa cuisine. De plus, le délai de 52 semaines évoqué dans la vidéo fait référence à l’année à attendre pour se procurer une des cartes des verts.
On comprend tout de suite le but de la vidéo : promouvoir la disponibilité immédiate des cartes d’AMD. De plus, l’entreprise fonctionne avec du matériel AMD (en plus d’être partenaire) depuis quelque temps déjà. Par ailleurs, sachez aussi que Lamini propose des modèles LLM personnalisés pour le monde de l’entreprise. Cela peut être rassurant pour leur client de savoir qu’en cas de besoin, la startup peut rapidement adapter son matériel sans délai d’attente interminable.
Quant au matériel d’AMD, on retiendra que les Mi250 affiche 128 Go de mémoire HBM2e. Les performances en computing sont données à 362 TFLOP en FP16 contre 383 TFLOP pour la Mi250x. À titre de comparaison, la H100 de NVIDIA met en avant un maximum de 94 Go suivant la version. Quant aux performances, elles affichent 312 TFLOP en FP16 avec des pics à 624 TFLOP suivant les scénarios. Sur le papier, nous avons donc des cartes tout à fait capables du côté d’AMD bien que l’offre de NVIDIA reste plus performante. Quant au prix, on retrouve de la Mi250 à près de 13 000 € contre plus de $30 000 pour la H100 de NVIDIA. Sacré ratio prix/TFLOP du côté d’AMD.
À voir comment le marché va réagir, mais il n’est pas improbable qu’AMD vende la carte prochainement. L’IA est un secteur qui croît rapidement et il est peu probable que des entreprises attendent un an avant que les H100 n’arrivent chez eux. Comme on dit, faute de merles, on mange des grives !
Jadis composé d’un seul morceau de silicium, les processeurs des ordinateurs et serveurs vont, de plus, en plus devenir des compositions de blocs logiques collés ou empilés les uns avec les autres. Focus sur ce qui est non pas une tendance, mais bel et bien une condition nécessaire à la poursuite de la course aux performances pour l’industrie des puces .
La nouvelle puce Meteor Lake qu’Intel vient de présenter en détails lors de son salon Innovation, ne ressemble à aucune autre puce que le géant américain a jamais lancé. Ce processeur qui prendra corps à partir du 14 décembre prochain dans des PC portables sous le nom de Core Ultra rompt en effet avec la tradition monolithique de l’entreprise. Pas besoin de microscope pour s’apercevoir que la puce est un « collage » de plusieurs « morceaux » de puces. Si on devait faire une analogie viticole ; le géant Intel, qui ne produisait jusqu’ici que des Bourgognes mono-cépages s’est converti à l’assemblage pour devenir un producteur de Bordeaux !
On pourrait se contenter de dire que l’arrivée de son nouveau PDG Pat Gelsinger en 2021 a été le début de moult changements chez Intel qui, avec sa stratégie IDM 2.0, fait sa révolution dans plusieurs de ses branches. Ce serait ne pas voir qu’AMD joue au Lego depuis un moment déjà, qu’Apple a déjà collé des M1 Max pour en faire des M1 Ultra. Ou que de nombreuses rumeurs font état de la conversion prochaine de Nvidia. La question est donc moins de savoir pourquoi Intel a changé, mais plutôt qu’est-ce qui est en train de forcer les producteurs de puces haute puissance à concevoir des puces comme des jeux de briques ?
Foveros et Chiplets : Optimiser les coûts au maximum
La première et principale raison, nous l’avions évoqué lors de la présentation même de la puce Meteor Lake, est celle des coûts. Le fait que AMD et Intel désormais conçoivent leurs puces à la carte est avant tout un moyen d’économiser de l’argent. Pourquoi graver la partie des entrées/sorties (IO die dans le jargon) en 4 nm si on peut se contenter du 7-8 nm ? Si la juste finesse de gravure est une donne d’importance, il y a aussi et surtout derrière une logique industrielle autour des rendements. Et pour comprendre cette logique, il faut se plonger un peu dans le merveilleux monde de la production de semi-conducteurs. Qui commencent leur vie sur un wafer, cette galette primordiale de silicium de 300 mm de diamètre et quelques microns d’épaisseur.
Après moult bains chimiques couplés à de multiples d’expositions au laser de scanners qui impriment les circuits, les composants électroniques sont découpés et testés. Testés en effet, car lors de la conception même des puces, de nombreux défauts peuvent apparaître à la surface du wafer, rendant le plus souvent les parties touchées inopérantes. Imaginez ainsi un wafer avec 10 erreurs réparties à sa surface. Si vous découpez de grandes puces de 3×4 cm, vous vous retrouvez avec un taux de déchet très élevé. Prenez le même wafer et découpez des blocs de 8×6 mm, et votre taux de rendement explose. Cette différence de rendement explique en grande partie pourquoi plus les composants sont grands, plus ils sont exponentiellement chers.
Si assembler des puces à partir de morceaux se paye en argent comme en technique (lire plus loin), ce mécanisme permet donc de faire baisser le prix final d’une puce composée. A ce gain potentiel d’argent basé sur les rendements purs, s’ajoute celui de la capacité à limiter les coûts d’amorce des nouveaux nodes de production. En effet, la production d’un nouveau composant prend un temps de calibrage des machines et des procédés, une période de lancement qui coûte cher. Maximiser les rendements lors de l’introduction d’un nouveau process permet de limiter les coûts de lancement de manière significative. Une fois le procédé maîtrisé et les rendements de pointe atteints avec de petits processeurs (ou bouts de puces), il est bien plus facile (et moins coûteux !) d’appliquer la même recette à des composants plus grands dont le taux de déchet est naturellement plus élevé.
Cela, on le constate depuis des années avec les puces de smartphones : avec leurs volumes délirants, leurs marges plus importantes et leurs puces plus petites, nos téléphones intelligents profitent de nodes de gravure les plus fins. Le lancement début septembre de l’iPhone 15 Pro et sa puce A17 Pro gravée en 3 nm nous le rappelle – il s’agit de la première puce produite en masse dans cette finesse de gravure. Et il faut se réjouir ici que les incroyables volumes de production des ventes des SoC mobiles finance en partie les puces informatiques de demain !
Notez bien que l’ère de l’assemblage des chiplets ne signifie pas la disparition totale des grosses puces. Pour s’en convaincre, il suffit de regarder la taille du méga processeur Cerebras qui fait littéralement la taille d’un wafer découpé en carré (d’où son nom de wafer scale engine ou moteur de la taille d’un wafer en français) ! Certaines puces professionnelles comme les Xeon ou les EPIC, dont certaines sont déjà composées, ont tout de même des morceaux de puces assez énormes. Ce afin de garantir un maximum de performances. Car la conception désagrégée emporte avec elle des limites et des contraintes, comme une plus grande latence entre certains éléments de la puce par exemple. Mais ces petites pertes peuvent être en partie limitée.
Faciliter la diversification du portfolio de puces
Une fois la donne des rendements admise comme la raison principale du « grand jeu de briques », s’ajoute ensuite la recherche d’optimisation des coûts lié au portfolio de l’offre de chaque concepteur. Intel, AMD et les autres développent en effet des centaines de références de puces tous les ans. Des puces d’entrée, de milieu ou haut de gamme, des puces basse consommation ou haute puissance : entre les besoins clients et les effets de gamme, les vendeurs de processeurs ont un besoin de variété.
Dans l’approche classiques des processeurs monolithiques, une des astuces pour créer des puces différentes est de les qualifier différemment. Selon les erreurs à la surface du wafer, selon les besoins de la segmentation marketing, il s’agit de voir les fréquences à la baisse ou désactiver un ou plusieurs cœurs CPU ou GPU – contrôler le nombre de cœurs actif des différents blocs logiques est un moyen efficace de jouer sur les performances des puces. Ce qui explique donc pourquoi physiquement, le Core i5 le moins cher ressemble souvent à un Core i9. Dans ce dernier cas, la puce a passé tous les tests hauts la main et s’avère être la version ultime du design. Dans le premier cas, il s’agit d’un die qui tenait moins la route dans les hautes fréquences et se retrouvait amputé d’un ou deux cœurs.
L’assemblage des blocs logiques a ici une grande force : la possibilité pour les concepteurs de puces de réaliser des puces très complexes et/ou à la carte. Le tout sans avoir à passer par la case de la qualification d’un nouveau design de puce monolithique. Avec de plus, la possibilité de répondre précisément à un client qui, ça veut plus de cœurs CPU, là veut une partie graphique intégrée moins puissante et moins chère.
Concevoir le schéma des puces est une entreprise d’une telle complexité qu’il faut désormais s’épauler de l’IA pour rechercher les meilleurs routages de l’information au sein des circuits. Des circuits dont il faut réaliser qu’ils sont tridimensionnels. Une profondeur qui apporte un élément de complexité, non seulement durant la phase de design, mais qui apporte surtout des limites pendant les phases de lithogravure (et de test !). Ainsi, il y a une limite au nombre de couches de circuits que l’on peut graver à la surface du wafer, une limite qui oblige à s’étaler. Un étalement peu compatible avec les besoins de compacité de nos appareils électronique, smartphones comme PC.
Le « grand jeu de blocs » apporte là encore une nouvelle piste pour contourner ces limites : empiler les modules. Il vous suffit d’aller chez votre cybermarchand préféré pour acheter de telles puces chez AMD. Affublés de la mention « X3D », les processeurs du type Ryzen 9 7900X3D sont des puces classiques sur lesquelles AMD (et TSMC !) ont ajouté, à la surface, de la mémoire cache afin de favoriser l’exécution de certaines tâche (ici, les jeux vidéo). Pourquoi de la mémoire cache ? Car celle-ci est composée de cellules d’une mémoire appelée SRAM qui a comme limite de ne pas se miniaturiser aussi bien que les transistors des blocs logiques que sont les CPU et GPU. Pour une surface donnée, les ingénieurs réfléchissent bien la quantité de mémoire cache dont ils ont besoin, chaque kilo-octet consommant une surface précieuse. Bien qu’impliquant des limites, notamment thermiques – il y a une couche qui chauffe en plus par-dessus une autre, ce qui explique les fréquences un peu à la baisse des processeurs AMD ainsi conçus – coller de la mémoire est une méthode astucieuse pour profiter de plus de mémoire à peu de frais.
Si vous suivez l’actualité des semiconducteurs, vous avez sans doute entendu parler de certains de ces acronymes : EMIB, CO-EMIB ou encore Foveros chez Intel ou encore CoWoS chez TSMC. Ces différentes technologies de « packaging » c’est-à-dire d’intégration de morceaux de die les uns avec les autres sur un substrat, sont les armes fatales de ces deux titans des puces pour repousser les limites actuelles du silicium. Qu’il s’agisse des énormes EPYC ou des petits Core Ultra, aucun de ces produits n’aurait jamais pu voir le jour dans ces conditions sans un savoir-faire de pointe d’interconnexion au micron près.
Est-ce à dire que ces deux entreprises sont les seules à savoir assembler ou empiler les morceaux de die ? Certes pas : outre les savoir-faire des Samsung, STMicroelectronics, Sony (notamment pour les capteurs empilés) ou Global Foundries, il faut aussi compter sur des acteurs comme les Taïwanais ASE Technology Holdings qui sont uniquement spécialisés dans ce domaine du packaging (et du test). Mais Intel et TSMC sont, de loin les plus avancées, non seulement en termes de savoir-faire avec des technologies de pointe, mais aussi en capacités de production. Il s’agit en effet d’un autre type de savoir-faire que la gravure qui requiert, en plus de connaissances supplémentaires, d’usines et de machines spécifiques. Les deux titans s’affrontent ainsi à coup de dizaines de milliards de dollars. Rien qu’à lui tout seul, Intel a ainsi investi 7 et 3,5 milliards de dollars entre ses usines malaisienne et Penang et américaine du Nouveau Mexique (USA). Et TSMC fait de même sur ses terres, avec le futur site de Tongluo à 2,9 milliards de dollars, sis dans le comté de Miaoli, au nord-ouest de l’île.
Un autre avantage de l’empilement des blocs est la possibilité de créer des puces jadis inconcevables pour des raisons de rendement comme on l’a vu. Avec l’amélioration des techniques de refroidissement – généralisation du watercooling dans les supercalculateurs – les concepteurs de puces ont pu créer des monstres comme la puce graphique « Datacenter GPU Max » (nom de code Ponte Vecchio). Avec ici une autre limite : celle du substrat.
Ce support pour les dies et les chiplets – la « plaque » sur lesquels on colle, empile et relie les blocs entre eux – devient une nouvelle frontière. Et c’est, une fois encore, Intel qui pourrait venir repousser les limites actuelles du substrat organique sur lequel les fabricants posent et connectent les bouts de puces. Actuellement basé sur une fibre de verre laminée, ce matériau hétérogène ne peut pas être utilisé pour composer les puces géantes dont l’industrie aurait besoin. Et la densité des trous – qui permettent le passage des circuits d’interconnexion entre les différents « morceaux » de puces – est limitée. Voilà pourquoi Intel développe des années un nouveau substrat homogène en verre, un support qui devrait voir le jour dans des applications commerciales d’ici à la fin de la décennie. Un substrat qui qui va lui permettre d’entasser plus de briques – de des briques de plus en plus grosses par-dessus le marché.
Si la réduction de la finesse des circuits va devenir de plus en contraignante à mesure que l’on s’approche des limites physiques, le jeu d’assemblage auxquels les industriels s’adonnent aujourd’hui, avec la promesse de puces géantes qu’il porte avec lui, promet de faire vivre, quelques années encore, la célèbre loi de Moore. Et d’assouvir ainsi, l’inextinguible soif de puissance de calcul des Hommes.
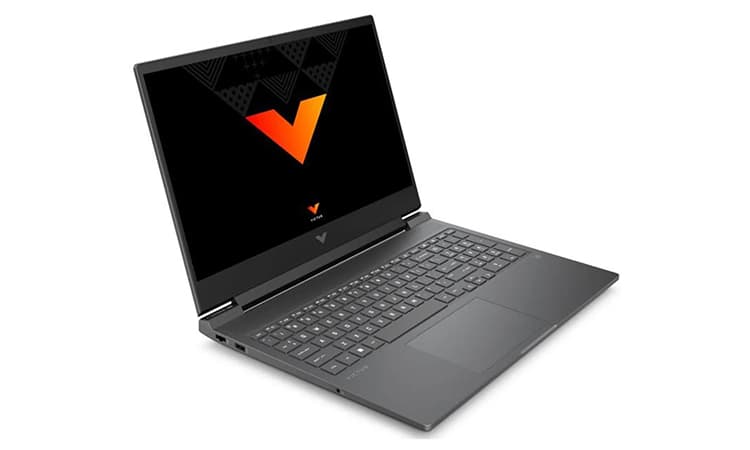
Nouveau bon plan avec un PC portable gaming signé HP qui se retrouve actuellement en promotion chez CDiscount. Effectivement, le marchand du groupe Casino nous propose alors le Victus Gaming 16-S0019NF à partir de 1200 €, 1175 € à condition d’entrer le code promo 25DES299 !
HP Victus 16-S0019NF, le PC portable Gaming d’HP avec Ryzen 7 et RTX 4070 à 1175 € !
Au programme, nous retrouvons donc un PC équipé d’un écran de 16″ affichant une résolution full HD. Par ailleurs, la réactivité s’annonce bonne puisque la dalle fonctionne à une fréquence de 144 Hz.
Pour l’animer, HP opte pour une partie graphique à base de RTX 4070. Cependant, ne vous faites pas avoir par cette dénomination puisque la carte ne propose pas la même configuration que son homologue desktop. Avec sa configuration (36 SM), attendez-vous à avoir des performances proches d’une RTX 4060 Ti plutôt qu’une 4070. D’autant que c’est un modèle qui dispose de 8 Go de VRAM et non de 12 Go comme sur son homologue bureau.
La partie processeur s’appuie alors sur un Ryzen 7 7840HS, un modèle doté de 8 cœurs/16 threads. Ce dernier met en avant une fréquence boost de 5,1 GHz contre 3,8 GHz de base, le tout, pour un TDP de 35W.
Pour finir, le PC dispose de 16 Go de RAM et d’un petit SSD de 512 Go.
Pour le prix, comme nous vous le disions, compter 1199,99 €. Avec le code promotionnel 25DES299, vous pourrez abaisser la facture à 1174,99 € !
Le boîtier Sugo 17 de Silverstone donne de ses nouvelles puisque la marque vient de mettre en ligne sa fiche technique. Pour rappel, c’est un boîtier destiné à accueillir de grosses configurations dans un format plutôt compact. Il était initialement présenté lors du Computex cette année.
Sugo 17 : la fiche technique de Silverstone en ligne !
Avec ce modèle 17, la marque rompt avec la « tradition » des boîtiers ITX. Ce modèle se destinant à accueillir des cartes mères allant jusqu’au format micro-ATX. En même temps, avec ses dimensions de 202 (L) x 451 (P) x 286 (H) mm. Ces dimensions permettent également de ne pas être trop limité quant au choix du ventirad CPU. Ce dernier, si on le souhaite, pourra atteindre les 158 mm de hauteur, la taille d’un AK620 Digital de DeepCool !
Le montage de la carte graphique est assez particulier puisque cette dernière reposera à l’horizontale, ventilateur le haut dans le compartiment supérieur du boîtier. Pour procéder à son montage, un riserPCIe est présent. D’autant que ce compartiment propose un espace conséquent avec 400 mm de longueur pour 174 mm de largeur et une hauteur de quatre slot. Vous aurez même la possibilité de monter jusqu’à trois ventilateurs en 120 mm dans le haut pour aider à son refroidissement. Pendant ce temps là, on retrouve quatre emplacements en 80 mm sur le côté !
D’ailleurs, en parlant de ventilation, outre les emplacements cités précédemment, on retrouve également trois emplacements en 120 mm sur la droite. Tout ce petit monde est également complété par un emplacement en 120 mm à l’arrière !
Nous terminons par mentionner la partie stockage qui met en avant trois emplacements 2,5″ ou 2×2,5″ et 1×3,5″. Quant à l’alimentation, on pourra y monter un bloc ATX mesurant jusqu’à 220 mm de longueur avec une carte mère ITX !
Pour le prix, il faudra patienter encore un petit peu. Néanmoins, si la fiche technique est en ligne, on peut supposer que le lancement devrait avoir lieu prochainement.
Il n’y a pas si longtemps, nous apprenions que la marque Lian Li portait plainte contre Phanteks. Le motif ? Une violation de brevet en lien avec un système de branchement en série des ventilateurs D30 via le cadre. Comble de l’ironie, alors que la situation est tendue entre les deux marques, le néerlandais remue le couteau dans la plaie en annonçant ses D30-140 !
D30-140 : nouveaux ventilateurs pour Phanteks malgré la plainte de Lian Li !
Comme nous vous le disions ici, Phanteks estime être dans son bon droit dans cette affaire avec Lian Li. C’est donc la raison pour laquelle l’entreprise complète sa gamme de ventilateurs D30. Cette fois-ci, la marque décline ses ventilateurs en 140 mm, ils viendront compléter ceux en 120 mm. De plus, cela permettra à la marque d’annoncer son Glacier One 420 D30, encore absent au bataillon !
Dans les faits, nous retrouvons des ventilateurs inspirés de la série originale, mais plus gros. Ainsi, les moulins profitent d’un cadre épais doté de nombreux inserts aRGB tandis que le mode de branchement en série n’a pas changé. Effectivement, le cadre dispose d’un connecteur permettant de relier les ventilateurs les uns aux autres via un clip faisant le lien entre chaque moulin. Enfin, des caches vis permettent de soigner le montage.
Pour l’heure, nous ne connaissons pas encore toutes les caractéristiques de ces derniers. Le flux d’air ainsi que la pression statique ne sont pas communiqués.
Cependant, on sait que deux versions seront proposées, la première avec des pales normales, la seconde, avec des pales reverse. Le but étant de conserver une certaine esthétique sans faire un trop gros sacrifice sur les performances. Enfin, deux coloris sont au programme avec du noir et du blanc, le tout, décliné en pack de trois ou à l’unité.
Nouveau radiateur de watercooling à voir le jour chez EKWB. La marque dévoile alors son EK Quantum Surface, un nouveau modèle intégralement noir qui se décline en 360 mm et 240 mm.
Quantum Surface : du radiateur de watercooling intégralement noir chez EKWB !
Ces nouveaux radiateurs viennent donc compléter la série Quantum Surface déjà existante. La marque nous propose alors des radiateurs déclinés en 240 mm et 360 mm, tout en affichant un coloris noir intégral. On pourra alors assembler des configurations discrètes et sobres.
Le choix des matériaux de ce modèle se porte sur du cuivre pour les ailettes et les canaux. Pendant ce temps, nous retrouvons des baies de brassage en laiton tandis que les parties latérales sont en acier inoxydable. D’ailleurs, en parlant d’ailettes, on retiendra également une densité de 20 FPI (fins per inch).
Concernant les dimensions, le modèle en 360 mm mesure 405 (L) x 140 (P) x 30 (H) mm. La version en 240 mm, plus compacte, mesure quant à elle 285 mm de long. Forcément, le poids est assez important du fait de la présence d’éléments en cuivre : 730g en 240 mm contre 950g en 360 mm.
Pour finir, le raccordement à la boucle de watercooling custom se fera via deux filetages en G1/4″.
Au niveau des prix, il faudra compter un peu plus de 80 € en 240 mm et près de 100 € en 360 mm.