Un outil soutenu par Intel pourrait booster les FPS de 60 % : info ou intox ?

Une nouvelle application d’optimisation automatisée, baptisée Hypertune, commence à faire le buzz après avoir été soumise à des phases de test auprès de 60 000 passionnés possédant un PC. Selon une analyse publiée par GamesBeat, une société de jeux basée à Miami a annoncé le lancement de cette plateforme, nommée Gaming Performance Engineering. L’objectif affiché est de délivrer une augmentation notable du nombre d’images par seconde, pouvant atteindre 60 % dans certains cas. Pour faire simple, cette équipe de gars de Miami propose un outil d’overclocking automatisé permettant aux joueurs d’améliorer les performances de leurs ordinateurs de jeu de manière stable et sans risque d’endommager leur matériel. 
Hypertune

Cependant, il convient de nuancer cette promesse. Bien que le chiffre de 60 % soit impressionnant, il ne s’agit pas d’une norme attendue pour l’ensemble des utilisateurs. La plupart des systèmes ne devraient voir leurs performances s’améliorer que de quelques pourcents. GamesBeat précise que l’outil repose sur le kit de développement logiciel (SDK) de l’Extreme Tuning Utility (XTU) d’Intel. Le projet a été mené en collaboration avec le géant du processeur, qui a mis à disposition des ressources d’ingénierie pour son élaboration.

Un moteur d’optimisation intelligent pour les CPU et GPU

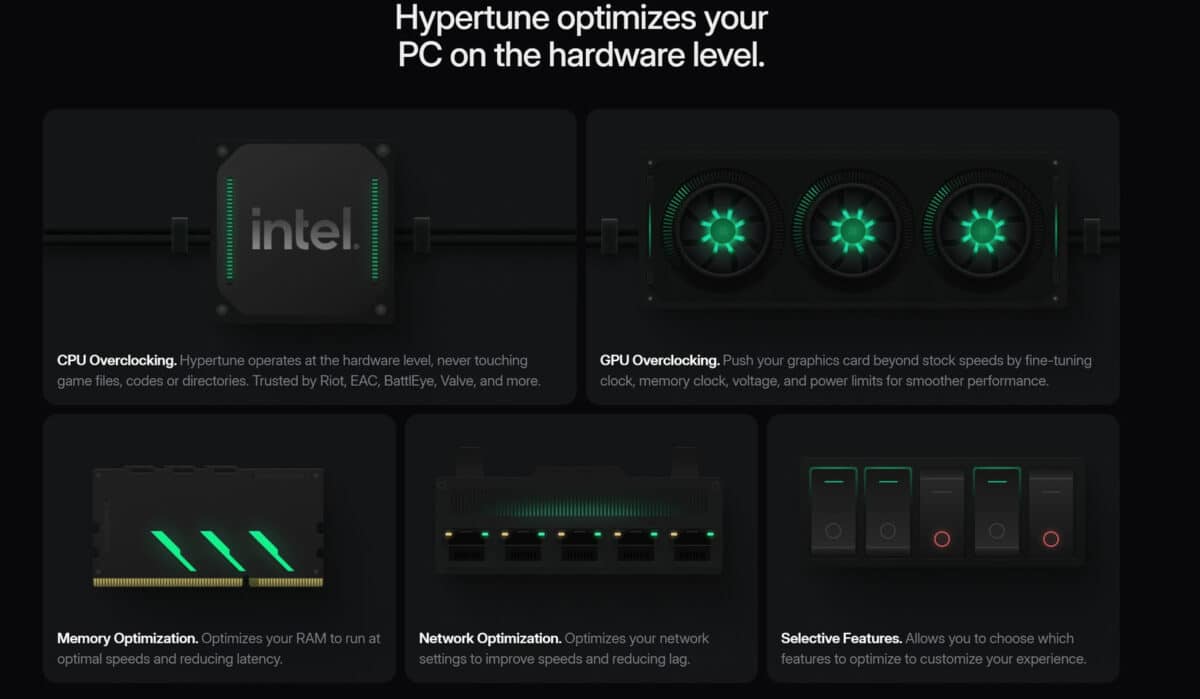
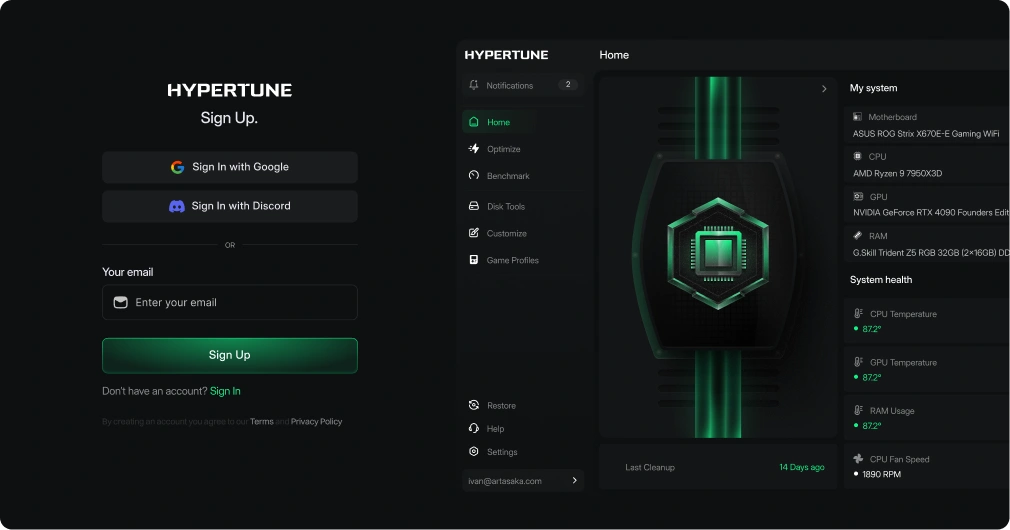
Hypertune intègre des capacités d’overclocking automatique pour le processeur et la carte graphique, tout en optimisant les paramètres de la mémoire vive pour réduire la latence et augmenter la fréquence. Une fois téléchargé, le logiciel analyse la configuration matérielle, les pilotes, les paramètres Windows et divers autres éléments du système. La société désigne cette fonctionnalité sous le nom de Smart Optimization Engine.
Hypertune step1

Ce moteur fonctionne en surveillant et en observant d’abord la configuration du système pour proposer un profil d’optimisation adapté. Après l’application de ce profil, les utilisateurs devraient remarquer des différences immédiates. Lors des démonstrations, deux configurations ont été testées. La première, équipée d’un Intel Core Ultra 9 285K et d’une NVIDIA GeForce RTX 5090, a enregistré des gains de performance allant de 18,9 % à 28,2 %. La seconde configuration, composée d’un Core i7-14700K et d’une RTX 3080, a vu ses FPS augmenter entre 4,3 % et 9,8 %.

Un modèle d’abonnement et une compatibilité large

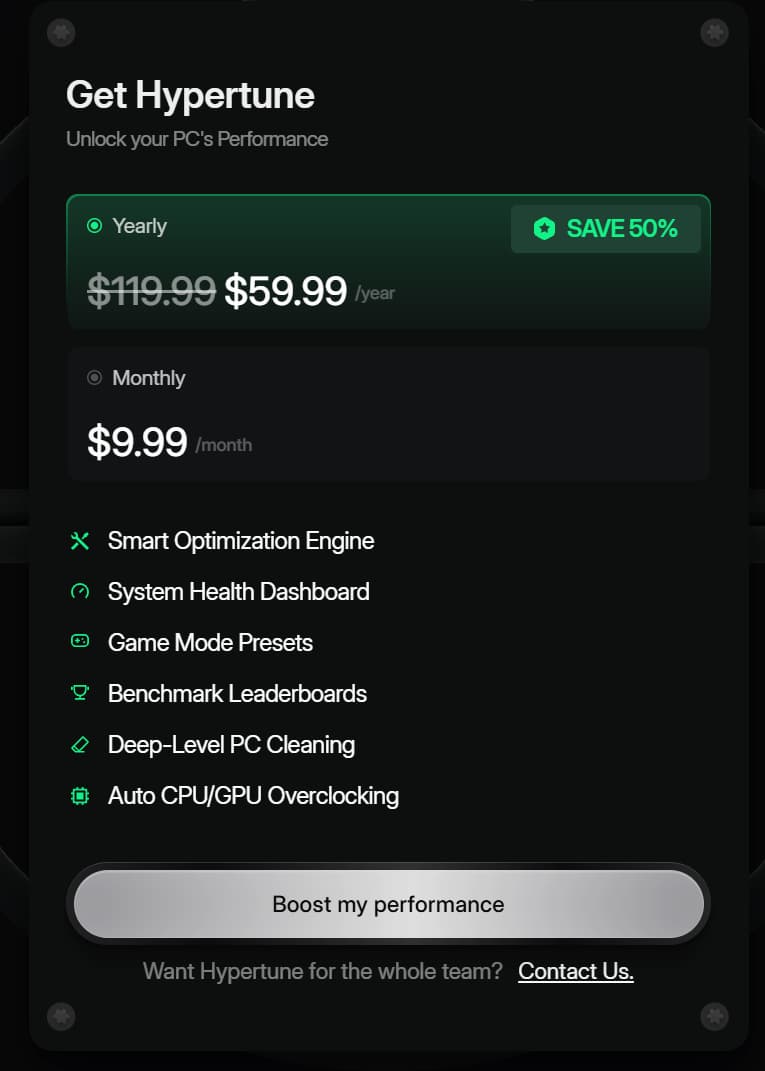
En termes de commercialisation, le logiciel Hypertune sera proposé sous forme d’abonnement mensuel à 9,99 $, ou pour environ 59,99 $ par an. L’offre inclut également des profils de jeu optimisés pour le matériel de l’utilisateur, rendant l’application des paramètres plus simple. L’outil est conçu pour être compatible avec les plateformes de processeurs AMD et Intel, ainsi qu’avec les cartes graphiques des marques AMD, Intel et NVIDIA. Le message est percutant : « L’upgrade le moins cher que vous ayez jamais acheté. »
Hypertune

Il est important de rappeler que ces informations proviennent de rapports et de tests préliminaires. Bien que les résultats soient encourageants, la variabilité des performances selon le matériel suggère que chaque système réagira différemment à l’optimisation proposée par cette nouvelle solution. On va essayer de tester cette histoire prochainement.

GPT-6 Astra : 100 000 GPU Nvidia pour entraîner le modèle, les prix de la RAM s’envolent

La révélation des besoins en calcul derrière le dernier modèle d’OpenAI, baptisé GPT-6 Astra, a mis en lumière l’ampleur industrielle requise pour la prochaine génération d’intelligence artificielle. Jensen Huang, PDG de Nvidia, a confirmé le 6 septembre que l’entraînement de ce modèle mobilise environ 100 000 GPU de la série Grace Blackwell. Il a également annoncé la mise en place de 400 000 unités supplémentaires pour les phases futures. Cette information, publiée avant toute déclaration officielle d’OpenAI, apporte un éclairage direct sur les tensions actuelles sur le marché du matériel informatique grand public.

Il est important de noter que la formulation initiale de Jensen Huang a suscité des interrogations quant à l’unité de mesure. Certains ont interprété ces chiffres comme le nombre de racks de serveurs complets, ce qui aurait impliqué 7,2 millions de GPU. Cependant, Greg Brockman, président d’OpenAI, a clarifié la situation en précisant qu’il s’agissait bien de 100 000 accélérateurs individuels. Cela correspondrait à environ 1 390 racks de type NVL72, une configuration déployée sur le campus d’Abilene au Texas.

Une consommation électrique colossale pour l’infrastructure

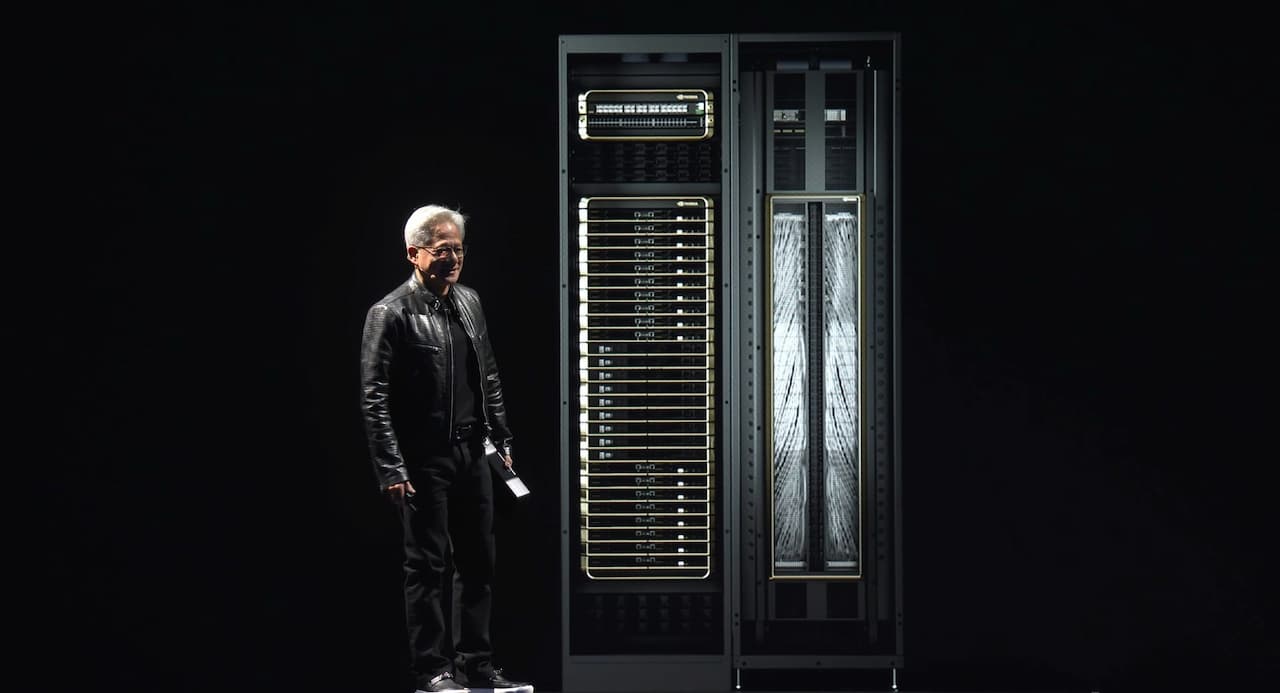
L’impact de cette infrastructure sur le réseau électrique est considérable. Un rack NVL72, composé de 72 GPU Blackwell et de 36 processeurs Grace, consomme environ 135 kW en fonctionnement continu, pouvant atteindre 155 kW en pointe. Pour les 1 390 racks nécessaires, la consommation totale du cluster d’entraînement s’élève à environ 187 mégawatts. Si l’on inclut la phase d’expansion annoncée par Nvidia, la demande énergétique pourrait atteindre près de 750 mégawatts, sans même compter les besoins en refroidissement et en stockage de données.

NVIDIA NVL72 Vera Rubin
Le rack NVL72

Les contraintes physiques et énergétiques sont donc majeures. Un tel rack pèse environ 1 580 kg et dissipe 90 % de sa chaleur vers un système de refroidissement liquide. L’Uptime Institute indique qu’un rack standard dans un centre de données consomme en moyenne 9 kW, ce qui rend la gestion de ces flux thermiques et électriques un défi technique majeur pour les opérateurs comme Oracle, qui avait initialement prévu 400 000 GPU GB200 pour ce site.

La concurrence pour les puces mémoire HBM3E

Le véritable impact sur le consommateur réside dans la chaîne d’approvisionnement de la mémoire. Chaque GPU Blackwell intègre entre 186 et 288 Go de mémoire HBM3E selon la version. Pour un cluster de cette envergure, la demande en mémoire atteint des volumes de plusieurs pétaoctets. Samsung, SK Hynix et Micron produisent cette mémoire HBM3E sur les mêmes lignes de fabrication que les modules DDR5 destinés aux PC grand public.

Ces trois fabricants contrôlent plus de 90 % de la production mondiale de DRAM. Depuis 2025, ils ont réorienté une partie significative de leurs capacités vers la production de HBM pour répondre à la demande des data centers, car les marges bénéficiaires sont plus élevées. Cette réorientation directe des capacités de production explique en grande partie la raréfaction et la hausse des prix observées sur le marché de la mémoire vive pour les ordinateurs personnels.

Les données du marché confirment cette tendance. Au milieu d’août 2026, les prix de la RAM DDR5 et DDR4, ainsi que ceux des SSD, ont atteint des niveaux records par rapport à la période pré-crise. Trendforce prévoit une nouvelle hausse des contrats DRAM de 13 à 18 % pour le troisième trimestre 2026. Les experts estiment qu’un retour à la baisse des prix ne pourrait intervenir avant 2028 au mieux.

Enfin, les performances de GPT-6 Astra montrent une efficacité notable. Sur le benchmark ARC-AGI-3, le modèle surpasse la référence humaine sur 96 % des niveaux. Bien que les termes comme “AGI” soient utilisés avec prudence par OpenAI, les résultats techniques sont tangibles. Nvidia, qui a généré 89 milliards de dollars dans son dernier trimestre grâce à ses divisions data center, utilise cette annonce pour valoriser l’adoption de ses technologies, tandis que les coûts de production continuent de peser sur les composants disponibles pour les particuliers.

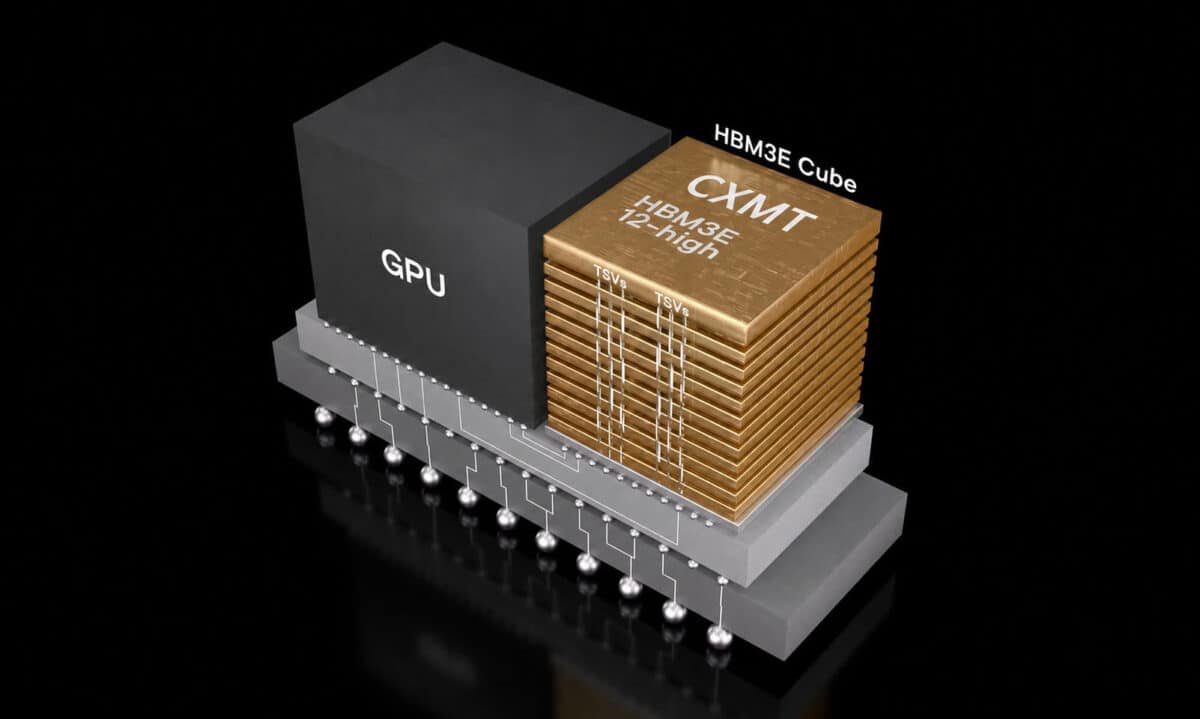
Pour le moment, CXMT peine à maîtriser la production de HBM3E

Le géant chinois de la mémoire CXMT fait face à des défis techniques significatifs dans son effort pour entrer sur le marché des mémoires HBM (haute bande passante). Selon des informations rapportées par la presse sud-coréenne, l’entreprise peine à atteindre des niveaux de production économiquement viables pour sa technologie HBM3E. Cette situation place CXMT dans une position difficile, notamment alors que ses principaux concurrents, Samsung, SK Hynix et Micron, ont déjà commencé à échantillonner la génération suivante, la HBM4E.

CXMT HBM

Les détails techniques récents révèlent que trois empilements de mémoire HBM3E sur quatre produits par CXMT sont défectueux. Cela indique un rendement de fabrication actuel de seulement 25 %. L’empilement de DRAM est une tâche complexe, nécessitant une maîtrise de technologies bien plus pointues que pour la fabrication de DRAM planaire, un domaine où CXMT est réputé exceller. Mais à ce stade, la transition vers l’empilement s’avère être un obstacle majeur.

Une technologie TSV immature pénalise le rendement

Les faibles rendements observés sont attribués à l’immaturité de la technologie de traversée de silicium (TSV) employée par CXMT. Dans le processus de fabrication, la chaîne de production se divise en deux étapes critiques. En amont, la fabrication atteint un rendement d’environ 30 %. Le traitement en aval, qui consiste à assembler les couches, permet d’atteindre un rendement de 70 % par rapport à cette base initiale de 30 %.

La comparaison avec les leaders du marché met en lumière l’écart technologique. Samsung utilise environ 5 000 TSV par couche sur ses puces HBM2, tandis que SK Hynix en utilise plus de 8 000 par couche sur son HBM3. Les données suggèrent que CXMT tente d’atteindre la configuration HBM3E avec seulement 3 000 TSV par couche. De plus, l’entreprise cherche à empiler 8 couches dans la configuration standard de 8-Hi HBM3E. Ces contraintes techniques expliquent pourquoi il est peu probable que CXMT passe à une capacité supérieure de 12-Hi HBM à court terme, tant qu’elle ne résout pas ces défis d’ingénierie.

Perspectives d’amélioration : course de vitesse avec les concurrents

Malgré ces revers, il est trop tôt pour considérer l’effort de CXMT comme un échec. L’histoire récente montre que les rendements dans ce secteur peuvent s’améliorer rapidement. Par exemple, Samsung affichait un rendement d’environ 60 % pour l’HBM4 en février de cette année, pour atteindre environ 80 % seulement six mois plus tard. Il reste donc une marge de progression importante pour CXMT.

Pour la DRAM planaire classique, CXMT atteint déjà un rendement de 90 %, ce qui ne représente qu’un écart de 2 à 3 % par rapport au rendement de Samsung sur son nœud de 10 nm pour la production de DDR5. Cela suggère que des solutions existent pour rattraper le retard, mais que du temps est nécessaire pour affiner le processus. La manipulation des TSV pour empiler la DRAM exige une expertise substantielle, et il faudra encore quelques mois avant que la production en volume puisse véritablement débuter.

Une nouvelle variante de la GeForce RTX 5070 basée sur le GB203 pourrait arriver

La gamme GeForce RTX 50 de NVIDIA continue d’évoluer, et de nouvelles informations circulent concernant la carte milieu de gamme, la RTX 5070. Actuellement commercialisée avec le GPU GB205, cette carte pourrait bientôt profiter d’une nouvelle déclinaison. Selon plusieurs sources, le constructeur envisage d’utiliser la puce GB203 pour cette nouvelle version, une pratique déjà observée sur d’autres modèles de la série Blackwell.

RTX 5070 : un changement de GPU sans changement de specs ?

À l’heure actuelle, la GeForce RTX 5070 est officiellement basée sur le GPU GB205-300. Cette puce mesure 263 mm² et intègre 31,1 milliards de transistors. Elle profite de 6 144 cœurs CUDA, de 12 Go de mémoire GDDR7 sur un bus de 192 bits et d’un TGP de 250 W. Ces caractéristiques sont désormais bien établies pour le modèle en vente.

Cependant, des rapports provenant de fuites, notamment celles attribuées à l’utilisateur hongxing2020, suggèrent que NVIDIA travaille sur une seconde variante de la RTX 5070. Cette nouvelle carte utiliserait le GB203, la même puce que celle utilisée pour la RTX 5070 Ti et la RTX 5080. Le GB203 est une puce significativement plus imposante, avec une surface de 378 mm² et 45,6 milliards de transistors.

Une petite vue éclatée de la RTX 5070 Founders Edition.

Il est important de noter que cette information reste au stade de la rumeur. Aucune annonce officielle n’a été faite par NVIDIA ni par ses partenaires AIB. Les spécifications techniques de cette potentielle variante ne seraient pas supérieures à celles du modèle actuel. Pour atteindre les 6 144 cœurs CUDA et le bus de 192 bits de la RTX 5070, le GB203 devrait voir une grande partie de ses ressources désactivées. Cela impliquerait de “castrer” environ 43 % des cœurs CUDA et de désactiver deux des huit canaux de mémoire disponibles sur la puce complète.

Une stratégie de binning déjà testée

Cette approche n’est pas nouvelle pour le géant du hardware. La génération Blackwell a déjà connu des ajustements similaires. La RTX 5060, initialement prévue avec le GB206, a vu apparaître des versions utilisant le GB205, une puce plus grande, mais bridée pour correspondre aux performances attendues. Des constructeurs comme MSI et Yeston ont déjà lancé des modèles V1 de la RTX 5060 basés sur ce silicium.

L’utilisation du GB203 pour la RTX 5070 suivrait la même logique de gestion de la production. Les puces GB203 qui ne parviennent pas à répondre aux exigences strictes des modèles haut de gamme (RTX 5070 Ti ou RTX 5080) pourraient tout de même fonctionner correctement avec des spécifications réduites. Cela permettrait à NVIDIA de valoriser ces semi-conducteurs plutôt que de les jeter, tout en maintenant les performances actuelles de la RTX 5070.

Un détail intéressant mentionné par les sources est l’arrivée potentielle d’un nouveau pilote NVIDIA le 9 septembre. Bien que le lien direct avec cette variante ne soit pas confirmé, le calendrier semble étonnant. Les détails concernant la conception de la carte et la disponibilité exacte de ce modèle restent inconnus pour le moment. Les partenaires fabricants n’ont pas encore communiqué officiellement sur ce projet.

Jusqu’à l’apparition d’une carte en magasin ou d’une liste officielle de pilotes, il convient de traiter ces informations comme des rumeurs. Néanmoins, la tendance à utiliser des puces plus grandes pour des modèles inférieurs semble s’installer durablement dans la stratégie de NVIDIA pour la série RTX 50.

Xeneon Edge, l’écran secondaire atypique de Corsair est en promo

0

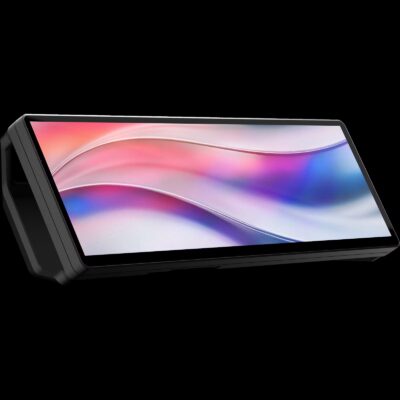
Le Corsair XENEON EDGE est un écran secondaire tactile, pensé comme un véritable tableau de bord pour le PC. Il adopte une dalle tactile AHVA de 14,5 pouces au format très allongé 32:9, avec une définition de 2 560 × 720 pixels et une fréquence de rafraîchissement de 60 Hz. Sa luminosité maximale atteint 350 cd/m², tandis que l’affichage repose sur une profondeur de couleur 8 bits, soit 16,7 millions de couleurs. Il est idéal pour ceux qui veulent afficher un maximum d’infos ou surveiller leur PC mais aussi pour ceux qui veulent une esthétique différente de leur setup. Bonne nouvelle, il est en promotion du 7 au 27 septembre avec un rabais de 19 % !

Le Xeneon Edge disponible en trois couleurs durant la promo

Vous trouverez donc l’écran secondaire de Corsair en noir, blanc ou violet à 209,90 € au lieu de 259,90 € (-19 %). Vous pouvez vous servir directement sur la boutique Corsair :

Ou chez les revendeurs participant à l’opération :

XENEON EDGE

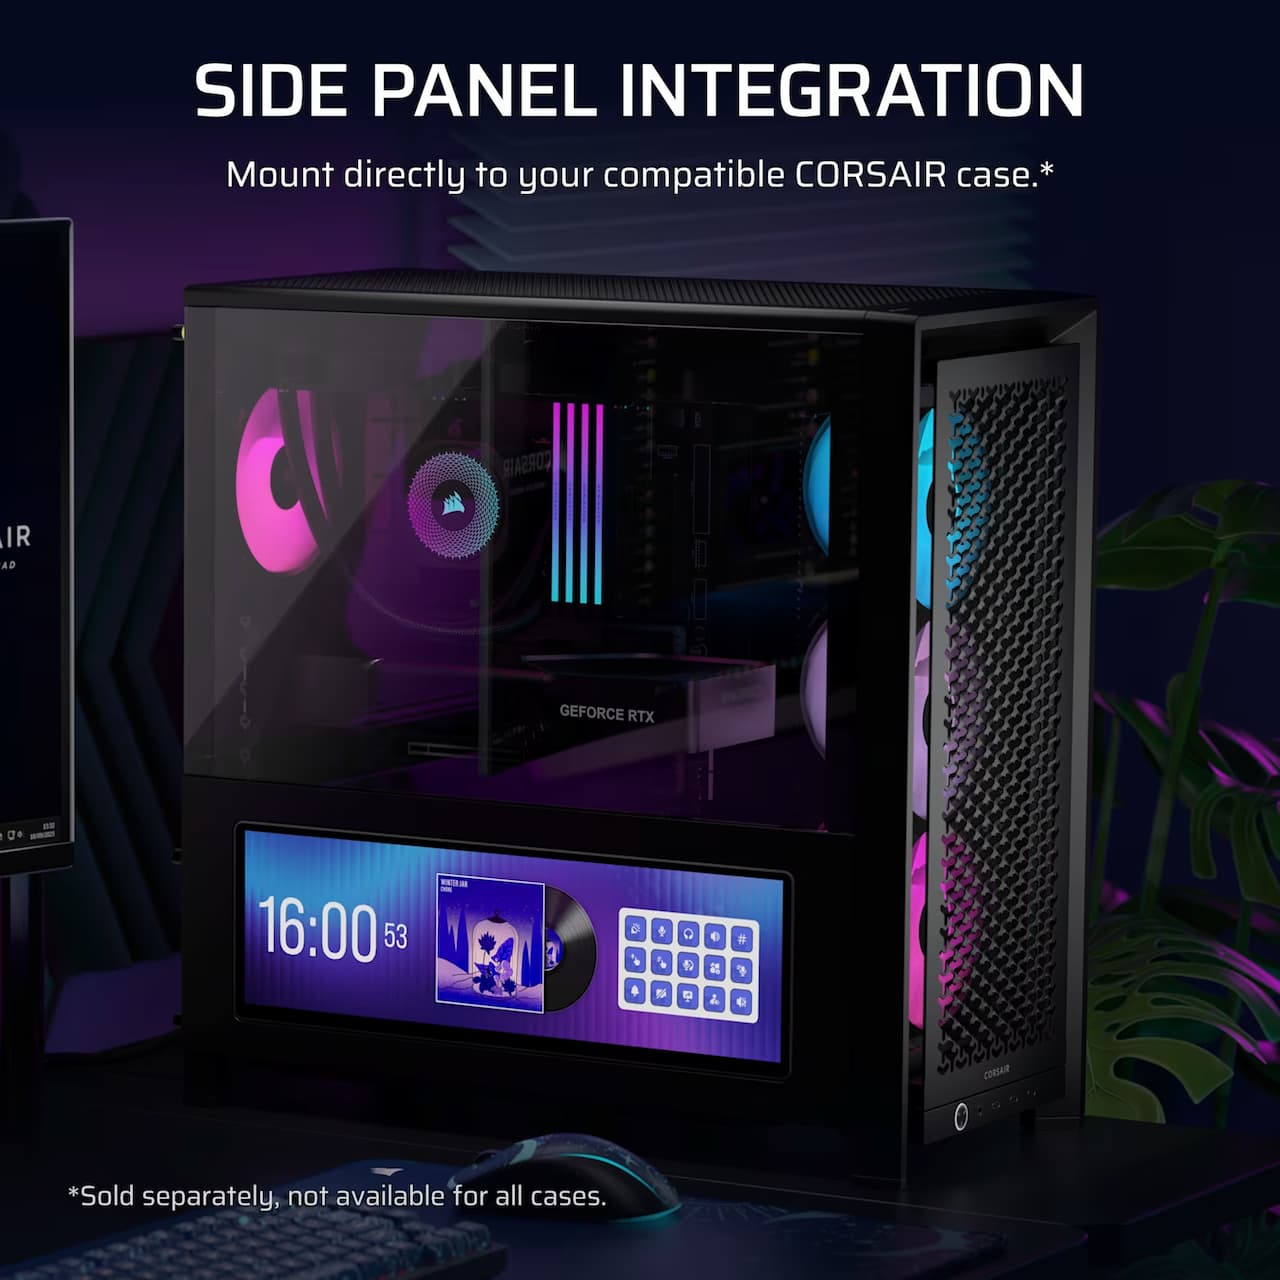
L’intérêt du produit réside surtout dans sa modularité. Il peut être posé sur un bureau avec son support magnétique, fixé sur une surface métallique, installé sur un filetage 1/4-20″, monté sur un support Elgato Multi-Mount ou encore intégré dans un PC à l’emplacement d’un radiateur de 360 mm. Sous Windows 11, le logiciel iCUE transforme alors l’écran en centre de contrôle. Il peut afficher les températures du CPU et du GPU, les fréquences, la vitesse des ventilateurs, des commandes multimédias, Twitch Chat, des raccourcis, des vidéos, des pages web ou encore un Stream Deck virtuel. Jusqu’à 30 pages de widgets peuvent être configurées.

Xeneon Edge
L’intégration du Xeneon Edge dans un PC

Si le XENEON EDGE peut être utilisé comme moniteur, vous l’aurez compris, ce n’est pas sa vocation principale. Le produit de Corsair se situe à mi-chemin entre un écran secondaire, un Stream Deck et une console de monitoring. Cette polyvalence constitue sa principale force pour ceux qui veulent disposer d’un setup original et d’un environnement de travail propre et épuré.

[affilizz-publication id=”vhkn7bn”]

Intel atteint un million de wafers High-NA EUV : la lithographie nouvelle génération s’installe

0

Intel a officiellement franchi une étape historique dans la fabrication de semi-conducteurs. La division Intel Foundry a confirmé avoir traité un million de wafers de 300 mm en utilisant la lithographie à ultraviolets extrêmes (EUV) à ouverture numérique élevée (High-NA). Cette réalisation, annoncée par l’entreprise, valide la maturité industrielle de cette technologie de pointe, longtemps considérée comme le prochain grand saut pour la miniaturisation des puces.

Le déploiement de la High-NA EUV n’a pas été immédiat. Initialement, Intel a installé des systèmes TWINSCAN EXE:5000 d’ASML en 2024, principalement pour la recherche et les tests liés au nœud 14A. Cependant, l’approche d’Intel a évolué. L’entreprise a découvert que ces outils pouvaient être exploités bien au-delà de leur usage initial, étendant leur application au nœud 18A, une gamme qui était auparavant réservée exclusivement aux procédés 14A. Cette flexibilité démontre une maîtrise technique supérieure face aux défis de complexité inhérents à cette nouvelle génération de lithographie.

Une adoption stratégique pour les produits Panther Lake

Concrètement, cette capacité se traduit par des changements dans la production de certains modèles. Pour un sous-ensemble sélectif de références « Panther Lake », Intel procède désormais à la gravure de plusieurs couches de silicium en utilisant l’exposition High-NA, plutôt que de dépendre uniquement de la technologie Low-NA. Cette méthode permet de simplifier considérablement le processus de fabrication.

Les bénéfices sont tangibles sur le plan opérationnel. Intel a rapporté avoir traité plus de 30 000 wafers en un seul trimestre grâce à cette optimisation. En réduisant le nombre d’étapes nécessaires pour une couche spécifique de plus de 40 à moins de 10, les temps de cycle de production sont nettement accélérés. De plus, cette infrastructure n’est pas réservée à l’usage interne ; Intel met désormais cette configuration à disposition de clients externes, reconnaissant le potentiel de valeur que représente cette technologie pour l’industrie.

Un avantage concurrentiel significatif

À l’heure actuelle, Intel demeure le seul acteur industriel à fabriquer activement du silicium en utilisant la lithographie EUV High-NA. Cette situation contraste avec les stratégies de ses principaux concurrents. TSMC affirme pouvoir maintenir son avantage concurrentiel en continuant à utiliser la technologie EUV Low-NA existante, en l’améliorant et en réduisant les nœuds de génération en génération.

De son côté, Samsung Foundry reporte l’introduction de la High-NA EUV jusqu’en 2030 pour son nœud 1 nm. Cela signifie que l’industrie entière ne basculera pas vers cette nouvelle norme dans les années à venir. Le coût est également un facteur déterminant : les outils Low-NA coûtent environ la moitié du prix des systèmes High-NA de premier plan. La machine la plus avancée d’ASML, le TWINSCAN EXE:5200B (prévoyez un grand garage pour la stocker et changez de forfait EDF pour l’alimenter) utilisé pour les tests d’acceptation du nœud 14A, représente un investissement colossal d’environ 400 millions de dollars. Malgré ces défis financiers et techniques, l’atteinte du million de wafers confirme que la voie est ouverte pour une production de masse.

Samsung et ASML étendent leur partenariat pour la lithographie High NA EUV

0

Samsung Electronics et ASML ont officiellement annoncé l’extension de leur partenariat stratégique de longue date. Cette alliance renforcée vise à approfondir la collaboration sur la lithographie EUV à haute ouverture numérique (High NA EUV) ainsi que sur les technologies avancées de fabrication de semi-conducteurs. L’objectif commun est de soutenir l’innovation de la prochaine génération, indispensable pour répondre aux exigences croissantes en matière de performances et d’efficacité à l’ère de l’intelligence artificielle.

Ce nouveau pas dans la coopération s’inscrit dans la continuité d’une décennie de succès partagés. Les deux géants industriels s’engagent désormais à accélérer conjointement le développement et le déploiement des technologies nécessaires. Cette approche vise à répondre aux exigences toujours plus strictes de l’industrie moderne, qui cherche à améliorer la productivité des usines de fabrication tout en maîtrisant les coûts de production des puces les plus complexes.

La transition vers les masques de 12 pouces

Un élément central de cette annonce concerne l’adoption de la technologie des masques de 12 pouces. L’industrie des semi-conducteurs s’est longtemps appuyée sur le format de 6 pouces, mais la transition vers des masques plus grands est désormais attendue. Avec l’introduction de la lithographie High NA EUV, ce changement de format devrait permettre d’augmenter significativement la productivité des usines de fabrication (fabs).

Passer à des masques de 12 pouces offre également l’avantage de réduire les coûts de fabrication des puces et d’éliminer les contraintes de stitching (lorsqu’un élément est plus gros que ce que la machine peut produire, la puce est gravée en plusieurs parties en s’assurant que les raccords soient faits correctement) qui limitaient auparavant les performances. Cette évolution permettra aux fabricants de puces de tirer pleinement parti des avantages offerts par la lithographie High NA EUV, rendant ainsi les générations futures de puces de pointe plus rentables. Samsung, fort de son leadership en mémoire et en fonderie, jouera un rôle essentiel dans cette transition en développant les technologies de masques et les infrastructures de soutien nécessaires.

Intégration de la High NA EUV dans la production de DRAM

Une autre avancée majeure réside dans l’intention de Samsung d’introduire la lithographie High NA EUV d’ASML dans la production de masse future de la mémoire DRAM. Il s’agit d’une première dans l’industrie, prévue pour être opérationnelle d’ici à 2028. Cette décision démontre la maturité de la technologie High NA pour soutenir à la fois les applications mémoire et les applications logiques avancées.

En intégrant cette technologie, Samsung espère étendre la feuille de route de mise à l’échelle (scaling) de la DRAM. L’amélioration de la résolution offerte par la High NA EUV permettra de simplifier les procédés de fabrication et d’augmenter l’efficacité globale. Young Hyun Jun, dirigeant de Samsung, a souligné que l’ère de l’IA transforme l’industrie et que des partenariats solides sont essentiels pour maintenir le leadership technologique.

De son côté, Christophe Fouquet d’ASML a rappelé que Samsung est l’un de ses partenaires d’innovation les plus importants. Les deux entreprises s’engagent à explorer en permanence de nouvelles possibilités de collaboration, notamment dans les domaines de la mémoire avancée et des approches de fabrication innovantes, pour préparer le terrain à la prochaine vague d’innovation dans les semi-conducteurs.

Et DeepCool lance son AN600 VC, un ventirad top-flow avec chambre à vapeur

DeepCool nous propose une nouvelle référence de dissipateur à destination des PC SFF (Small Form Factor). Afin de maximiser ses performances, la marque adopte une chambre à vapeur au niveau de la base de son AN600 VC (vu sur son stand au Computex). Grâce à cette dernière, le dissipateur peut refroidir efficacement des processeurs dont le TDP atteint 220 W ! Un produit qui se retrouvera en concurrence directe avec l’AXP120-x77 de Thermalright avec un avantage en matière de hauteur.

AN600 VC : 67 mm de hauteur et une chambre à vapeur !

Compact et performant ? 

DeepCoon AN600 VC

Avec ce dissipateur, DeepCool nous propose une nouvelle référence de ventirad compact. Ce dernier mesure 122 (L) × 120 (P) mm, avec une hauteur limitée à seulement 67 mm, soit 1 cm de moins que le dernier modèle de chez Thermalright. Par ailleurs, le dissipateur de DeepCool se distingue par la présence d’une chambre à vapeur au niveau de sa base, de quoi capter plus efficacement la chaleur émise par le CPU.

Toujours en lien avec le radiateur, nous retrouvons un fin empilement d’ailettes en aluminium, traversé par un total de six caloducs en cuivre de 6 mm chacun et en forme de « C ». Cet ensemble permettra d’ailleurs l’installation de RAM mesurant jusqu’à 40 mm de hauteur.

Du côté de la ventilation, nous retrouvons un unique ventilateur slim de 15 mm d’épaisseur seulement. Ce dernier fonctionnera de 500 à 1 850 tr/min tout en générant un flux d’air de 61,56 CFM et une pression statique de 1,97 mmAq. Ce ventilateur dispose d’ailleurs de neuf pales plutôt fines avec une faible courbure tandis que le moyeu central dispose d’une fenêtre transparente afin de voir l’axe et les pôles du moteur.

DeepCoon AN600 VC

Prix : 299 yuans !

[affilizz-publication id=”8485quf”]

La facture atteindra 299 yuans en Chine, ce qui nous donne 38 € et des poussières après conversion. Encore une fois, attendez-vous à un prix nettement supérieur en Europe à cause des différentes taxes et frais liés à l’importation. Par exemple, l’actuel AN600 de DeepCool se retrouve à un peu moins de 50 € chez PC Componentes.

DLSS Multi Frame Gen débloqué sur RTX 30 : les modders contournent la restriction officielle

La technologie de génération d’images de NVIDIA, connue sous le nom de DLSS Multi Frame Generation (MFG), reste officiellement réservée aux cartes graphiques de la série RTX 50 Blackwell. Cependant, vous aurez remarqué que, depuis quelque temps, une communauté de modders est particulièrement active sur ces sujets. Récemment, ils ont réussi à contourner cette limitation matérielle, rendant cette fonctionnalité accessible aux possesseurs de cartes GeForce RTX 30. Cette prouesse, rapportée par plusieurs observateurs du secteur, marque un tournant intéressant pour l’écosystème des cartes graphiques plus anciennes.

NVIDIA keeps DLSS Multi Frame Gen locked to RTX 50, modders just got it working on RTX 30 with DLSS5 included
                                Cyberpunk 2077 sur RTX 3080 avec DLSS 5 et DLSS MFG ???

Un nouveau projet open-source pour les cartes Ampere (RTX 30)

Le projet, baptisé DLSSG SM86, a été conçu par un développeur indépendant afin d’adapter le runtime officiel de la génération d’images de NVIDIA pour les architectures Ampere. Il ne s’agit pas d’une simple substitution par une technologie concurrente comme FSR, mais bien de l’utilisation native du pipeline DLSS. Le mod installe un proxy à côté de l’exécutable du jeu pour rediriger les requêtes vers un runtime DLSSG 310.1 inclus. Cette méthode permet de fournir un backend compatible SM86 aux cartes RTX 30, en utilisant soit des noyaux cubin précompilés, soit du code PTX compilé par le pilote NVIDIA.

RTX 3080 Ti Gaming OC
Une bonne vieille RTX 3080 Ti Gaming OC…

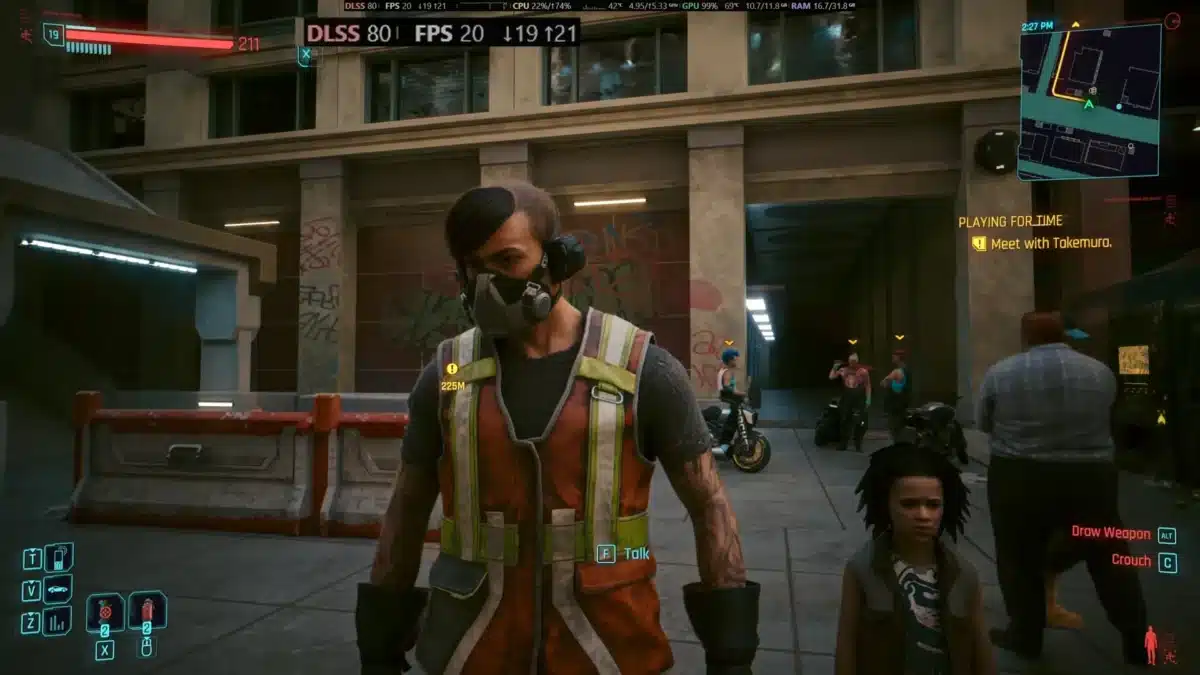
Les tests réalisés sur une RTX 3080 Ti ont confirmé la faisabilité du système en modes 2X et 4X. Une vidéo de démonstration publiée par un utilisateur possédant une RTX 3080 12 Go montre le fonctionnement dans Cyberpunk 2077. Le mod modifie également la capacité indiquée au jeu, permettant d’atteindre jusqu’à 4X Multi Frame Generation via le paramètre MaxGeneratedFrames=3. Il est important de noter que c’est le jeu lui-même qui contrôle le nombre d’images à générer.

DLSS 5 sur RTX 30 ? Performances et limitations techniques

Les performances observées dans les démos sont encourageantes, bien qu’elles ne garantissent pas une expérience fluide à 80 images par seconde dans tous les scénarios. Dans Black Myth: Wukong, les chiffres varient entre 50 et 150 FPS selon que la génération d’images est désactivée ou activée en modes 2X et 4X. Pour Cyberpunk 2077 avec le path tracing, les performances passent d’environ 35 FPS à 100 FPS. Le développeur recommande vivement d’utiliser cette solution uniquement dans les jeux hors ligne, car elle pourrait être détectée par les systèmes anti-triche.

Il est crucial de comprendre que cette solution reste un contournement technique. Bien que le DLSS 4 ait supprimé la dépendance au flux optique matériel, permettant ainsi l’adaptation du pipeline à Ampere, les cartes RTX 30 ne possèdent ni les cœurs Tensor de cinquième génération ni le Flip Metering matériel présents sur Blackwell. Par conséquent, elles ne peuvent pas égaler la latence, l’efficacité ou le comportement de présentation des cartes RTX 50. Néanmoins, le fait que le DLSS 5 fonctionne correctement dans ces configurations démontre une flexibilité technique inattendue.

Cette réussite soulève des questions sur la stratégie de NVIDIA concernant le verrouillage de cette technologie. Si des solutions tierces comme celles d’AMD ou de Lossless Scaling fonctionnent déjà sur ces cartes, pourquoi maintenir une restriction aussi stricte ? Le développement de DLSSG SM86 prouve que la technologie est viable sur l’architecture Ampere, même si elle n’offre pas les mêmes garanties de performance que sur les nouvelles générations.

Marvel’s Wolverine : sur PS5 uniquement…Malheureusement

0

Le long périple menant au lancement de Marvel’s Wolverine touche enfin à sa fin. Après avoir excellé à la tête de plusieurs titres centrés sur Spider-Man, Insomniac Games a désormais concentré tous ses efforts sur le mutant emblématique. Les détails concernant l’heure exacte à laquelle les joueurs pourront plonger dans l’aventure sont enfin connus. Selon les informations recueillies, la sortie est confirmée pour le 15 septembre, exclusivement sur PlayStation 5.

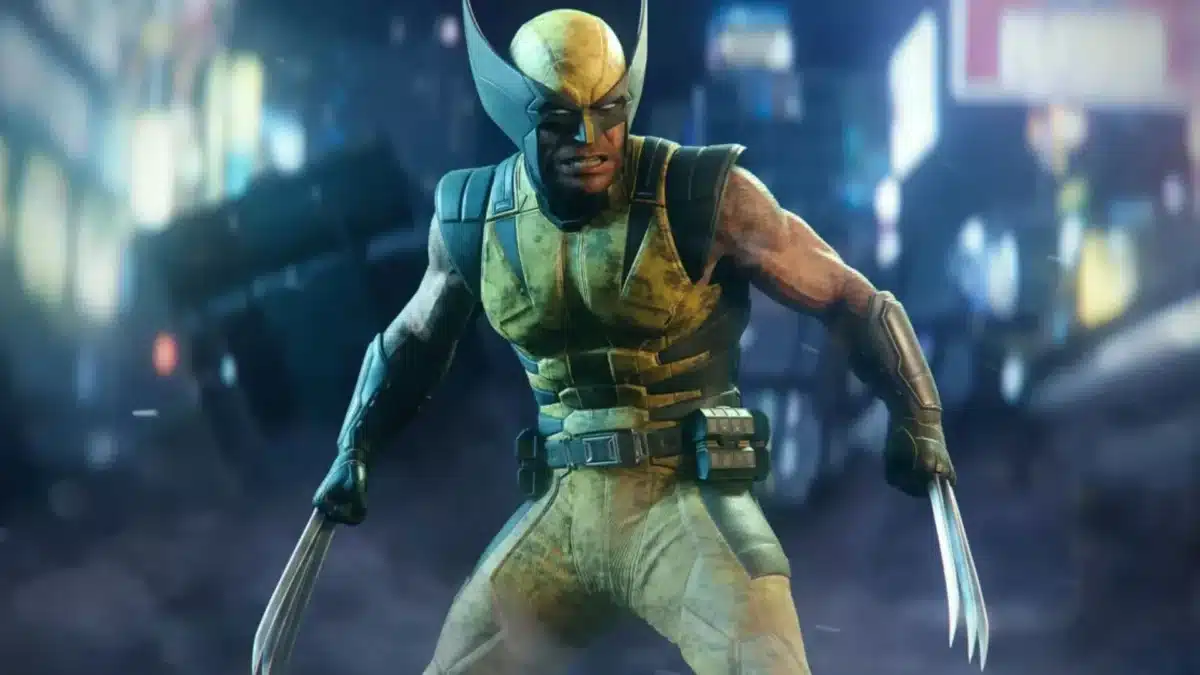
wolverine with claws in ps5

Il est important de noter que le studio ne propose aucun accès anticipé lié aux précommandes. Les portes s’ouvriront donc pour tous les joueurs au même moment, qu’ils aient acheté l’édition standard ou une version étendue. Il s’agit d’un titre en solo, ce qui signifie que les serveurs ne seront pas soumis à une surcharge massive au lancement. Toutefois, il reste vivement recommandé d’installer le jeu à l’avance pour éviter tout délai d’accès au moment du lancement.

Horaires de lancement et fuseaux horaires

Marvel’s Wolverine bénéficiera d’un lancement mondial décalé, avec une disponibilité à minuit heure locale le 15 septembre. Cela implique que les joueurs situés en Nouvelle-Zélande et en Australie seront théoriquement les premiers à pouvoir accéder au jeu. À l’inverse, ceux basés aux États-Unis devront patienter un peu plus longtemps selon leur région.

Les principaux éléments à retenir sur le sujet

Des exceptions existent toutefois pour le marché américain. Le titre y est prévu pour minuit, heure de l’Est (Eastern Time), le 15 septembre. Pour les résidents des régions centrales ou du Pacifique aux États-Unis, cela correspond en réalité à la fin de la soirée du 14 septembre. Les horaires de sortie de Marvel’s Wolverine dans les principales régions du monde sont les suivants :

Les joueurs situés dans les fuseaux horaires du Pacifique (PT) verront le jeu disponible à 21 h le 14 septembre. En Amérique du Sud, à Brasilia (BRT), ainsi qu’en Europe (BST, CEST), en Chine (CST), en Corée (KST) et au Japon (JST), l’accès se fera à minuit le 15 septembre. De même, les joueurs en Australie (AET) et en Nouvelle-Zélande (NZST) pourront commencer leur partie à minuit le 15 septembre.

Insomniac Games a confirmé cette stratégie de sortie pour assurer une expérience cohérente à l’échelle mondiale, tout en respectant les contraintes logistiques liées aux fuseaux horaires. Les fans peuvent désormais préparer leur console pour ce lancement exclusif sur la plateforme PlayStation 5. La sortie officielle marque une nouvelle étape importante pour le studio, qui continue de développer des titres majeurs dans l’univers des super-héros.