

À Hot Chips 2026, NVIDIA était sur scène pour détailler le GPU Rubin, son prochain accélérateur de centre de données dans la plateforme Vera Rubin. L’IA agentique est le thème récurrent et l’entreprise affirme qu’elle modifie non seulement les cœurs tensoriels, mais l’ensemble de la pile de calcul, de réseau, d’alimentation et de maintenabilité qui l’entoure. Bien que nous connaissions déjà beaucoup de détails sur Vera, la présentation de Rubin apporte des spécifications concrètes pour ce nouveau standard.

Une architecture de 100 MW pour l’IA agentique
NVIDIA qualifie l’IA agentique de charge de travail la plus complexe jamais ciblée. Elle relie l’observation, le raisonnement et l’action au moyen de LLM, de CPU, de DPU, de l’orchestration, de la sécurité, de la mémoire et du réseau. Cette ampleur justifie une refonte complète de la plateforme, bien au-delà du seul silicium.
Vera Rubin est présentée comme une usine d’IA complète s’étendant sur sept puces et cinq racks. L’architecture intègre le CPU Vera, le GPU Rubin, le BlueField-4, le Spectrum-6 et même des LPU Groq, avec une prise en charge du stockage, du réseau et des appels d’outils.
Les benchmarks traditionnels ne suffisent plus pour l’inférence agentique. Les séquences d’entrée peuvent atteindre 400 000 tokens, ce qui sollicite les systèmes conçus pour des prompts courts. Selon une étude de SemiAnalysis utilisant DeepSeek-v4-PRO, le rack Rubin NVL72 dépasse le GB300 NVL72, offrant jusqu’à 30 fois plus de tokens par mégawatt lorsque l’interactivité augmente.
Spécifications techniques et efficacité énergétique
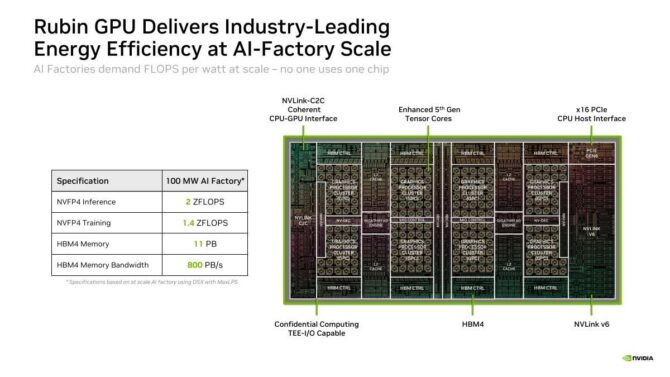
Le GPU Rubin est évalué à 2 ZFLOPS pour l’inférence NVFP4 et 1,4 ZFLOPS pour l’entraînement, avec 11 PB de mémoire HBM4 et 800 PB/s de bande passante au sein d’un rack de 100 MW. La conception repose sur NVLink 6, NVLink-C2C et une interface PCIe x16 de cinquième génération. Pour l’entraînement sur un rack NVL72, NVIDIA rapporte une réduction de 13 % de la puissance de pointe et une conformité réseau améliorée, permettant jusqu’à 40 % de GPU supplémentaires par watt provisionné.

La gestion de la puissance inclut un lissage qui réduit les pics au démarrage et à l’arrêt, optimisant ainsi l’utilisation des GPU sous une limite de puissance donnée. Le système utilise un refroidissement liquide à 45 °C avec une alimentation 800 VDC, éliminant le besoin de refroidisseurs dans de nombreux cas. Cette approche permet de diriger plus de budget électrique vers le traitement des tokens plutôt que vers le rejet de chaleur.

La fiabilité est renforcée par le deuxième moteur RAS (RASIST), qui effectue des vérifications de l’état du système sans interruption de la charge de travail, contrairement aux générations précédentes nécessitant des arrêts prolongés. Le rack NVL72 se distingue également par l’absence de câbles et de ventilateurs dans le tiroir de calcul, simplifiant la construction et la maintenance à l’échelle du centre de données.
