DERNIERS ARTICLES

Réduction des approvisionnements de GPU AMD en Chine ?

Toujours en lien avec la Chine, nous apprenons qu’AMD réduirait (notez le conditionnel) ses approvisionnements en cartes graphiques gaming dans l’Empire du Milieu. C’est sur ChannelGate que la rumeur circulait initialement avant d’être reprise par d’autres confrères. Évidemment, aucune annonce officielle de la part des rouges, nous restons donc dans la pure rumeur spéculative.

Des approvisionnements en GPU RADEON réduits chez AMD en Chine !

Un approvisionnement réduit de 20 à 50 % !

AMD RX 9000 MSRP Si cette nouvelle rumeur rapportée sur ChannelGate se révèle vraie, les prix des cartes graphiques AMD en Chine pourraient être tirés vers le haut par deux phénomènes :
  • La pénurie de mémoire qui rend les cartes plus chères à produire
  • Le déséquilibre qui va continuer de se creuser entre l’offre et la demande
Dans tous les cas, le consommateur chinois n’est pas près de payer son matériel moins cher. Par ailleurs, cette baisse des approvisionnements pourrait n’être que temporaire. Effectivement, il est évoqué que ce phénomène pourrait durer jusqu’en janvier 2027.

Mais on n’en sait pas plus :

Malheureusement, nous n’en savons pas plus sur cette baisse des approvisionnements… On sait seulement que moins de GPU arriveraient entre les mains des partenaires de la marque. Dès lors, nous ne savons pas si certains modèles seront plus touchés que d’autres. Dans ce contexte de pénurie de mémoire, les rouges pourraient réduire davantage l’approvisionnement de cartes en 16 Go comme les RX 9070 et RX 9070 XT. De plus, il est précisé que cette baisse concerne avant tout la Chine et que des observations différentes peuvent être faites dans d’autres régions du monde comme l’Europe, l’Amérique, etc. Enfin, il n’est pas à exclure que les rouges priorisent temporairement la production de GPU pour l’IA au détriment des cartes grand public suite à un quelconque pic de demande dans ces secteurs. Bref, un phénomène à surveiller pour en mesurer les conséquences éventuelles.

Panique en Chine, les entreprises d’IA se ruent sur les GPU NVIDIA

Les récents événements entourant Jensen Huang ont fait des remous en Chine où il est rapporté que les entreprises de la tech et de l’IA se ruent sur les cartes NVIDIA. Effectivement, les récents événements pourraient pousser le gouvernement américain à resserrer la vis autour des exportations de cartes graphiques du caméléon plus tôt que prévu. Les entreprises se tourneraient vers les centres de données d’Asie du Sud-Est pour s’approvisionner en cartes !

Les entreprises chinoises cherchent à sécuriser des cartes NVIDIA rapidement !

Le gouvernement américain pourrait resserrer la vis autour des exportations de cartes NVIDIA !

NVIDIA Chine Évidemment, la Chine continue d’avoir accès à du matériel de pointe de NVIDIA par des moyens légaux et d’autres qui restent plus… flous. En effet, si l’exportation de matériel atteignant un certain seuil de performance est illégale, les entreprises chinoises peuvent toujours avoir accès à ce type de matériel en se tournant vers des plateformes cloud. Cependant, cette voie, déjà dans le collimateur des autorités américaines, pourrait se refermer plus rapidement que prévu à la suite des révélations entourant l’ancien PDG de NVIDIA, Jensen Huang. Dans ce contexte, il est rapporté que les entreprises de la tech chinoise contacteraient des centres de données d’Asie du Sud-Est pour s’approvisionner en cartes NVIDIA. On pense à la Malaisie qui n’est pas sanctionnée par les Américains. D’ailleurs, c’est par ce biais que du matériel sous sanctions arrivait en Chine, notamment via le financement de Speedmatrix par Apex Enterprise Solution (une filiale singapourienne d’Alibaba), une entité malaisienne de MegaSpeed à laquelle Alice Huang était liée. Le but étant de faire rentrer un maximum de marchandise avant de devoir passer par des moyens plus complexes pour continuer de s’approvisionner en cartes. On peut aussi s’attendre à ce que les autorités américaines redoublent de vigilance pour limiter les exportations frauduleuses via le marché noir par exemple. Bref, l’importation de matériel sous sanctions américaines s’annonce plus compliquée pour les entreprises chinoises. Il n’est pas impossible que ces dernières doivent davantage recourir à des puces Huawei.

RADEON Software 26.11.1 : correction des écritures SSD !

Du côté d’AMD, nous retrouvons la publication du pilote graphique en version 26.11.1, une version visant principalement à corriger le bug d’écriture des SSD causé par le processus atieclxx.exe. Pour rappel, ce dernier pouvait générer des écritures en permanence sur le disque. C’est un problème qui inquiète les propriétaires de SSD principalement à cause de la réduction de leur durée de vie, surtout à une époque où les coûts liés à la mémoire ont flambé !

RADEON Software 26.11.1 : les écritures SSD sont corrigées !

Les correctifs :  

AMD bug d'écriture Malheureusement, il n’y aura pas grand-chose à se mettre sous la dent avec cette version puisque l’entreprise ne propose que deux correctifs avec cette nouvelle version. Effectivement, nous retrouvons la correction de :
  • Écritures excessives sur le disque système qui peuvent être observées lorsque le système est en idle avec une RX 7000 ou plus récente.
  • Écritures excessives sur le disque système qui peuvent être observées lors du déplacement ou du redimensionnement des fenêtres d’application.
Et c’est tout, le pilote n’apporte pas de prise en charge d’un nouveau jeu, de nouveaux gains de performance ni de nouvelle fonctionnalité. Dans le doute, c’est une version que nous vous conseillons d’installer pour éviter tout problème sur votre stockage.

Petit rappel du bug : 

Dans les grandes lignes, le bug en question était lié à atieclxx.exe qui se copiait lui-même en boucle dans un répertoire spécifique de Windows. Bien que plutôt léger (660 ko), l’exécutable, à force de tourner, pouvait générer jusqu’à 56 Go d’écritures par jour à un débit compris entre 0,3 et 5 Mo/s en continu. Rappelons qu’un correctif non officiel avait été publié par un modder et que ce dernier interdisait au système de supprimer l’exécutable afin de casser la boucle d’écriture infinie. Enfin, un mécanisme analysait le système pour couper le correctif avec la nouvelle version du pilote d’AMD.

Par ici le pilote AMD (1,7 Go)


Alice Huang : comment une relation « personnelle » a facilité l’import de 7,5 milliards de dollars de puces Nvidia

Alors que l’actualité autour du boss de Nvidia s’est accélérée ces dernières heures, il n’est pas inutile de faire une petite synthèse des informations qui sont tombées.

Alice Huang : le scandale qui a fait tomber Jensen 

Une enquête approfondie menée par The Information met en lumière le rôle central d’Alice Huang dans l’importation massive de GPU vers la Chine. Son implication aurait été déterminante pour sécuriser des importations de puces IA Nvidia d’une valeur totale dépassant 7,5 milliards de dollars sur une période de trois ans. Les faits rapportés suggèrent que cette activité s’est déroulée dans le cadre d’une relation personnelle « complexe » avec Jensen Huang. Nous savons maintenant que c’est cette histoire qui a précipité la chute du dirigeant de Nvidia.
Les détails divulgués indiquent que les actions d’Alice Huang ont contribué à faire transiter environ 240 000 puces interdites vers le territoire chinois. Le matériel concerné se compose principalement de systèmes H100 et H200, des composants haut de gamme destinés à l’intelligence artificielle. Cette opération s’inscrit dans un réseau d’entreprises interconnectées, incluant Shanghai Century Litong et la firme singapourienne Megaspeed, déjà soupçonnée de trafic de matériel électronique.

Un réseau d’entreprises et de relations personnelles

Les sources citées dans le rapport établissent des liens entre ces entités commerciales et Alice Huang via des registres d’entreprise et des connaissances personnelles. Il est rapporté que certaines puces achetées par Megaspeed ont fini par atteindre les centres de données de Shanghai Century Litong. Au-delà de ces connexions dans les entreprises, c’est la relation personnelle avec le PDG de Nvidia qui aurait facilité l’accès à des stocks de matériel difficilement disponibles ailleurs.

Des proches de Mme Huang ont affirmé qu’elle vantait régulièrement son accès privilégié au dirigeant de Nvidia. Elle aurait partagé des photos avec Jensen Huang sur son compte WeChat pour renforcer sa crédibilité auprès des clients. Selon les témoignages, elle aurait également célébré ses anniversaires avec le PDG et était une figure familière lors des événements annuels destinés aux partenaires locaux de Nvidia en Chine.
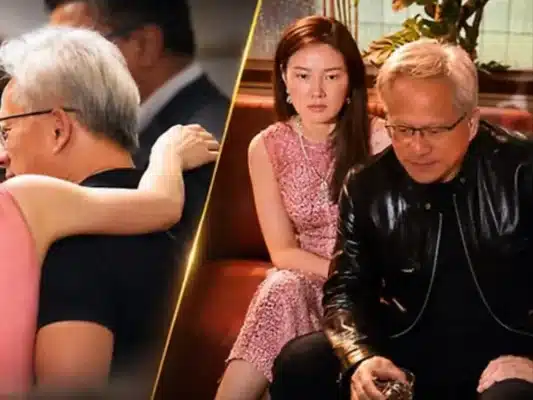
En cas de retard ou de difficulté dans les livraisons, Alice Huang serait même intervenue personnellement pour relancer la logistique et mettre la pression sur les prestataires. Elle invoquait souvent sa proximité avec Nvidia et ses fournisseurs, vantant sa capacité à obtenir des puces. Les estimations indiquent que 4,6 milliards de dollars de puces IA ont transité par Megaspeed entre 2023 et 2025, tandis qu’un autre milliard a été acheminé via Speedmatrix, une filiale de Megaspeed.

Shanghai Century Litong, fondée en juin 2023, a obtenu le statut de partenaire cloud privilégié de Nvidia en octobre de la même année. Ce statut, réservé aux entreprises démontrant une capacité suffisante à gérer le matériel Nvidia, a offert un accès prioritaire aux stocks limités de puces A800 et H800, interdites de vente à la Chine à cette période. Bien que la vente de ces composants ait été bloquée, les stocks existants chez les distributeurs ont pu être redistribués.

Par ailleurs, Megaspeed a été vendue à l’entité singapourienne Swiftdata peu après son pivot en 2023. La firme a ensuite créé Speedmatrix, qui dispose de bureaux en Malaisie. Le Bureau of Industry and Security (BIS) a inspecté les centres de données de Speedmatrix et a constaté que le matériel Nvidia y était encore dans ses emballages, ce qui a déclenché une enquête plus poussée. Il est rapporté que Nvidia serait intervenu dans cette procédure, permettant à l’entreprise de conserver son statut de partenaire.

Le cas « Alice Huang » a déclenché d’autres secousses chez Nvidia

Malgré sa proximité publique avec le PDG de Nvidia, Alice Huang reste discrète sur ses informations personnelles. Deux sources ont indiqué qu’elle reste vague sur ses activités et fait preuve d’une extrême discrétion ces dernières heures. Le gouvernement chinois, via son ambassade, nie tout lien avec elle, tandis que le FBI mène une enquête sur la situation. L’affaire soulève des questions sur l’impact des relations personnelles sur les contrôles d’exportation internationaux. Mais on sait aussi que les services de renseignement américains ont diffusé au printemps dernier une note affirmant qu’Alice Huang était un agent du ministère chinois de la Sécurité d’État.

Mais il y a aussi une autre histoire, dont on ne connaît pas encore l’importance. Une autre relation du PDG de Nvidia, cette fois-ci avec une employée de son entreprise. On parle de la vice-présidente de Nvidia chargée de la division santé, Kimberly Powell, qui est sous son autorité directe. Une situation différente mais pas moins délicate au regard de la législation US. 
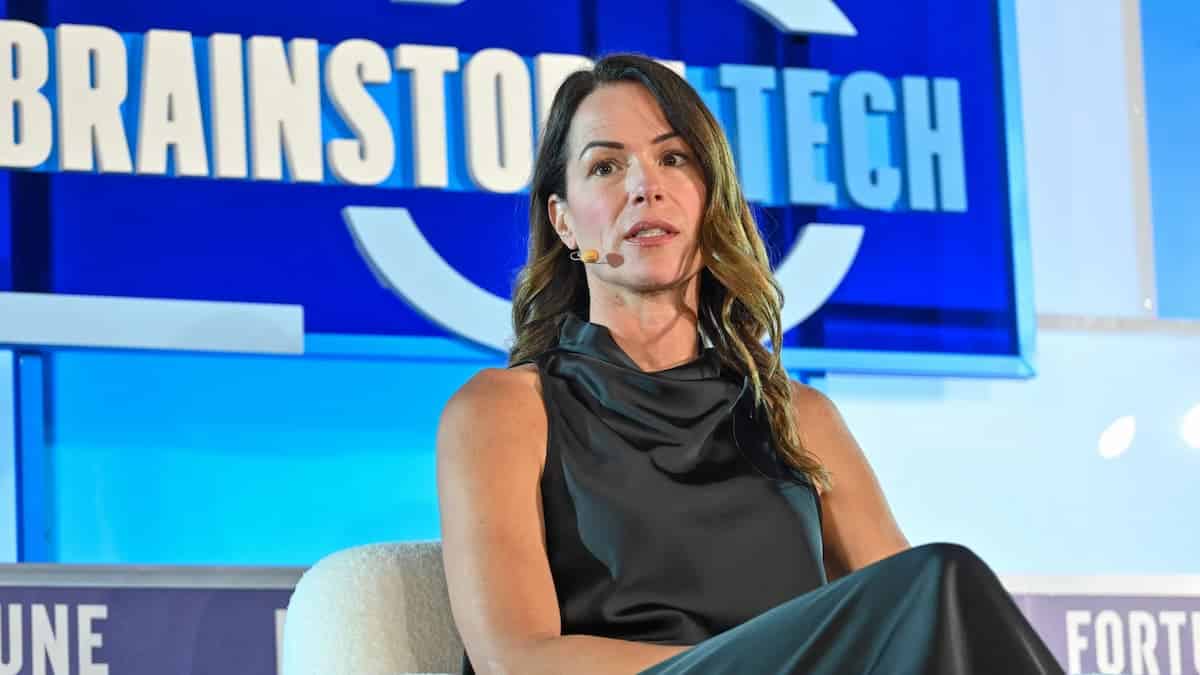
Kimberly Powell

Enfin, certains actionnaires de Nvidia ont intenté un recours collectif contre Jensen Huang et l’entreprise, reprochant à ces derniers d’avoir occulté ces informations stratégiques sur l’entreprise. 

Au final, c’est une triste fin pour celui qui a façonné le géant mondial des puces depuis 33 ans. 
GTA 6 : une nouvelle vidéo virale confirme le réalisme du jeu avant la sortie

0

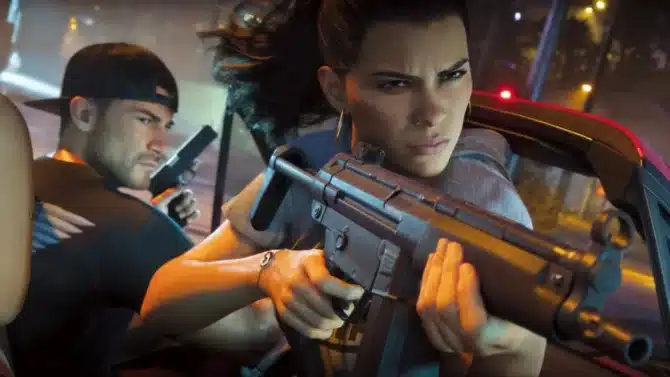
La communauté des fans de jeux vidéo s’agite à nouveau à propos de Grand Theft Auto VI. Alors que le titre de Rockstar Games est attendu dans moins d’une semaine, une nouvelle vidéo publiée sur les réseaux sociaux a suscité un vif intérêt. Cette séquence, partagée par le compte Instagram « Only in Dade », présentait ce qui semblait être un extrait authentique du jeu, montrant des véhicules de luxe alignés sur Ocean Drive à Miami.


Voir cette publication sur Instagram


Une publication partagée par GTA 6 (@gta6.only)

Initialement, de nombreux utilisateurs ont émis des doutes sur l’authenticité du contenu. La qualité visuelle et la fluidité des mouvements ont fait naître des suspicions quant à une génération par intelligence artificielle ou un rendu statique. Cependant, la situation a rapidement évolué lorsque Rockstar Games a reposté la vidéo sur son propre compte Instagram et lui a ajouté un « like ». Cette interaction de la part du studio est significative, car l’entreprise est connue pour sa rigueur et ne valide généralement pas de contenus générés artificiellement.

Même avec une console, le rendu est vraiment pas mal… 

Le véritable intérêt de cette vidéo réside dans sa capacité à recréer un événement réel qui s’est déroulé l’été dernier. Rockstar avait collaboré avec West Coast Customs pour transporter des véhicules issus de GTA 6 dans la réalité. Durant le mois d’octobre, ces voitures ont été défilées dans les rues de Miami, générant une multitude de vidéos et de publications sur les réseaux sociaux.

La séquence publiée récemment sur Instagram reproduit avec une précision remarquable ces scènes réelles. On y distingue même des détails spécifiques, tels qu’une personne sur un scooter motorisé et un individu en train de prendre des photographies devant l’un des véhicules. Ces éléments, présents dans les archives de l’événement réel, sont ici intégrés dans le jeu vidéo, suggérant une attention méticuleuse portée par les développeurs pour maintenir l’immersion et la cohérence du monde de Vice City.

Cette stratégie marketing démontre une fois de plus la créativité de Rockstar Games. Le studio a déjà réalisé une prouesse similaire il y a quelques semaines en intégrant une séquence de gameplay inédit dans un épisode de South Park. À l’époque, l’absence d’annonce préalable avait également conduit les spectateurs à suspecter une manipulation numérique avant que le nom du studio ne soit découvert dans les crédits.

La fin d’une longue attente avant le lancement

Le lancement de GTA 6 marque la conclusion d’un parcours de treize ans pour de nombreux fans. Le dernier opus de la série, Grand Theft Auto V, datait de 2013. Bien que Red Dead Redemption 2, sorti en 2018, ait permis de maintenir l’intérêt pour la marque, l’attente pour un nouveau titre de la franchise était devenue immense.

À l’heure actuelle, le préchargement du jeu a officiellement commencé, permettant aux joueurs de préparer leur installation pour la sortie prévue la semaine prochaine. Rockstar Games continue de diffuser des teasers, des captures d’écran et d’autres éléments marketing qui alimentent les spéculations sur le contenu final. Avec cette nouvelle vidéo confirmant la qualité des graphismes et la fidélité aux événements réels, l’excitation atteint son paroxysme avant l’arrivée officielle du jeu.

Jensen Huang, PDG de NVIDIA, démissionne !

Il n’aura pas fallu attendre longtemps avant que Jensen Huang démissionne de son poste de PDG de NVIDIA, mais également de membre du conseil d’administration de l’entreprise. En effet, nous vous disions ce matin que des rumeurs concernant un éventuel évincement du PDG, c’est maintenant chose faite en ce milieu d’après-midi. Ici, il n’est pas question de rumeur puisque NVIDIA publie un communiqué officiel !

Jensen Huang démissionne de NVIDIA ! 

Petit rappel des faits :

Cette nouvelle tombe juste après les précédentes affaires d’adultère de l’ancien PDG de la société. En effet, il s’était mis dans une position délicate après avoir révélé une infidélité à ses employés. Rapidement, les regards se sont tournés vers Alice Huang liée à l’entreprise Megaspeed qui est soupçonnée de renseigner le gouvernement chinois, chose que la diplomatie chinoise réfute. Plus tôt dans la journée, nous apprenions que Jensen Huang était soupçonné d’entretenir des relations intimes avec Kimberly Powell, vice-présidente de la santé chez NVIDIA. Suite à la révélation de ces événements, le conseil d’administration de l’entreprise envisageait la possibilité de remplacer Jensen. Couvrir le PDG pour une erreur, c’était tenable, mais pas deux, surtout pas en si peu de temps. Bref, Jensen Huang était cofondateur de NVIDIA et à la tête de l’entreprise depuis plus de 33 ans. Une page se tourne.

Colette Kress prend la tête temporairement :

Suite à l’annonce de la démission de Jensen Huang, il a fallu trouver quelqu’un pour assurer cette période de transition et cette personne n’est autre que Colette Kress. Pour rappel, C. Kress est l’actuelle directrice financière de la société et vice-présidente exécutive, clairement, elle connaît les dossiers de l’entreprise, les clients, les partenaires ainsi que les actionnaires, etc. Elle assurera donc le rôle de PDG par intérim tout en remplissant ses fonctions de directrice financière. Clairement, elle risque d’avoir une grosse charge de travail dans les prochains temps et nous lui souhaitons bien du courage. En attendant, le conseil d’administration recherche un PDG permanent et pour cela, les recherches se tournent à la fois vers les candidatures internes et externes à NVIDIA. Reste à savoir qui sera désigné pour diriger l’entreprise. Dans le même temps, nous retiendrons la nomination de Harvey C. Jones comme premier président du conseil d’administration de la société.

La PS5 dépasse les 100 millions d’unités vendues, GTA 6 pourrait accélérer les ventes

0

Sony Interactive Entertainment a officiellement annoncé un nouveau jalon historique pour sa console PlayStation 5. Le constructeur japonais a confirmé que l’appareil a dépassé la barre des 100 millions d’unités vendues au 10 novembre. Cette performance marque une étape significative dans l’histoire de la marque, bien que la console reste loin du record absolu détenu par la PlayStation 2.

Un record historique pour la PS5

Ce chiffre de 100 millions de ventes permet à la PlayStation 5 de devancer deux autres produits emblématiques de Sony. Elle a ainsi surpassé les ventes cumulées de la PlayStation Portable, sortie en 2004, et de la PlayStation 3, lancée en 2006. L’appareil s’approche également des 102,4 millions d’unités écoulées par la toute première PlayStation, commercialisée en 1994. Cependant, le titre de la console la plus vendue de l’entreprise revient toujours à la PlayStation 2, sortie en 2000, qui a atteint un total de 160 millions d’exemplaires.

Les chiffres de vente varient d’une année à l’autre. Le précédent sommet a été atteint lors de l’exercice 2023, où 20,8 millions d’unités ont été vendues en un seul an. L’année précédente, le total s’élevait à environ 16 millions d’unités. Pour l’exercice en cours, on observe une légère baisse par rapport aux périodes précédentes. Au premier trimestre, 1,6 million de PS5 ont été écoulées, contre 2,5 millions l’année précédente. Au deuxième trimestre, le chiffre est passé à 2,6 millions, alors que 4 millions avaient été vendus durant la même période l’an dernier.

L’impact attendu de GTA 6 sur les ventes

Les perspectives pour le troisième trimestre semblent prometteuses, notamment grâce à l’arrivée d’un titre majeur. Le jeu vidéo GTA 6, développé par Rockstar Games, est prévu pour le 19 novembre sur PlayStation 5 et Xbox Series X|S. Ce lancement suscite de fortes attentes concernant les ventes de consoles et de logiciels. La sortie du jeu coïncide avec des périodes de forte consommation comme les soldes du Black Friday et la saison de Noël, qui devraient également soutenir la demande. Cependant il ne faut pas oublier que le prix de la PS5 a aussi explosé en raison des prix de la folie sur les prix de la RAM et des SSD.

Il est intéressant de noter que Sony a indiqué que ce nouveau record de 100 millions d’unités rendait obsolète l’information publiée quelques jours auparavant, selon laquelle la console avait atteint 98 millions de ventes. Cette mise à jour rapide témoigne de la dynamique de marché actuelle. Bien que la PlayStation 5 ait franchi cette étape importante, elle doit encore parcourir un long chemin pour égaler le succès de la PlayStation 2, qui reste la référence absolue en matière de ventes de consoles de l’entreprise.

Guide pratique : agents IA locaux, workflows réels, hardware, coûts cloud et écosystème ASUS

0

Le PC ne se contente plus d’exécuter : il peut désormais agir

Pendant des décennies, le PC a fonctionné selon une logique simple : l’utilisateur donne une instruction, la machine l’exécute. Avec l’essor de l’IA agentique, ce modèle évolue. Un Agent Computer ne se limite plus à répondre à une requête : il peut recevoir un objectif, découper le travail en plusieurs étapes, mobiliser des outils, vérifier son résultat et poursuivre la tâche sous la supervision de l’utilisateur.

Découvrir la campagne ASUS Agent Computer France

C’est ce passage du simple chatbot au workflow agentique qui change la donne. Résumer chaque matin une pile de rapports, interroger une base documentaire locale, surveiller des fichiers, assister un développeur sur un codebase, préparer un briefing avant une réunion, classer automatiquement des factures ou piloter des automatisations domestiques : ces scénarios peuvent désormais être exécutés directement sur un PC suffisamment équipé. Et surtout, le modèle et les données peuvent rester sur la machine. Pour les utilisateurs qui manipulent des documents privés, du code propriétaire ou des données client, cette approche permet de réduire la dépendance à une infrastructure distante tout en gardant la possibilité d’utiliser le cloud lorsque le workload l’exige. L’Agent Computer n’oppose donc pas forcément local et cloud : il permet de choisir où exécuter chaque tâche.
Des workflows réels : du développeur à l’assistant personnel

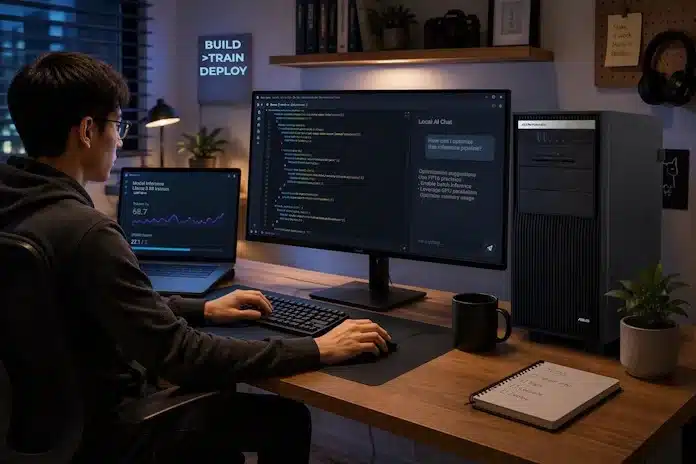
Le meilleur moyen de comprendre l’Agent Computer est de partir des usages. Un agent local peut agir comme un assistant permanent, mais aussi devenir un véritable coéquipier technique. Voici quelques scénarios déjà réalistes sur PC :
  • Développement et code : analyse d’un repository, génération de tests, debugging, refactorisation, documentation et boucles de validation dans un environnement local.
  • Documents et recherche : question-réponse sur des dossiers privés, synthèse de rapports, extraction d’informations et création de briefs sans envoyer les documents vers un service cloud.
  • Automatisation personnelle : tri d’e-mails, calendrier, rappels, suivi de projets, organisation de fichiers, smart home et tâches récurrentes.
  • Création et productivité : préparation de drafts, génération d’idées, organisation de contenus, assistance à la production et automatisation de tâches répétitives.
  • Petites entreprises : qualification de demandes, suivi commercial, contrôle de stock, consolidation de données et préparation de rapports internes.
Pour aller plus loin côté agents open source : OpenClaw et Hermes Agent illustrent deux approches d’agents capables d’orchestrer des tâches multi-étapes et des automatisations persistantes.

Le hardware compte : la VRAM n’est que le début

Pour l’IA locale, la VRAM reste un critère central : elle détermine si un modèle peut tenir entièrement dans la mémoire graphique. Mais réduire un Agent Computer à sa quantité de VRAM serait une erreur. L’inférence est une chaîne complète : stockage, transfert PCIe, mémoire système, calcul GPU, bande passante mémoire et refroidissement contribuent tous à l’expérience finale. Lors du chargement d’un modèle, un SSD NVMe rapide réduit le temps nécessaire pour lire plusieurs dizaines de gigaoctets de poids. Ensuite, ces données transitent vers la VRAM via les lignes PCIe de la carte mère. Une plateforme PCIe 5.0 prend alors tout son sens, particulièrement lorsqu’on travaille avec des modèles volumineux ou que l’on alterne fréquemment entre plusieurs modèles. Une fois l’inférence lancée, deux métriques deviennent particulièrement parlantes : le time to first token, qui dépend fortement de la phase de calcul initiale, et les tokens par seconde lors de la génération. Cette dernière phase est très sensible à la bande passante mémoire de la carte graphique. Autrement dit, pour un LLM local, les FLOPS ne racontent pas toute l’histoire.

GPU RTX : accélérer les agents et les LLM en local

Pour les workloads Agentic AI, NVIDIA recommande notamment des stacks locales combinant un agent comme OpenClaw avec un backend d’inférence tel qu’Ollama, LM Studio ou llama.cpp. Les GPU GeForce RTX accélèrent les opérations IA via leurs Tensor Cores et bénéficient de l’écosystème CUDA utilisé par ces outils. À titre indicatif, la logique de dimensionnement proposée par NVIDIA suit la quantité de VRAM disponible :
VRAM RTXExemple de modèle localUsage type
6–8 GoNemotron 3 Nano 4B / Qwen3.5 4BAssistant léger, premiers workflows
12–16 GoQwen 3.5 9B / gpt-oss 20bAgent personnel, code, RAG, automatisation
24–48GBQwen 3.5 27BWorkflows plus complexes et contexte plus large
  Guide NVIDIA recommandé : Run OpenClaw For Free On NVIDIA RTX GPUs & DGX Spark

La plateforme Intel Z890 : le socle du PC Agent

La carte graphique n’est pas seule. Pour un PC DIY orienté IA locale, la carte mère devient le socle qui relie GPU, stockage NVMe, mémoire et processeur. Une carte mère ASUS basée sur le chipset Intel Z890, associée à un processeur Intel Core Ultra Série 2, apporte une plateforme moderne adaptée aux configurations PC Agent. Le PCIe 5.0 est particulièrement pertinent dans ce contexte : lors du chargement d’un modèle, les poids passent de la mémoire système vers la VRAM de la carte graphique. Plus le modèle est volumineux ou plus les changements de modèles sont fréquents, plus la bande passante du bus peut influencer la réactivité du workflow. La plateforme doit aussi offrir une bonne capacité d’extension, des SSD NVMe rapides et une alimentation stable pour des charges soutenues. Pour les configurations avancées, la topologie PCIe de la carte mère devient également stratégique : certains workloads peuvent bénéficier de plusieurs GPU, à condition que la carte mère permette une répartition adaptée des lignes PCIe et que le châssis, l’alimentation et le refroidissement suivent.

Cloud vs IA locale : le TCO devient un argument hardware

L’un des changements les plus importants avec les agents IA est économique. Un chatbot utilisé ponctuellement consomme peu. Un agent, lui, peut planifier, appeler des outils, vérifier son travail et répéter ces étapes des dizaines ou centaines de fois. Lorsque chaque étape consomme des tokens facturés par une API, les coûts peuvent monter rapidement. Les dépenses cloud sont souvent fragmentées : abonnement principal, crédits API, licences par utilisateur, services spécialisés et nouvelles plateformes agentiques. Pour un usage intensif, le total peut atteindre plusieurs centaines de dollars par mois. C’est précisément là que l’investissement dans un PC local commence à se comparer non plus à un achat gaming, mais à un coût opérationnel récurrent. EXEMPLE TCO — LE CALCUL DES « MILLIERS » D’ÉCONOMIES Scénario illustratif issu du guide ASUS EdgeUp : à 250 $ par mois de dépenses cloud (abonnements + API), cela représente 3 000 $ par an. Un PC Agent d’environ 3 800 $ est alors amorti en près de 15 mois. Sur cinq ans, 15 000 $ de dépenses cloud sont évitées face à un investissement matériel initial de 3 800 $, soit environ 11 000 $ d’économies potentielles avant prise en compte de l’électricité. À 500 $ par mois, l’amortissement peut intervenir en moins de huit mois et le différentiel potentiel sur cinq ans dépasse 26 000 $. Ces chiffres varient selon l’usage, l’électricité, les services souscrits et la configuration, mais montrent pourquoi le TCO devient un sujet central pour les power users et petites équipes.
ScénarioCloud / moisAmortissement indicatifÉconomie potentielle / 5 ans
Usage intensif250 $~15 mois~11 000 $
Power user / petite équipe500 $< 8 mois> 26 000 $
À cela s’ajoutent des bénéfices qui ne se résument pas à une ligne de facture : absence de facturation par token et de rate limits liés à un service cloud, réduction de la latence réseau, disponibilité hors connexion et conservation des données sur la machine. Pour des documents sensibles, du code propriétaire ou des données client, ce contrôle peut devenir aussi important que le coût lui-même. Le cloud conserve néanmoins un avantage pour les modèles frontier les plus lourds ou les besoins très ponctuels. Dans la pratique, l’approche la plus rationnelle peut être hybride : local pour le volume quotidien et les données sensibles, cloud pour les tâches qui exigent ponctuellement un modèle plus massif.

Des frameworks pour passer du LLM à l’agent

Le hardware n’a de valeur que s’il est simple à exploiter. L’écosystème logiciel s’est donc considérablement enrichi : des outils d’inférence comme Ollama, LM Studio et llama.cpp permettent de charger rapidement un modèle local, tandis que des frameworks agentiques ajoutent la planification, les outils, la mémoire et les automatisations persistantes.
  • Ollama — déployer et exécuter simplement des modèles locaux.
  • LM Studio — tester des modèles locaux avec une interface accessible et un serveur local.
  • cpp — moteur d’inférence local optimisé et largement utilisé.
  • OpenClaw — agent local-first capable de travailler avec fichiers, applications et skills.
  • Hermes Agent — agent autonome orienté apprentissage, automatisation et tâches persistantes.

ASUS Zenni Claw : rendre l’Agentic AI plus accessible

ASUS Zenni Claw apporte une approche plus guidée de l’Agentic AI : au lieu de partir d’une configuration complexe ou d’un prompt vide, la plateforme propose une mise en route assistée, des skills prêts à l’emploi et des workflows orientés tâches pour le travail, les voyages et l’organisation quotidienne. L’idée est de passer plus rapidement de l’intention au résultat, tout en permettant à l’utilisateur de suivre les étapes et de garder le contrôle sur ce que l’agent exécute. Son architecture hybride peut mobiliser le traitement local ou le cloud selon la tâche, les capacités de la machine, la disponibilité des modèles et les préférences de l’utilisateur. Cette flexibilité permet de rechercher le bon équilibre entre réactivité, confidentialité, performances et maîtrise des coûts API, plutôt que d’imposer un mode d’exécution unique. Zenni Claw complète ainsi les stacks open source présentées plus haut sans les remplacer : il constitue une porte d’entrée plus accessible vers les agents multi-étapes, tandis que les utilisateurs avancés restent libres d’explorer OpenClaw, Hermes Agent, Ollama, LM Studio ou llama.cpp. La disponibilité et certaines fonctions dépendent toutefois des appareils ASUS pris en charge et de leur configuration.

Découvrir ASUS Zenni Claw

Construire son Agent Computer : partir du workflow, pas de la fiche technique

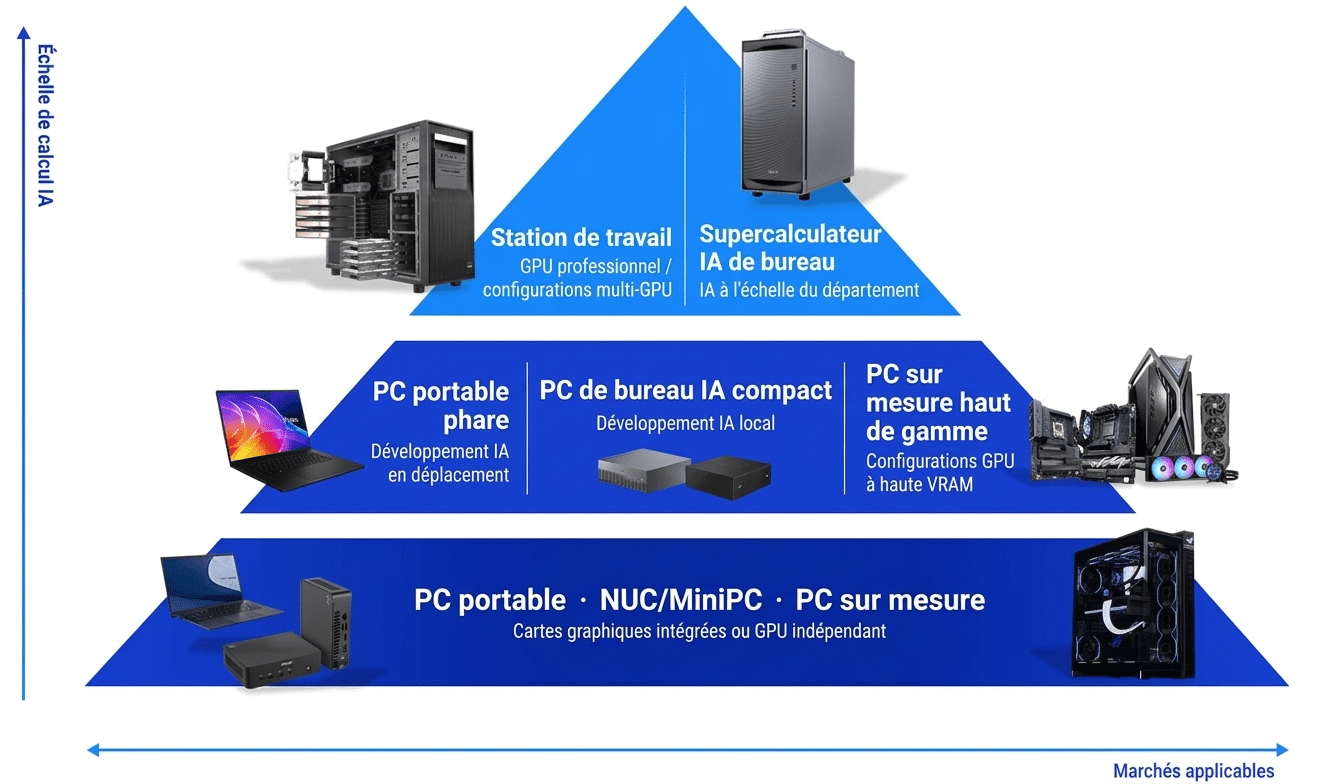
Il n’existe pas une configuration universelle. Le bon PC Agent est celui qui correspond au modèle et aux tâches que l’on souhaite réellement exécuter. Pour un assistant local réactif, une carte graphique 16 Go et 32 Go de RAM système constituent aujourd’hui un point de départ cohérent. Pour des modèles plus volumineux, davantage de VRAM, une plateforme plus évolutive ou du multi-GPU deviennent pertinents.
UsageGPU / VRAMPlateformePourquoi
Découverte / assistant local8–16 GoPC moderneModèles compacts, chat local, automatisations simples
Agent quotidien / dev / RAG16 Go et +Z890 + Core Ultra Series 2, 32 Go RAMBon compromis réactivité / contexte / coût
Workflows avancés24–32 Go et +PCIe 5.0, stockage NVMe rapide, RAM supérieureModèles plus larges et contexte long
Très gros modèles / multi-GPUPlusieurs GPUCarte mère adaptée x8/x8, PSU et cooling renforcésAgrégation de VRAM et workloads complexes
 

Et si votre prochain projet devenait un véritable Agent Computer ?

ASUS France prolonge cette logique avec l’ASUS Agent Computer Challenge, sous la signature « Votre PC. Votre Agent. ». Ce challenge local s’adresse aux passionnés d’IA et de hardware, gamers / PC builders, étudiants, développeurs, ingénieurs et professionnels de l’IA. L’objectif n’est pas de récompenser la simple popularité d’un projet, mais de faire émerger des démonstrations concrètes d’Agentic AI et d’IA locale : un agent capable de recevoir un objectif, d’utiliser des outils, d’enchaîner plusieurs étapes et de produire un résultat réel sur PC. Trois niveaux structurent les candidatures : AI Entry pour un premier concept ou une première expérimentation, Developer pour un prototype ou workflow fonctionnel, et Advanced / High-End pour les architectures les plus ambitieuses. Les participants restent libres de choisir leurs modèles et frameworks : Zenni Claw peut servir de point d’entrée guidé, mais OpenClaw, Hermes Agent, Ollama, LM Studio, llama.cpp ou d’autres stacks open source restent pleinement pertinents. L’évaluation privilégie avant tout la pertinence Agentic / Local AI et la faisabilité technique (30 % chacune), puis l’originalité et le potentiel du projet (20 %) ainsi que l’adéquation hardware et la clarté de la proposition (20 %). La portée sociale n’entre pas dans le score du jury. Pierre Bittner intervient comme technical reviewer. Les candidatures sont ouvertes jusqu’au 6 décembre 2026. Participer au ASUS Agent Computer Challenge : fr.asus.click/ACC_CWCT Pour les utilisateurs qui exploitent l’IA chaque jour, la question n’est donc plus seulement « quel modèle est le meilleur ? », mais aussi « où ai-je intérêt à l’exécuter ? ». À mesure que les modèles open-weight progressent, que les frameworks agentiques gagnent en maturité et que les GPU accélèrent des workflows toujours plus complexes, le PC DIY retrouve une place centrale dans cette équation. GPU GeForce RTX, plateforme ASUS Z890 avec Intel Core Ultra Série 2, stockage NVMe, mémoire et software agentique forment ensemble une base évolutive pour expérimenter aujourd’hui et construire les workflows de demain.
POUR ALLER PLUS LOIN ASUS Agent Computer France — comprendre les scénarios, explorer le hardware et accéder aux ressources pour démarrer avec l’IA locale.
 

→ Découvrir ASUS Agent Computer France

AMD EPYC Venice : 27 % d’IPC pour Zen 6

0

La gamme EPYC d’AMD a franchi un cap majeur avec l’arrivée officielle de la sixième génération, répondant au nom de code Venice. Basée sur l’architecture Zen 6, cette nouvelle famille de processeurs s’adresse directement à l’ère de l’IA agentique et des charges de travail de calcul haute performance (HPC). Les premiers tests approfondis réalisés par des analystes indépendants confirment que ces puces apportent des améliorations significatives par rapport à la génération précédente, Turin (Zen 5), tout en surpassant les offres concurrentes comme le CPU Vera de Nvidia dans de nombreux scénarios.

AMD Zen 6 EPYC &lsquo;Venice&rsquo;

Le cœur du changement réside dans l’architecture elle-même. AMD a annoncé un gain moyen d’instructions par cycle (IPC) de 27 % dans les environnements de serveurs, cloud et IA. Ce chiffre, qui représente une avancée majeure, est obtenu en comparant des configurations équivalentes en nombre de cœurs, mais avec une densité différente : 16 cœurs Zen 6c sur un seul CCD face à 16 cœurs Zen 5 répartis sur deux CCD. Dans les charges de travail spécifiques, l’amélioration atteint 20 % pour l’entreprise et le cloud, et grimpe à 31 % pour les tâches d’intelligence artificielle.

Une densité accrue et des fréquences repoussées

Sur le plan matériel, la transition vers Zen 6 se traduit par une augmentation de la densité des CCD. Alors que les CCD Zen 5 pouvaient accueillir jusqu’à huit cœurs, la nouvelle architecture permet d’installer jusqu’à douze cœurs complets par CCD. Pour la variante optimisée pour la densité, le Zen 6c, cette capacité double pour atteindre 32 cœurs par CCD. Cette évolution permet de construire des puces embarquant jusqu’à 256 cœurs et 1 024 threads en configuration double socket (2P), comme le modèle EPYC 9996.

Parallèlement, la variante haute fréquence, l’EPYC 9686F, pousse les limites des fréquences d’horloge. Elle dispose de 96 cœurs et peut atteindre des fréquences de boost allant jusqu’à 5,3 GHz, surpassant ainsi les modèles précédents. Cette capacité à maintenir des fréquences élevées sur un grand nombre de cœurs est cruciale pour les applications sensibles à la latence et au calcul scientifique. La quantité de cache L3 augmente également, passant de 32 Mo à 48 Mo par CCD pour la version standard et est quadruplée pour la version 6c, offrant ainsi plus de 128 Mo de cache partagé par complexe de 32 cœurs.

La fabrication de ces puces repose sur le nœud de production N2P de TSMC. Par rapport au nœud N3E utilisé pour Zen 5, cette technologie offre un gain de performances de 18 % à puissance égale, ou une réduction de consommation de 36 % pour une même vitesse. Ces gains technologiques, combinés aux modifications internes du pipeline d’exécution, permettent d’atteindre des performances globales bien supérieures.

Performance face à la concurrence et à la mémoire

Les tests indépendants montrent que l’EPYC 9996, avec ses 1 024 threads, délivre jusqu’à 93 % de performances en plus dans les tests de débit SPEC CPU 2026 par rapport au modèle Zen 5 précédent. L’EPYC 9686F, quant à lui, affiche une avance de 17 % sur le CPU Vera de Nvidia dans les tests de débit, et une marge encore plus large de 40 % dans les tests de performance flottante (fprate). Ces résultats valident l’affirmation d’AMD selon laquelle Venice est fondamentalement une génération en avance sur la concurrence actuelle.

La plateforme SP7 associée à ces processeurs introduit également une amélioration dans la gestion de la mémoire. Elle prend désormais en charge jusqu’à 16 canaux de mémoire DDR5, permettant des vitesses de transfert de 12 800 MT/s avec les modules MRDIMM. Cela se traduit par une bande passante mémoire théorique pouvant atteindre 1,6 To/s par socket, un chiffre largement supérieur à celui des solutions concurrentes utilisant des mémoires LPDDR5 comme la Vera de Nvidia. Bien que la topologie de la Vera permette une latence très faible, la bande passante brute et la capacité de stockage (jusqu’à 8 To par socket) de la plateforme SP7 offrent un avantage décisif pour les applications gourmandes en données.

Enfin, pour les systèmes embarqués nécessitant une longévité accrue, AMD a également annoncé la série EPYC Embedded 9006. Ces puces, partageant la même architecture et les mêmes capacités de mémoire, offrent une disponibilité garantie de sept ans, incluant des mises à jour de firmware et de sécurité à long terme, ce qui est essentiel pour les infrastructures critiques et les équipements de test automatisé.

NT-CP1 : un pad thermique en nanotube de carbone chez Noctua !

Noctua vient d’annoncer le lancement d’un nouveau produit avec son NT-CP1. Ce dernier vient donc remplacer la pâte thermique et propose une meilleure tenue mécanique dans le temps ainsi qu’un maintien des performances dans le temps. Bref, si vous ne voulez pas changer votre pâte tous les 15 jours, c’est une option à considérer d’autant que les performances s’annoncent prometteuses.

NT-CP1 : un pad thermique en nanotubes de carbone remplaçant la pâte thermique !

Une efficacité qui s’améliore après plusieurs cycles de chauffe :

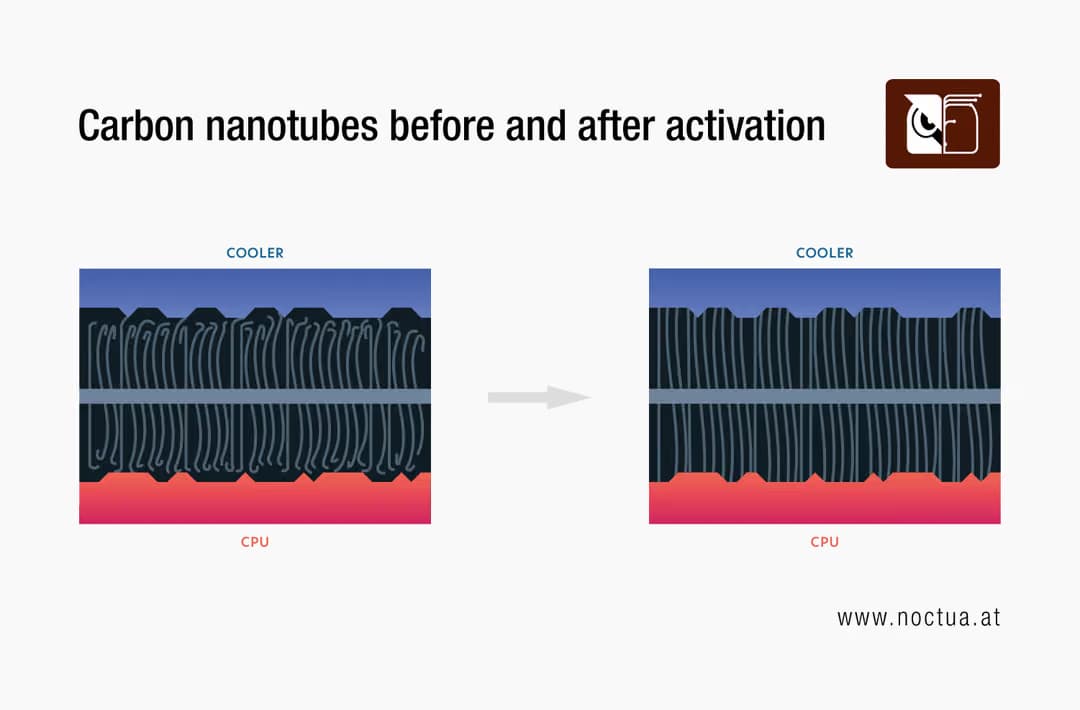
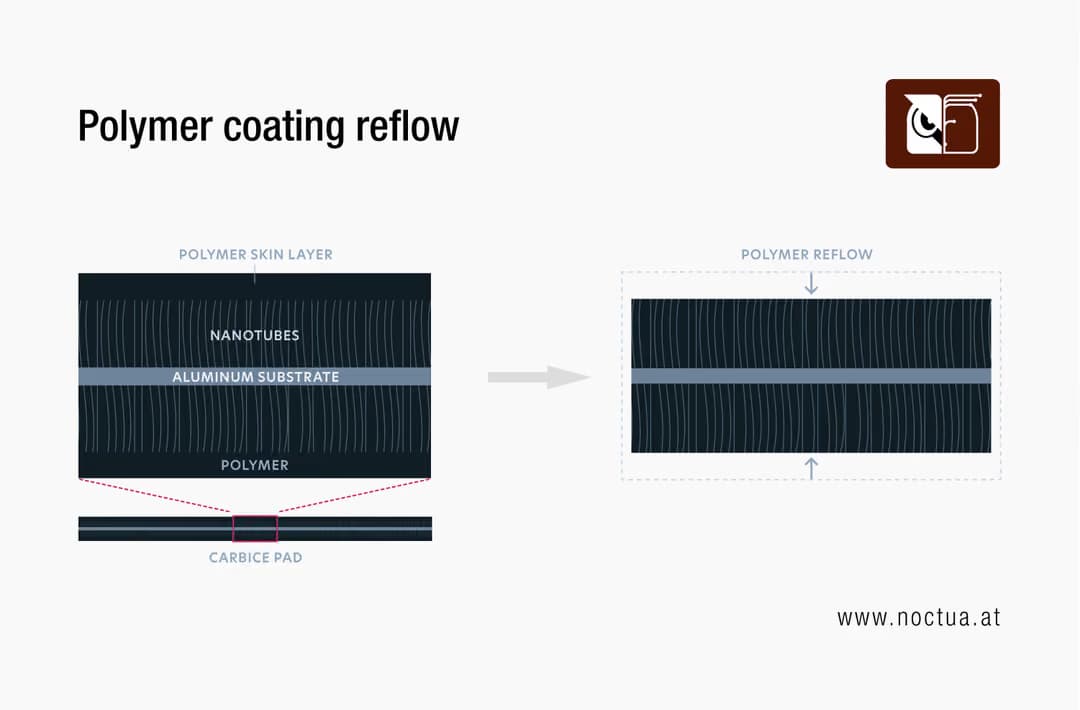
Dans les grandes lignes, le NT-CP1 est constitué de deux couches de nanotubes de carbone montées sur une base extrêmement fine en aluminium assurant sa rigidité. De plus, les deux faces présentent une couche de polymère afin de faciliter l’installation. Ces dernières seront un frein pour les performances… Dans un premier temps. En effet, au fil des cycles de chauffe et de refroidissement, cette couche de polymère se liquéfie, permettant aux nanotubes de prendre position de sorte à combler les micro-aspérités et maximiser les performances. Dans un premier temps, ne soyez pas surpris si vous avez des températures élevées en comparaison avec de la pâte thermique classique, ces dernières vont drastiquement diminuer après une dizaine de cycles.

Une meilleure tenue dans le temps :

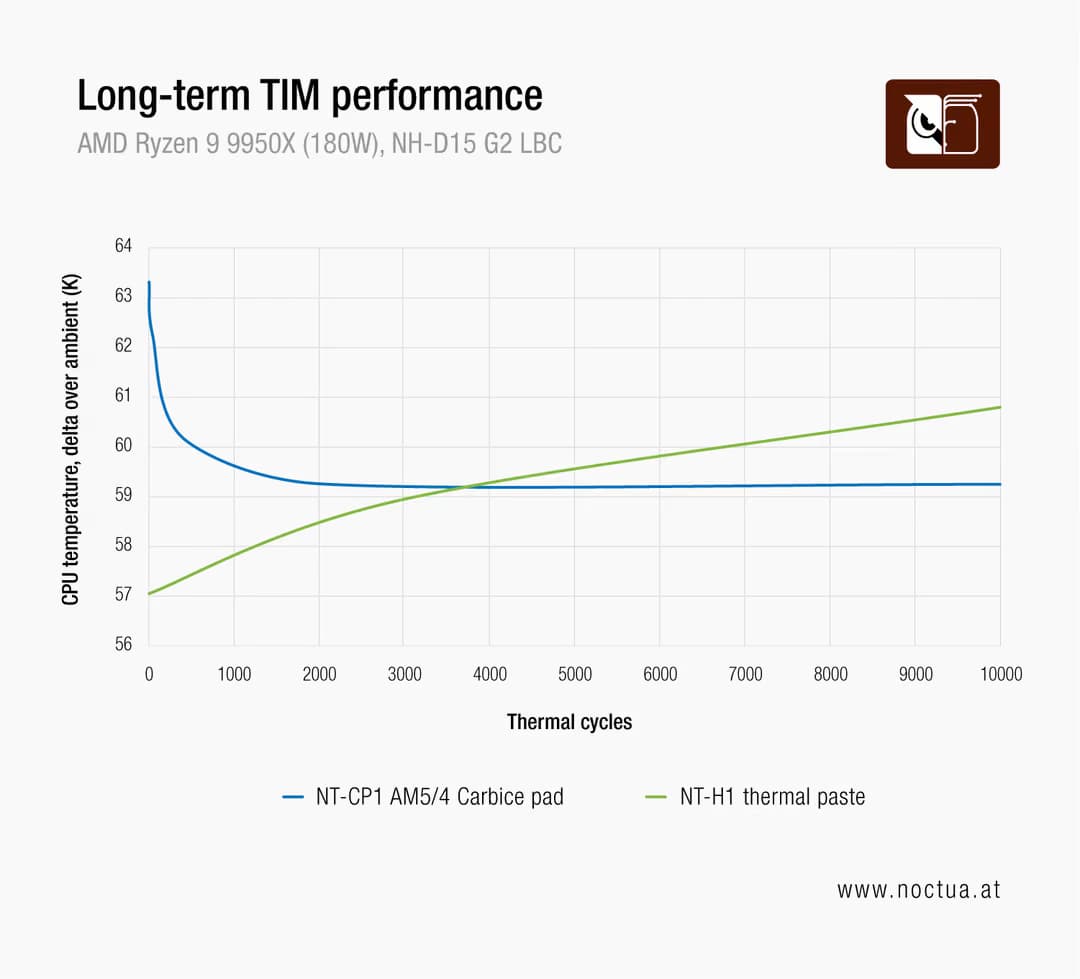
Noctua NT-CP1 L’un des inconvénients de la pâte thermique concerne sa stabilité dans le temps puisque, au fil du temps, un effet pump-out se fait sentir… Ou la pâte finit par sécher, voire encore autre chose. Dans tous les cas, les performances sont vouées à se dégrader dans le temps ce qui n’arrive pas avec ce pad. Si les températures sont élevées dès les premières heures d’utilisation, cela se stabilise au fil du temps et, après 3 700 cycles thermiques, le NT-CP1 dépasse la NT-H1 au niveau des performances (tests de long terme). Mieux encore, le pad maintient ses performances là où elles se dégradent avec le temps. De plus, sa structure rigide empêche les effets pump-out tandis qu’il ne séchera pas ou ne craquera.

Application simple : 

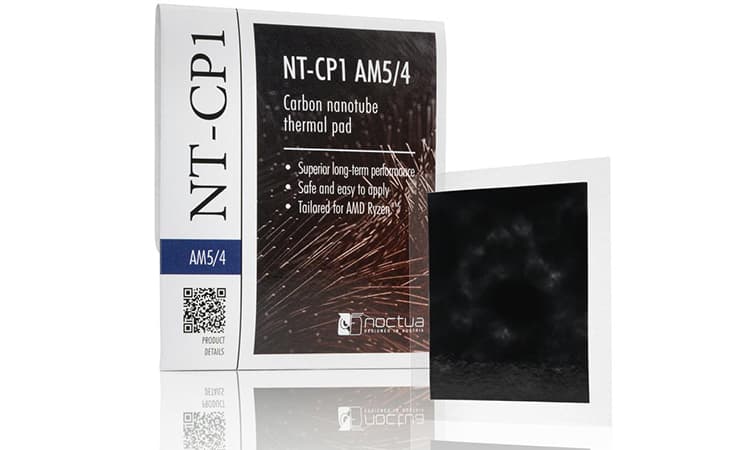
Enfin, nous retiendrons une application simple du pad qui se résume en trois étapes : décoller, presser, décoller. En effet, avant de positionner le NT-CP1 sur le CPU, il faudra retirer un opercule en plastique, placer le pad qui collera au CPU grâce aux couches de polymère puis enlever le dernier opercule avant de monter son ventirad. Concrètement, ce dernier prend la forme d’un petit carré noir collant de 33 × 33 mm dont les dimensions ont été optimisées pour les processeurs AMD au socket AM4 et AM5. Enfin, Noctua recommande l’utilisation de son pad avec ses propres dissipateurs bien qu’une compatibilité avec d’autres systèmes de refroidissement soit évoquée. Les performances dépendront du traitement de surface des autres dissipateurs. Noctua NT-CP1

Le prix : 

Côté prix, ce pad n’est pas donné puisqu’il s’affiche à quelque 24,95 €, soit le prix d’une bonne seringue de pâte haut de gamme. Cependant, on gardera à l’esprit qu’il se destine à une installation à long terme et que vous n’aurez pas à le changer de sitôt. Voyez cela comme un investissement sur la durée… Du moins, si vous n’êtes pas du genre à changer de matériel tous les 6 mois.

Par ici la fiche produit de Noctua !