

Le PC ne se contente plus d’exécuter : il peut désormais agir
Pendant des décennies, le PC a fonctionné selon une logique simple : l’utilisateur donne une instruction, la machine l’exécute. Avec l’essor de l’IA agentique, ce modèle évolue. Un Agent Computer ne se limite plus à répondre à une requête : il peut recevoir un objectif, découper le travail en plusieurs étapes, mobiliser des outils, vérifier son résultat et poursuivre la tâche sous la supervision de l’utilisateur.
C’est ce passage du simple chatbot au workflow agentique qui change la donne. Résumer chaque matin une pile de rapports, interroger une base documentaire locale, surveiller des fichiers, assister un développeur sur un codebase, préparer un briefing avant une réunion, classer automatiquement des factures ou piloter des automatisations domestiques : ces scénarios peuvent désormais être exécutés directement sur un PC suffisamment équipé.
Et surtout, le modèle et les données peuvent rester sur la machine. Pour les utilisateurs qui manipulent des documents privés, du code propriétaire ou des données client, cette approche permet de réduire la dépendance à une infrastructure distante tout en gardant la possibilité d’utiliser le cloud lorsque le workload l’exige. L’Agent Computer n’oppose donc pas forcément local et cloud : il permet de choisir où exécuter chaque tâche.
Des workflows réels : du développeur à l’assistant personnel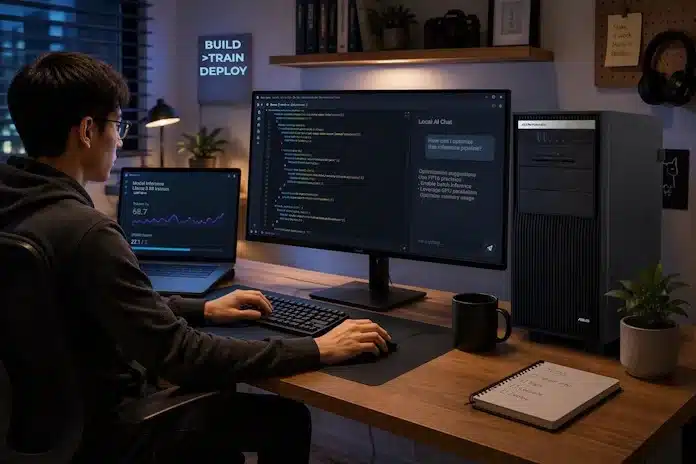
Le meilleur moyen de comprendre l’Agent Computer est de partir des usages. Un agent local peut agir comme un assistant permanent, mais aussi devenir un véritable coéquipier technique. Voici quelques scénarios déjà réalistes sur PC :
- Développement et code : analyse d’un repository, génération de tests, debugging, refactorisation, documentation et boucles de validation dans un environnement local.
- Documents et recherche : question-réponse sur des dossiers privés, synthèse de rapports, extraction d’informations et création de briefs sans envoyer les documents vers un service cloud.
- Automatisation personnelle : tri d’e-mails, calendrier, rappels, suivi de projets, organisation de fichiers, smart home et tâches récurrentes.
- Création et productivité : préparation de drafts, génération d’idées, organisation de contenus, assistance à la production et automatisation de tâches répétitives.
- Petites entreprises : qualification de demandes, suivi commercial, contrôle de stock, consolidation de données et préparation de rapports internes.
Pour aller plus loin côté agents open source : OpenClaw et Hermes Agent illustrent deux approches d’agents capables d’orchestrer des tâches multi-étapes et des automatisations persistantes.
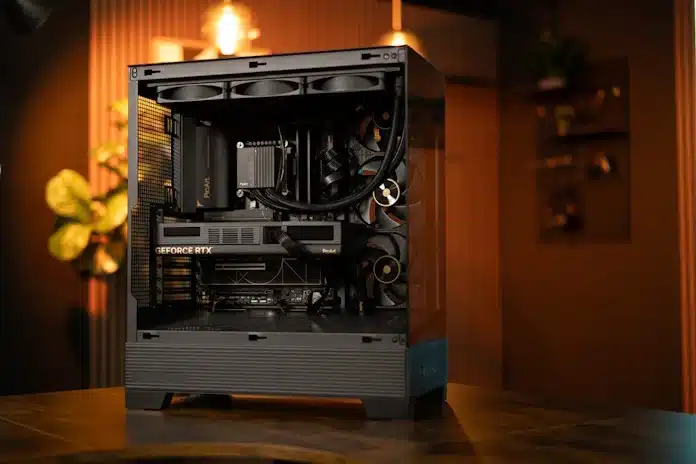
Le hardware compte : la VRAM n’est que le début
Pour l’IA locale, la VRAM reste un critère central : elle détermine si un modèle peut tenir entièrement dans la mémoire graphique. Mais réduire un Agent Computer à sa quantité de VRAM serait une erreur. L’inférence est une chaîne complète : stockage, transfert PCIe, mémoire système, calcul GPU, bande passante mémoire et refroidissement contribuent tous à l’expérience finale.
Lors du chargement d’un modèle, un SSD NVMe rapide réduit le temps nécessaire pour lire plusieurs dizaines de gigaoctets de poids. Ensuite, ces données transitent vers la VRAM via les lignes PCIe de la carte mère. Une plateforme PCIe 5.0 prend alors tout son sens, particulièrement lorsqu’on travaille avec des modèles volumineux ou que l’on alterne fréquemment entre plusieurs modèles.
Une fois l’inférence lancée, deux métriques deviennent particulièrement parlantes : le time to first token, qui dépend fortement de la phase de calcul initiale, et les tokens par seconde lors de la génération. Cette dernière phase est très sensible à la bande passante mémoire de la carte graphique. Autrement dit, pour un LLM local, les FLOPS ne racontent pas toute l’histoire.
GPU RTX : accélérer les agents et les LLM en local
Pour les workloads Agentic AI, NVIDIA recommande notamment des stacks locales combinant un agent comme OpenClaw avec un backend d’inférence tel qu’Ollama, LM Studio ou llama.cpp. Les GPU GeForce RTX accélèrent les opérations IA via leurs Tensor Cores et bénéficient de l’écosystème CUDA utilisé par ces outils.
À titre indicatif, la logique de dimensionnement proposée par NVIDIA suit la quantité de VRAM disponible :
| VRAM RTX | Exemple de modèle local | Usage type |
| 6–8 Go | Nemotron 3 Nano 4B / Qwen3.5 4B | Assistant léger, premiers workflows |
| 12–16 Go | Qwen 3.5 9B / gpt-oss 20b | Agent personnel, code, RAG, automatisation |
| 24–48GB | Qwen 3.5 27B | Workflows plus complexes et contexte plus large |
Guide NVIDIA recommandé : Run OpenClaw For Free On NVIDIA RTX GPUs & DGX Spark
La plateforme Intel Z890 : le socle du PC Agent
La carte graphique n’est pas seule. Pour un PC DIY orienté IA locale, la carte mère devient le socle qui relie GPU, stockage NVMe, mémoire et processeur. Une carte mère ASUS basée sur le chipset Intel Z890, associée à un processeur Intel Core Ultra Série 2, apporte une plateforme moderne adaptée aux configurations PC Agent.
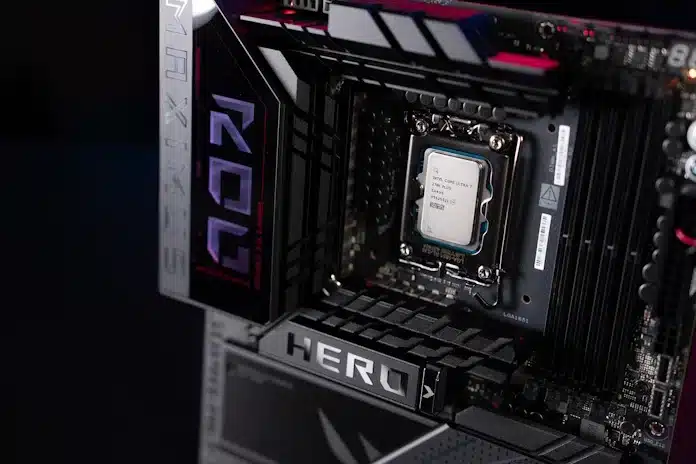
Le PCIe 5.0 est particulièrement pertinent dans ce contexte : lors du chargement d’un modèle, les poids passent de la mémoire système vers la VRAM de la carte graphique. Plus le modèle est volumineux ou plus les changements de modèles sont fréquents, plus la bande passante du bus peut influencer la réactivité du workflow. La plateforme doit aussi offrir une bonne capacité d’extension, des SSD NVMe rapides et une alimentation stable pour des charges soutenues.
Pour les configurations avancées, la topologie PCIe de la carte mère devient également stratégique : certains workloads peuvent bénéficier de plusieurs GPU, à condition que la carte mère permette une répartition adaptée des lignes PCIe et que le châssis, l’alimentation et le refroidissement suivent.
Cloud vs IA locale : le TCO devient un argument hardware
L’un des changements les plus importants avec les agents IA est économique. Un chatbot utilisé ponctuellement consomme peu. Un agent, lui, peut planifier, appeler des outils, vérifier son travail et répéter ces étapes des dizaines ou centaines de fois. Lorsque chaque étape consomme des tokens facturés par une API, les coûts peuvent monter rapidement.
Les dépenses cloud sont souvent fragmentées : abonnement principal, crédits API, licences par utilisateur, services spécialisés et nouvelles plateformes agentiques. Pour un usage intensif, le total peut atteindre plusieurs centaines de dollars par mois. C’est précisément là que l’investissement dans un PC local commence à se comparer non plus à un achat gaming, mais à un coût opérationnel récurrent.
EXEMPLE TCO — LE CALCUL DES « MILLIERS » D’ÉCONOMIES
Scénario illustratif issu du guide ASUS EdgeUp : à 250 $ par mois de dépenses cloud (abonnements + API), cela représente 3 000 $ par an. Un PC Agent d’environ 3 800 $ est alors amorti en près de 15 mois. Sur cinq ans, 15 000 $ de dépenses cloud sont évitées face à un investissement matériel initial de 3 800 $, soit environ 11 000 $ d’économies potentielles avant prise en compte de l’électricité. À 500 $ par mois, l’amortissement peut intervenir en moins de huit mois et le différentiel potentiel sur cinq ans dépasse 26 000 $. Ces chiffres varient selon l’usage, l’électricité, les services souscrits et la configuration, mais montrent pourquoi le TCO devient un sujet central pour les power users et petites équipes.
| Scénario | Cloud / mois | Amortissement indicatif | Économie potentielle / 5 ans |
| Usage intensif | 250 $ | ~15 mois | ~11 000 $ |
| Power user / petite équipe | 500 $ | < 8 mois | > 26 000 $ |
À cela s’ajoutent des bénéfices qui ne se résument pas à une ligne de facture : absence de facturation par token et de rate limits liés à un service cloud, réduction de la latence réseau, disponibilité hors connexion et conservation des données sur la machine. Pour des documents sensibles, du code propriétaire ou des données client, ce contrôle peut devenir aussi important que le coût lui-même.
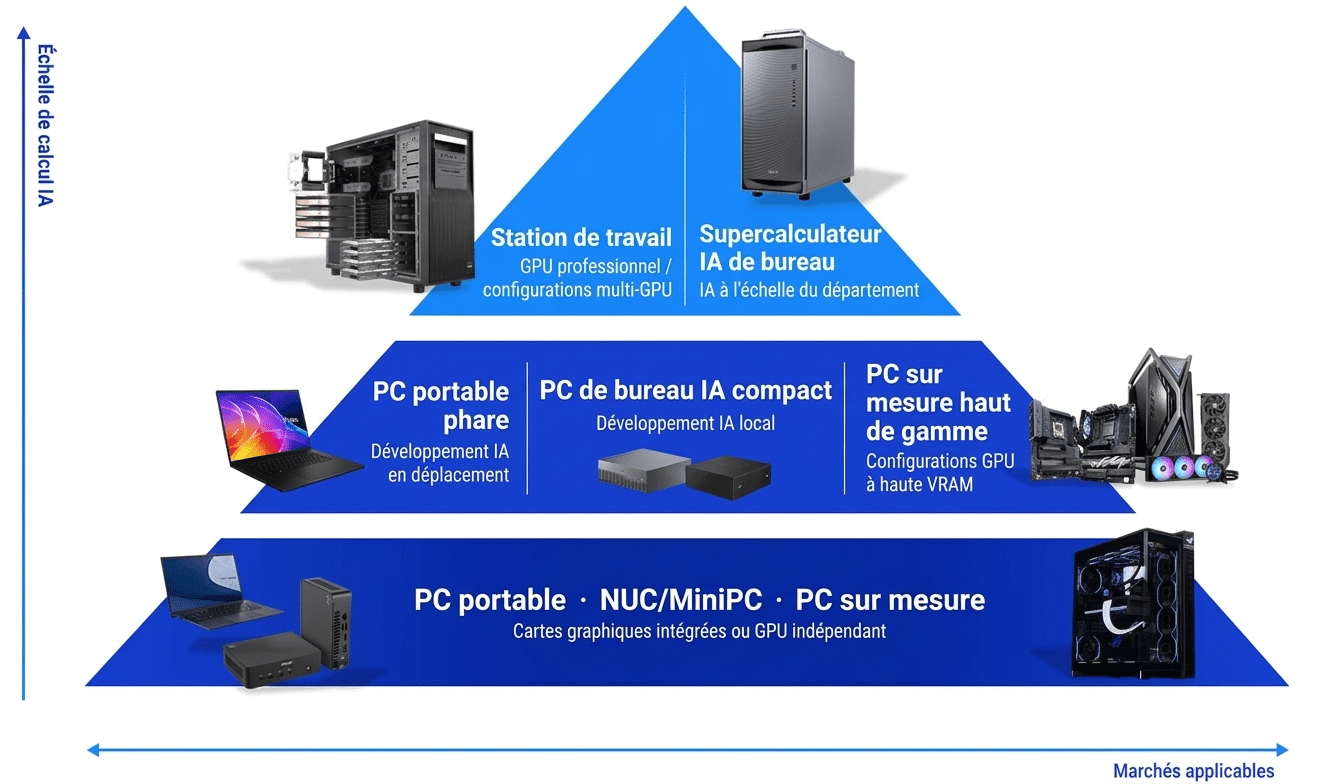
Le cloud conserve néanmoins un avantage pour les modèles frontier les plus lourds ou les besoins très ponctuels. Dans la pratique, l’approche la plus rationnelle peut être hybride : local pour le volume quotidien et les données sensibles, cloud pour les tâches qui exigent ponctuellement un modèle plus massif.
Des frameworks pour passer du LLM à l’agent
Le hardware n’a de valeur que s’il est simple à exploiter. L’écosystème logiciel s’est donc considérablement enrichi : des outils d’inférence comme Ollama, LM Studio et llama.cpp permettent de charger rapidement un modèle local, tandis que des frameworks agentiques ajoutent la planification, les outils, la mémoire et les automatisations persistantes.
- Ollama — déployer et exécuter simplement des modèles locaux.
- LM Studio — tester des modèles locaux avec une interface accessible et un serveur local.
- cpp — moteur d’inférence local optimisé et largement utilisé.
- OpenClaw — agent local-first capable de travailler avec fichiers, applications et skills.
- Hermes Agent — agent autonome orienté apprentissage, automatisation et tâches persistantes.
ASUS Zenni Claw : rendre l’Agentic AI plus accessible
ASUS Zenni Claw apporte une approche plus guidée de l’Agentic AI : au lieu de partir d’une configuration complexe ou d’un prompt vide, la plateforme propose une mise en route assistée, des skills prêts à l’emploi et des workflows orientés tâches pour le travail, les voyages et l’organisation quotidienne. L’idée est de passer plus rapidement de l’intention au résultat, tout en permettant à l’utilisateur de suivre les étapes et de garder le contrôle sur ce que l’agent exécute.
Son architecture hybride peut mobiliser le traitement local ou le cloud selon la tâche, les capacités de la machine, la disponibilité des modèles et les préférences de l’utilisateur. Cette flexibilité permet de rechercher le bon équilibre entre réactivité, confidentialité, performances et maîtrise des coûts API, plutôt que d’imposer un mode d’exécution unique.
Zenni Claw complète ainsi les stacks open source présentées plus haut sans les remplacer : il constitue une porte d’entrée plus accessible vers les agents multi-étapes, tandis que les utilisateurs avancés restent libres d’explorer OpenClaw, Hermes Agent, Ollama, LM Studio ou llama.cpp. La disponibilité et certaines fonctions dépendent toutefois des appareils ASUS pris en charge et de leur configuration.

Construire son Agent Computer : partir du workflow, pas de la fiche technique
Il n’existe pas une configuration universelle. Le bon PC Agent est celui qui correspond au modèle et aux tâches que l’on souhaite réellement exécuter. Pour un assistant local réactif, une carte graphique 16 Go et 32 Go de RAM système constituent aujourd’hui un point de départ cohérent. Pour des modèles plus volumineux, davantage de VRAM, une plateforme plus évolutive ou du multi-GPU deviennent pertinents.
| Usage | GPU / VRAM | Plateforme | Pourquoi |
| Découverte / assistant local | 8–16 Go | PC moderne | Modèles compacts, chat local, automatisations simples |
| Agent quotidien / dev / RAG | 16 Go et + | Z890 + Core Ultra Series 2, 32 Go RAM | Bon compromis réactivité / contexte / coût |
| Workflows avancés | 24–32 Go et + | PCIe 5.0, stockage NVMe rapide, RAM supérieure | Modèles plus larges et contexte long |
| Très gros modèles / multi-GPU | Plusieurs GPU | Carte mère adaptée x8/x8, PSU et cooling renforcés | Agrégation de VRAM et workloads complexes |
Et si votre prochain projet devenait un véritable Agent Computer ?
ASUS France prolonge cette logique avec l’ASUS Agent Computer Challenge, sous la signature « Votre PC. Votre Agent. ». Ce challenge local s’adresse aux passionnés d’IA et de hardware, gamers / PC builders, étudiants, développeurs, ingénieurs et professionnels de l’IA. L’objectif n’est pas de récompenser la simple popularité d’un projet, mais de faire émerger des démonstrations concrètes d’Agentic AI et d’IA locale : un agent capable de recevoir un objectif, d’utiliser des outils, d’enchaîner plusieurs étapes et de produire un résultat réel sur PC.
Trois niveaux structurent les candidatures : AI Entry pour un premier concept ou une première expérimentation, Developer pour un prototype ou workflow fonctionnel, et Advanced / High-End pour les architectures les plus ambitieuses. Les participants restent libres de choisir leurs modèles et frameworks : Zenni Claw peut servir de point d’entrée guidé, mais OpenClaw, Hermes Agent, Ollama, LM Studio, llama.cpp ou d’autres stacks open source restent pleinement pertinents.
L’évaluation privilégie avant tout la pertinence Agentic / Local AI et la faisabilité technique (30 % chacune), puis l’originalité et le potentiel du projet (20 %) ainsi que l’adéquation hardware et la clarté de la proposition (20 %). La portée sociale n’entre pas dans le score du jury. Pierre Bittner intervient comme technical reviewer. Les candidatures sont ouvertes jusqu’au 6 décembre 2026.
Participer au ASUS Agent Computer Challenge : fr.asus.click/ACC_CWCT
Pour les utilisateurs qui exploitent l’IA chaque jour, la question n’est donc plus seulement « quel modèle est le meilleur ? », mais aussi « où ai-je intérêt à l’exécuter ? ». À mesure que les modèles open-weight progressent, que les frameworks agentiques gagnent en maturité et que les GPU accélèrent des workflows toujours plus complexes, le PC DIY retrouve une place centrale dans cette équation.
GPU GeForce RTX, plateforme ASUS Z890 avec Intel Core Ultra Série 2, stockage NVMe, mémoire et software agentique forment ensemble une base évolutive pour expérimenter aujourd’hui et construire les workflows de demain.
| POUR ALLER PLUS LOIN ASUS Agent Computer France — comprendre les scénarios, explorer le hardware et accéder aux ressources pour démarrer avec l’IA locale. |