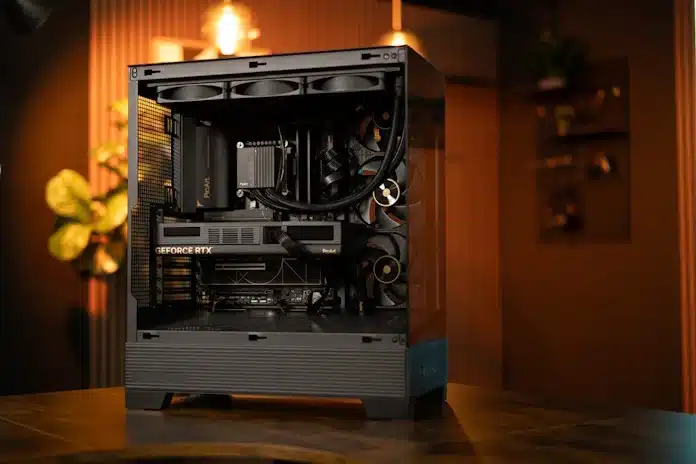
Tryx lance son boîtier Flova F50, une référence que nous découvrions lors du Computex en mai dernier. Au programme, il s’agit d’un boîtier original qui dispose d’un ventilateur radial sur colonne ainsi qu’une façade et d’une partie latérale basse couvertes de tissus. Quant au coloris, nous avons du noir et du blanc, des coloris assez classiques et contre toute attente… Du rose.
Flova F50 : un ventilateur radial sur colonne et un revêtement en tissu !
Avec ce boîtier, la marque annonce une nouvelle référence au format moyen tour pour le moins originale. Effectivement, la façade de ce modèle adopte un revêtement tissu de qualité studio que l’on retrouve également au niveau du tunnel d’alimentation.
Mais là où la marque se distingue, c’est sur la ventilation de base proposée par ce modèle. Plutôt que d’opter pour des ventilateurs axiaux tout à fait classiques, Tryx adopte un ventilateur radial sur colonne (CrossFlow) monté à côté de la façade. Ce dernier dispose d’une prise d’air dédiée qui canalisera l’air frais à l’intérieur du boîtier. Ce ventilateur fonctionne selon trois mode : Eco (1100 tr/min), Performance (1800 tr/min) et Over-Drive (jusqu’à 2500 tr/min).
En dehors de ces éléments, le boîtier adopte un châssis au format plutôt classique permettant le montage de cartes mères ATX, micro-ATX et mini-ITX en plus d’offrir une compatibilité BTF. La compatibilité des composants est bonne :
360 à 420 mm pour la carte graphique suivants si l’on conserve le ventilateur crossflow.
170 mm de hauteur pour le ventirad CPU.
200 mm de profondeur pour l’alimentation.
Malgré la présence du ventilateur CrossFlow, Tryx met en avant jusque onze emplacements en 120 mm avec deux emplacements de 200 mm en façade. Quant au watercooling, le support de radiateurs en 360 mm est assuré dans la partie haute.
Concernant le montant de la facture, on nous annonçait au Computex $139. En Chine, le prix est de 899 yuans soit environ 110 € après conversion. Mais encore une fois, il y a un véritable décalage entre le prix chinois et le prix en euro.
En un an, les prix de la RAM ont atteint des sommets. Nous vivons actuellement une situation ridicule où le moindre kit de mémoire DDR5 de 32 Go se vend le prix d’une carte graphique milieu de gamme. En effet, pour le prix d’un kit de 32 Go de Corsair Vengeance, vous pouvez vous acheter une RTX 5060 Ti 16 Go…
DDR5 : où en sommes nous en janvier 2026 ?
Malheureusement, la situation n’est pas bonne est les prix continuent de monter tandis que de nombreuses ruptures de stock sont encore à déplorer. Chez Top Achat par exemple, la mémoire la moins chère encore accessible en 32 Go, c’est de la ValueRAM de chez Kingston. Une série d’entrée de gamme, sans dissipateur. Ici, il est question d’une unique barrette fonctionnant à 5600 MT/s en CAS40. Sinon, le premier kit dual channel encore disponible est un set Crucial Pro Overclocking de 2×16 Go à 6000 MT/s CAS36 affiché 500 €. Pourtant, il s’agit d’un kit grand public largement distribué.
Chez Amazon, la situation n’est guère meilleure puisque le kit de Corsair Vengeance en 2×16 Go 6000 MT/s CL36 s’affiche à 537 €. Il s’agit là encore d’un ensemble grand public qui, il y a quelques mois en arrière, se retrouvait en vente pour moins d’une centaine d’euros. Keepa, une extension pour suivre l’évolution des prix sur Amazon, affiche un prix le plus bas en mai 2025 à 87,99 €. Ça fait mal oui.
En 64 Go, le stock semble être davantage présent, cependant, il faut dire aussi que la RAM est facturée beaucoup plus cher aussi. Comptez 800 € le pack de 2×32 Go en Crucial Pro 5600 MT/s CAS46 chez Top Achat. Du côté d’Amazon, c’est un peu plus compliqué d’y voir clair entre les vendeurs tiers et les kits de 32 Go qui viennent se greffer dans la recherche. Mais globalement, il faudra compter entre 800 € et plus de 1000 € suivant la référence. À noter qu’Amazon ne semble pas vendre lui-même de kit affichant cette capacité.
La cause ?
Dans tous les cas, la facture continue de s’alourdir tandis que les causes de ces prix élevés sont connues : l’IA. Ce secteur exerce une telle pression que les producteurs de mémoire orientent leur production vers des technologies utilisées dans ce secteur délaissant le grand public. Dès lors, il y a une rupture dans l’approvisionnement et les prix montent. C’est là que les constructeurs chinois ont une carte à jouer et HP envisage désormais de se tourner vers CXMT… CXMT qui est d’ailleurs en quête de financement afin d’accroître ses capacités de production.
En farfouillant dans les bases de données douanières, un leaker connu a découvert un manifeste faisant état d’un nouveau processeur AMD haut de gamme. Effectivement, le nom de Ryzen 9 Pro 9965X3D ressort. Si pour le moment, nous n’avons qu’un nom ainsi qu’une courte description du produit, on se doute que le CPU sera haut de gamme. Reste à savoir si AMD compte le lancer ou pas.
Ryzen 9 Pro9965X3D : un CPU pro haut de gamme en AM5 chez AMD repéré en douanes !
Sur le descriptif fourni dans le manifeste, nous apprenons qu’il s’agit là d’un CPU équipé de 16 cœurs et de 32 threads. Avec ceci, le TDP est renseigné et il monte haut puisqu’il est de 170W, rien que ça. Enfin, comme vous vous en doutez, il disposera de mémoire 3D V-Cache comme son appellation X3D le suggère.
Toutefois, on se pose maintenant plusieurs questions comme celle des fréquences par exemple… Bien que l’on se doute qu’elles soient plus conservatrices que celles sur les CPU grand public. Sinon, quid de la quantité de cache ? Sur les gammes grand public, le Ryzen 9 9950X3D affiche 128 Mo de L3 grâce à ses 64 Mo d’origine (32 Mo par CCD) et sa matrice de 3D V-Cache supplémentaire de 64 Mo. Malgré les rumeurs du Ryzen 9950X3D2, rien n’indique que les rouges appliqueraient deux 3D V-Cache sur ce modèle professionnel, nous ne pouvons pas l’exclure non plus.
Enfin, le marquage DVT (Design Validation Testing) dans le manifeste indique que le CPU serait en phase de validation. Il s’agit là d’une phase de test qui sert à éprouver le produit dans des conditions plus larges avant les phases de tests visant la mise en place de la production. Cela signifie donc que les rouges sont à un stade de développement avancé et que les premières phases ont été passées avec succès. Reste à savoir si l’entreprise ira jusqu’au bout avec une commercialisation et si oui, quand ?
Thermalright dévoile un nouveau ventirad avec son Frost Tower 140. Il est ici question d’un dissipateur qui se décline en trois coloris différents avec du noir, du blanc et un modèle qui conserve des ailettes en aluminium sans finition particulière. Toutefois, cette nouvelle référence conservera des dimensions contenues !
Frost Tower 140 : un ventirad Thermalright avec un ventilateur de 140 mm !
Avec ce dissipateur, Thermalright nous fait « une petite blague ». L’entreprise le nomme Frost Tower 140, mais en réalité, il ne dispose que d’un seul ventilateur de 140 mm tout en adoptant les dimensions typiques d’un ventirad en 120 mm… Enfin, presque. En effet, la largeur de ce modèle est de 140 mm tandis que la profondeur affiche 146 mm. Enfin, la hauteur est limitée à 158 mm, de quoi assurer une bonne compatibilité avec les boîtiers du marché.
Autrement, nous retiendrons la présence de deux tours de refroidissement avec des ailettes noires ou blanches ou couleurs aluminium. Ces dernières sont traversées par un total de sept caloducs en cuivre de 6 mm chacun. L’ensemble se rejoint au niveau d’une base en cuivre nickelée. Cependant, la base n’est pas excentrée, cela aurait permis une compatibilité maximale avec la RAM.
Pour éviter trop de problèmes avec la mémoire, Thermalright positionne un ventilateur de 120 mm à l’avant et un modèle de 140 mm au centre. Ainsi, le TL-N12-R9 (120 mm) fonctionne jusqu’à 2400 tr/min, génère un flux d’air de 85,35 CFM et une pression statique de 2,95 mmH2O. Quant au TL-N14-R7, en 140 mm donc, il tourne jusque 1850 tr/min, génère un flux d’air de 120 CFM et une pression statique de 2,4 mmH2O.
Encore une fois, Thermalright assure une bonne compatibilité avec les sockets LGA 1000 et 2000 d’Intel. En AMD, on se contentera d’un support de l’AM4 et de l’AM5.
Actuellement, nous ne connaissons pas encore les prix de vente de ce modèle.
Le PC ne se contente plus d’exécuter : il peut désormais agir
Pendant des décennies, le PC a fonctionné selon une logique simple : l’utilisateur donne une instruction, la machine l’exécute. Avec l’essor de l’IA agentique, ce modèle évolue. Un Agent Computer ne se limite plus à répondre à une requête : il peut recevoir un objectif, découper le travail en plusieurs étapes, mobiliser des outils, vérifier son résultat et poursuivre la tâche sous la supervision de l’utilisateur.
C’est ce passage du simple chatbot au workflow agentique qui change la donne. Résumer chaque matin une pile de rapports, interroger une base documentaire locale, surveiller des fichiers, assister un développeur sur un codebase, préparer un briefing avant une réunion, classer automatiquement des factures ou piloter des automatisations domestiques : ces scénarios peuvent désormais être exécutés directement sur un PC suffisamment équipé.
Et surtout, le modèle et les données peuvent rester sur la machine. Pour les utilisateurs qui manipulent des documents privés, du code propriétaire ou des données client, cette approche permet de réduire la dépendance à une infrastructure distante tout en gardant la possibilité d’utiliser le cloud lorsque le workload l’exige. L’Agent Computer n’oppose donc pas forcément local et cloud : il permet de choisir où exécuter chaque tâche.
Des workflows réels : du développeur à l’assistant personnel
Le meilleur moyen de comprendre l’Agent Computer est de partir des usages. Un agent local peut agir comme un assistant permanent, mais aussi devenir un véritable coéquipier technique. Voici quelques scénarios déjà réalistes sur PC :
Développement et code : analyse d’un repository, génération de tests, debugging, refactorisation, documentation et boucles de validation dans un environnement local.
Documents et recherche : question-réponse sur des dossiers privés, synthèse de rapports, extraction d’informations et création de briefs sans envoyer les documents vers un service cloud.
Automatisation personnelle : tri d’e-mails, calendrier, rappels, suivi de projets, organisation de fichiers, smart home et tâches récurrentes.
Création et productivité : préparation de drafts, génération d’idées, organisation de contenus, assistance à la production et automatisation de tâches répétitives.
Petites entreprises : qualification de demandes, suivi commercial, contrôle de stock, consolidation de données et préparation de rapports internes.
Pour aller plus loin côté agents open source : OpenClaw et Hermes Agent illustrent deux approches d’agents capables d’orchestrer des tâches multi-étapes et des automatisations persistantes.
Le hardware compte : la VRAM n’est que le début
Pour l’IA locale, la VRAM reste un critère central : elle détermine si un modèle peut tenir entièrement dans la mémoire graphique. Mais réduire un Agent Computer à sa quantité de VRAM serait une erreur. L’inférence est une chaîne complète : stockage, transfert PCIe, mémoire système, calcul GPU, bande passante mémoire et refroidissement contribuent tous à l’expérience finale.
Lors du chargement d’un modèle, un SSD NVMe rapide réduit le temps nécessaire pour lire plusieurs dizaines de gigaoctets de poids. Ensuite, ces données transitent vers la VRAM via les lignes PCIe de la carte mère. Une plateforme PCIe 5.0 prend alors tout son sens, particulièrement lorsqu’on travaille avec des modèles volumineux ou que l’on alterne fréquemment entre plusieurs modèles.
Une fois l’inférence lancée, deux métriques deviennent particulièrement parlantes : le time to first token, qui dépend fortement de la phase de calcul initiale, et les tokens par seconde lors de la génération. Cette dernière phase est très sensible à la bande passante mémoire de la carte graphique. Autrement dit, pour un LLM local, les FLOPS ne racontent pas toute l’histoire.
GPU RTX : accélérer les agents et les LLM en local
Pour les workloads Agentic AI, NVIDIA recommande notamment des stacks locales combinant un agent comme OpenClaw avec un backend d’inférence tel qu’Ollama, LM Studio ou llama.cpp. Les GPU GeForce RTX accélèrent les opérations IA via leurs Tensor Cores et bénéficient de l’écosystème CUDA utilisé par ces outils.
À titre indicatif, la logique de dimensionnement proposée par NVIDIA suit la quantité de VRAM disponible :
La carte graphique n’est pas seule. Pour un PC DIY orienté IA locale, la carte mère devient le socle qui relie GPU, stockage NVMe, mémoire et processeur. Une carte mère ASUS basée sur le chipset Intel Z890, associée à un processeur Intel Core Ultra Série 2, apporte une plateforme moderne adaptée aux configurations PC Agent.
Le PCIe 5.0 est particulièrement pertinent dans ce contexte : lors du chargement d’un modèle, les poids passent de la mémoire système vers la VRAM de la carte graphique. Plus le modèle est volumineux ou plus les changements de modèles sont fréquents, plus la bande passante du bus peut influencer la réactivité du workflow. La plateforme doit aussi offrir une bonne capacité d’extension, des SSD NVMe rapides et une alimentation stable pour des charges soutenues.
Pour les configurations avancées, la topologie PCIe de la carte mère devient également stratégique : certains workloads peuvent bénéficier de plusieurs GPU, à condition que la carte mère permette une répartition adaptée des lignes PCIe et que le châssis, l’alimentation et le refroidissement suivent.
Cloud vs IA locale : le TCO devient un argument hardware
L’un des changements les plus importants avec les agents IA est économique. Un chatbot utilisé ponctuellement consomme peu. Un agent, lui, peut planifier, appeler des outils, vérifier son travail et répéter ces étapes des dizaines ou centaines de fois. Lorsque chaque étape consomme des tokens facturés par une API, les coûts peuvent monter rapidement.
Les dépenses cloud sont souvent fragmentées : abonnement principal, crédits API, licences par utilisateur, services spécialisés et nouvelles plateformes agentiques. Pour un usage intensif, le total peut atteindre plusieurs centaines de dollars par mois. C’est précisément là que l’investissement dans un PC local commence à se comparer non plus à un achat gaming, mais à un coût opérationnel récurrent.
EXEMPLE TCO — LE CALCUL DES « MILLIERS » D’ÉCONOMIES Scénario illustratif issu du guide ASUS EdgeUp : à 250 $ par mois de dépenses cloud (abonnements + API), cela représente 3 000 $ par an. Un PC Agent d’environ 3 800 $ est alors amorti en près de 15 mois. Sur cinq ans, 15 000 $ de dépenses cloud sont évitées face à un investissement matériel initial de 3 800 $, soit environ 11 000 $ d’économies potentielles avant prise en compte de l’électricité. À 500 $ par mois, l’amortissement peut intervenir en moins de huit mois et le différentiel potentiel sur cinq ans dépasse 26 000 $. Ces chiffres varient selon l’usage, l’électricité, les services souscrits et la configuration, mais montrent pourquoi le TCO devient un sujet central pour les power users et petites équipes.
Scénario
Cloud / mois
Amortissement indicatif
Économie potentielle / 5 ans
Usage intensif
250 $
~15 mois
~11 000 $
Power user / petite équipe
500 $
< 8 mois
> 26 000 $
À cela s’ajoutent des bénéfices qui ne se résument pas à une ligne de facture : absence de facturation par token et de rate limits liés à un service cloud, réduction de la latence réseau, disponibilité hors connexion et conservation des données sur la machine. Pour des documents sensibles, du code propriétaire ou des données client, ce contrôle peut devenir aussi important que le coût lui-même.
Le cloud conserve néanmoins un avantage pour les modèles frontier les plus lourds ou les besoins très ponctuels. Dans la pratique, l’approche la plus rationnelle peut être hybride : local pour le volume quotidien et les données sensibles, cloud pour les tâches qui exigent ponctuellement un modèle plus massif.
Des frameworks pour passer du LLM à l’agent
Le hardware n’a de valeur que s’il est simple à exploiter. L’écosystème logiciel s’est donc considérablement enrichi : des outils d’inférence comme Ollama, LM Studio et llama.cpp permettent de charger rapidement un modèle local, tandis que des frameworks agentiques ajoutent la planification, les outils, la mémoire et les automatisations persistantes.
Ollama — déployer et exécuter simplement des modèles locaux.
LM Studio — tester des modèles locaux avec une interface accessible et un serveur local.
cpp — moteur d’inférence local optimisé et largement utilisé.
OpenClaw — agent local-first capable de travailler avec fichiers, applications et skills.
ASUS Zenni Claw : rendre l’Agentic AI plus accessible
ASUS Zenni Claw apporte une approche plus guidée de l’Agentic AI : au lieu de partir d’une configuration complexe ou d’un prompt vide, la plateforme propose une mise en route assistée, des skills prêts à l’emploi et des workflows orientés tâches pour le travail, les voyages et l’organisation quotidienne. L’idée est de passer plus rapidement de l’intention au résultat, tout en permettant à l’utilisateur de suivre les étapes et de garder le contrôle sur ce que l’agent exécute.
Son architecture hybride peut mobiliser le traitement local ou le cloud selon la tâche, les capacités de la machine, la disponibilité des modèles et les préférences de l’utilisateur. Cette flexibilité permet de rechercher le bon équilibre entre réactivité, confidentialité, performances et maîtrise des coûts API, plutôt que d’imposer un mode d’exécution unique.
Zenni Claw complète ainsi les stacks open source présentées plus haut sans les remplacer : il constitue une porte d’entrée plus accessible vers les agents multi-étapes, tandis que les utilisateurs avancés restent libres d’explorer OpenClaw, Hermes Agent, Ollama, LM Studio ou llama.cpp. La disponibilité et certaines fonctions dépendent toutefois des appareils ASUS pris en charge et de leur configuration.
Construire son Agent Computer : partir du workflow, pas de la fiche technique
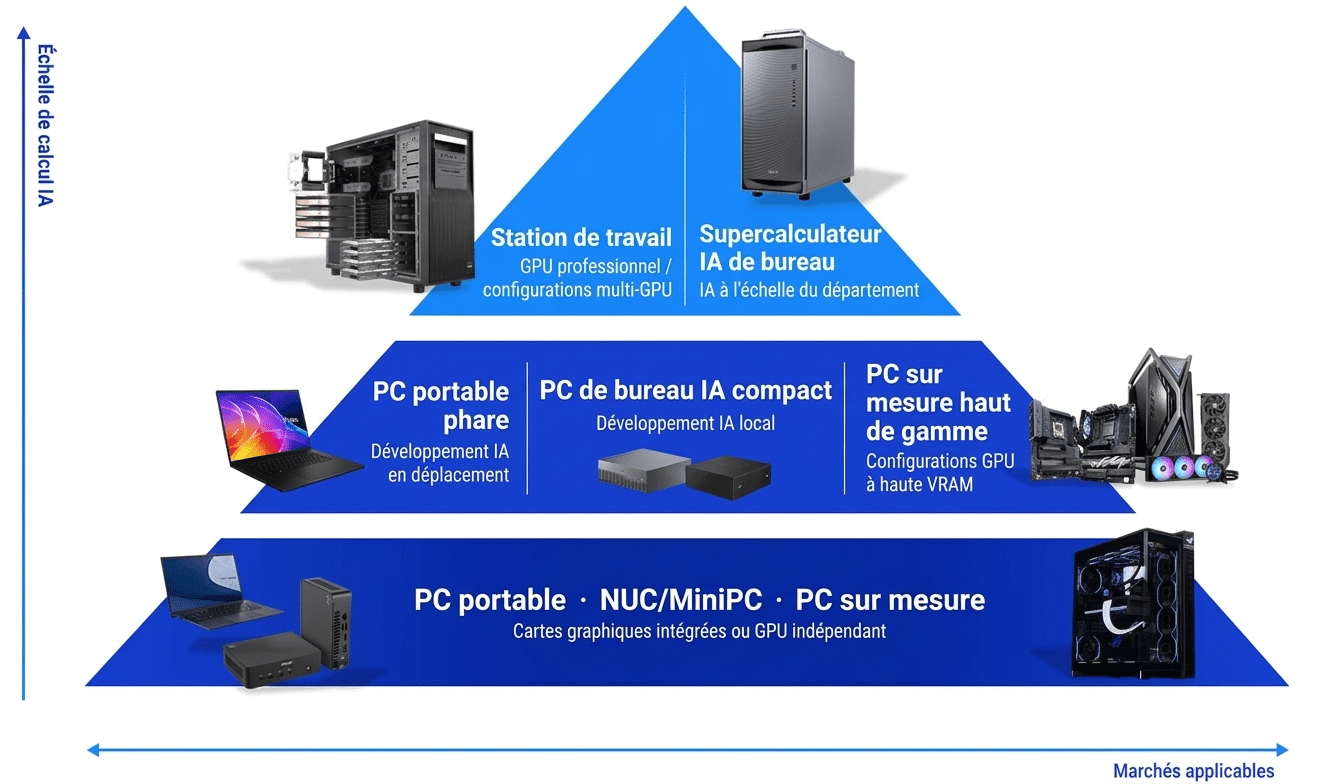
Il n’existe pas une configuration universelle. Le bon PC Agent est celui qui correspond au modèle et aux tâches que l’on souhaite réellement exécuter. Pour un assistant local réactif, une carte graphique 16 Go et 32 Go de RAM système constituent aujourd’hui un point de départ cohérent. Pour des modèles plus volumineux, davantage de VRAM, une plateforme plus évolutive ou du multi-GPU deviennent pertinents.
Carte mère adaptée x8/x8, PSU et cooling renforcés
Agrégation de VRAM et workloads complexes
Et si votre prochain projet devenait un véritable Agent Computer ?
ASUS France prolonge cette logique avec l’ASUS Agent Computer Challenge, sous la signature « Votre PC. Votre Agent. ». Ce challenge local s’adresse aux passionnés d’IA et de hardware, gamers / PC builders, étudiants, développeurs, ingénieurs et professionnels de l’IA. L’objectif n’est pas de récompenser la simple popularité d’un projet, mais de faire émerger des démonstrations concrètes d’Agentic AI et d’IA locale : un agent capable de recevoir un objectif, d’utiliser des outils, d’enchaîner plusieurs étapes et de produire un résultat réel sur PC.
Trois niveaux structurent les candidatures : AI Entry pour un premier concept ou une première expérimentation, Developer pour un prototype ou workflow fonctionnel, et Advanced / High-End pour les architectures les plus ambitieuses. Les participants restent libres de choisir leurs modèles et frameworks : Zenni Claw peut servir de point d’entrée guidé, mais OpenClaw, Hermes Agent, Ollama, LM Studio, llama.cpp ou d’autres stacks open source restent pleinement pertinents.
L’évaluation privilégie avant tout la pertinence Agentic / Local AI et la faisabilité technique (30 % chacune), puis l’originalité et le potentiel du projet (20 %) ainsi que l’adéquation hardware et la clarté de la proposition (20 %). La portée sociale n’entre pas dans le score du jury. Pierre Bittner intervient comme technical reviewer. Les candidatures sont ouvertes jusqu’au 6 décembre 2026.
Pour les utilisateurs qui exploitent l’IA chaque jour, la question n’est donc plus seulement « quel modèle est le meilleur ? », mais aussi « où ai-je intérêt à l’exécuter ? ». À mesure que les modèles open-weight progressent, que les frameworks agentiques gagnent en maturité et que les GPU accélèrent des workflows toujours plus complexes, le PC DIY retrouve une place centrale dans cette équation.
GPU GeForce RTX, plateforme ASUS Z890 avec Intel Core Ultra Série 2, stockage NVMe, mémoire et software agentique forment ensemble une base évolutive pour expérimenter aujourd’hui et construire les workflows de demain.
POUR ALLER PLUS LOIN ASUS Agent Computer France — comprendre les scénarios, explorer le hardware et accéder aux ressources pour démarrer avec l’IA locale.
La RTX 5090 Lightning de MSI fait de nouveau parler d’elle puisque la carte sera déclinée en plusieurs versions. En effet, ce modèle bénéficiera de versions Z et X dont les fréquences seront amenées à varier d’une version à l’autre. Forcément, le modèle Z tournera à des fréquences plus importantes que la déclinaison X.
RTX 5090 Lightning : un modèle Z plus rapide… Genre beaucoup !
Pour rappel, lors du CES, MSI dévoilait sa nouvelle RTX 5090 Lightning. Cette carte se destine principalement aux passionnés, mais aussi aux personnes qui aiment mettre les mains dans le matos et pousser les fréquences. D’ailleurs, le PCB est particulièrement travaillé et embarque 40 phases d’alimentation ! Le reste de la carte est également bien construit avec un système de refroidissement de type watercooling tout-en-un en 360 mm. La coque de la carte met en avant un écran massif, bref, la carte d’exception qui a, d’ailleurs, déjà fait tomber des records d’overclocking.
Mais en dehors de l’overclocking, ce modèle sera disponible en deux déclinaisons : X et Z. Parmi ces deux versions de la carte, la Z sera la plus rapide et pas que de 25 MHz comme on peut le voir de temps à autre. Non, là il y a une véritable différence de 165 MHz tout de même. Ainsi, la Z tourne à 2775 MHz en activant un profil spécifique dans MSI Center tandis que la X affiche 2610 MHz. Dans tous les cas, face aux fréquences d’origine, 2407 MHz pour rappel, cela représente des gains de 8,43% dans le cas de la X et de 15,3% dans le cas de la Z ce qui n’est pas rien !
Enfin, notre confrère souligne la présence d’un label OCER à la fin du numéro de produit… Label que nous étions les premiers à repérer lors de la parution des photos de la carte. Pour l’instant difficile encore de dire à quoi il correspond.
Au CES, la marque de mini-PC Minisforum exposait une nouvelle carte mère assez singulière : la BD995M. Cette nouvelle carte mère exploite un processeur AMD Ryzen mobile monté par défaut ainsi qu’un chipset X870… Un combo loin d’être anodin. Le but de la manœuvre ? Proposer une connectique riche malgré l’utilisation d’un CPU de PC portable !
BD995M : un CPU mobile et un chipset X870 !
Direction Minisforum qui était présent au CES en exposant une nouvelle carte mère. Cette dernière est pour le moins originale puisqu’elle combine un CPU de PC portable ainsi qu’un chipset X870. Par conséquent, la carte est déclinée avec deux processeurs au choix : un Ryzen 9 9955HX ou un Ryzen 9 9955HX3D. Nous avons ici affaire à des modèles haut de gamme avec leurs 16 cœurs et 32 threads. Le X3D dispose, comme son nom l’indique, d’une matrice de 3D V-Cache supplémentaire permettant la présence de 128 Mo de L3. Quant aux fréquences, nous sommes à 5,4 GHz en turbo dans les deux cas.
L’utilisation d’un chipset X870 sur ce type de carte mère est inhabituelle, mais cela permet de proposer une connectique complète. On parle ici d’un ajout d’USB4 par exemple. Autre élément à prendre en compte, la présence de deux PCIe. Sinon, la partie stockage s’appuie sur deux ou trois M.2 complétés par deux SATA.
L’esthétique est globalement soignée, et nous constatons la présence d’éclairage aRGB sur le dissipateur des VRM. La partie mémoire met en avant deux slots en DDR5, au format DIMM et non SO-DIMM comme on peut le voir parfois. Enfin, pour le branchement, nous retrouvons un ATX 24 broches couplé à deux ports CPU 8 pins, tandis que la marque conserve le système de montage typique des plateformes AM5.
Pour l’instant, si les prix ne sont pas connus, ce modèle devrait être lancé durant la première moitié de 2026.
La RTX 5090 Matrix est clairement une carte haut de gamme à destination des passionnés de la marque ASUS. C’est également une carte commémorative qui célèbre les 30 ans de la marque. Cependant, il y a eu un petit couac dans sa distribution puisque ce modèle a accusé des retards pour « améliorer la qualité ». D’après la dernière vidéo de Der8auer, il semblerait que cette amélioration de qualité concerne l’application et la manière dont le métal liquide est isolé !
ASUS soigne l’application du métal liquide de sa RTX 5090 Matrix !
Dans l’ensemble, la carte ne profite d’aucun réel changement que ce soit au niveau de ses dimensions ou de son système de refroidissement. Les caractéristiques restent également les mêmes, les fréquences ne changent pas, etc. Cependant, c’est à l’ouverture que l’on s’aperçoit des changements opérés par la marque. En effet, le métal liquide est alors bien mieux appliqué et isolé. Lors de son premier démontage, Der8auer constatait un simple anneau de pâte entourant le GPU pour éviter que le métal ne coule de partout. Cependant, cette méthode semblait artisanale et appliquée à la main.
La nouvelle révision de la carte bénéficie d’une application bien plus soignée et qualitative. Déjà, le die de la carte est entouré par un anneau de pâte ouvert, renforcé par deux couches de pâte. Ensuite, la composition du métal liquide semble évoluer légèrement et pourrait bien contenir de la graisse de silicone. Le but ? Faciliter l’application de manière industrielle. Outre la qualité de l’isolation du TIM, son application est plus soignée et uniforme.
En soi, c’est une bonne nouvelle puisque cela permet une meilleure tenue dans le temps. Rappelons que l’utilisation de métal liquide ne se fait pas à la légère puisqu’il s’agit d’un matériau conducteur qui, en cas de débordement, peut conduire à des courts-circuits ce qui serait catastrophique pour le matériel. De plus, avec les cycles de chauffe/refroidissement, ce dernier peut être amené à bouger. Rappelons que la RTX 5090 Matrix peut consommer jusqu’à 800W en charge !
VIK-On, un modder russe, dont nous avons déjà parlé pour le mod d’une RTX 4090 24 Go en 48 Go, fait de nouveau parler de lui. En effet, avec les prix absurdes de la mémoire actuellement, ce dernier a créé lui-même sa propre RAM. Comment ? En récupérant des puces DDR5 et en les soudant sur un autre PCB. Puis, il flash le kit avec les profils XMP d’un autre constructeur et le tour est joué. Au passage, il réalise une belle économie !
VIK-On se fait sa propre RAM à des prix abordables pour le coup !
Les prix de la RAM sont zinzins et certains rusent pour faire baisser le montant de la facture. C’est notamment le cas de VIK-On, modder russe de talent. Ce dernier crée ses propres sticks simplement en cannibalisant des puces mémoires d’autres modules RAM. Pour cela, il achète donc des modules SO-DIMM de laptop, qu’il paye $100 pièce environ. Il dessoude les puces mémoires, qu’il repositionne ensuite sur un PCB vierge acheté en Chine même pas $10. Ne reste ensuite plus qu’à installer un dissipateur qui se retrouve pour une bouchée de pain sur AlieExpress (dans les $5) et le tour est joué.
Mais les choses ne s’arrêtent pas là puisque le modder va même jusqu’à flasher un firmwarecustom en provenance d’ADATA. Cette opération permet à la carte mère de reconnaître un profil XMP à 6400 MT/s et à l’appliquer d’un click depuis le bios. Le pire, c’est que tout fonctionne bien.
[affilizz-publication id= »bhx04cu »]
Cependant, si l’on pouvait être tenté par la manipulation, il faut garder à l’esprit qu’il faut du matériel et des compétences en soudure électronique. Une fois les puces retirées de leur ancien module, il faut les nettoyer puis refaire les billes de soudure des modules mémoire via une station spécifique. Ce n’est clairement pas à la portée du premier venu. Mais pour quiconque a le matériel ainsi que les compétences, ce sont de belles économies qui peuvent être réalisées. En l’état, son kit de 32 Go DDR5 à 6400 MT/s ne lui aura coûté « que » $218 contre 485 € en France pour de la mémoire basique. Même en mettant ces histoires de conversion monétaire et de TVA de côté, on devine que l’économie réalisée est importante.
Du côté de Valve, nous apprenons que deux revendeurs tchèques ont publié la page produit de la Steam Machine. Cette dernière, disponible en deux variantes de stockage, s’affiche chez les revendeurs Smarty.cz et Alza. Quant aux prix, il faudra regarder dans le code source de la page pour les retrouver. Dans tous les cas, nous sommes à moins de 1000 €.
Steam Machine : La console de Valve affichée en République tchèque !
Dans les grandes lignes, la console de salon de Valve se retrouve affichée sur des sites de vente en Europe Centrale. Deux variantes de la console sont proposées, l’une en 512 Go de stockage, l’autre en 2 To. Quant aux prix, ces derniers ne sont pas directement affichés puisqu’il faut regarder dans le code source de la page pour avoir une idée des prix. Mais sans rentrer dans ces histoires de conversion de devise puisque, malgré son appartenance à l’UE, la République tchèque n’utilise pas l’Euro, les prix en dollars sont d’environ $835 pour la version 512 Go contre $925 pour le modèle 2 To.
Nous avons à nouveau affaire aux classiques prix placeholder puisque, rappelons-le, Valve n’a toujours pas annoncé de prix de vente pour ses consoles de salon. Dès lors, il ne s’agit que d’estimations de la part des revendeurs tchèques en vue d’une commercialisation de la console. Ces prix reflètent les attentes des commerçants en termes de coûts et de marges réalisables.
Cependant, ce ne sont que des estimations et parfois, elles sont trop hautes, et d’autres trop basses. On a déjà le cas de composants affichés à des prix déraisonnablement élevés en amont d’une commercialisation, c’est la raison pour laquelle il est difficile de s’y fier. En revanche, c’est un bon indicateur d’un lancement à venir. Plus on voit fleurir ce type de fiche en ligne, plus on peut supposer d’un lancement proche.
Quoi qu’il en soit, avec les prix de la RAM actuels, il est difficile de faire une estimation fiable. Effectivement, nous ne savons pas quelle quantité de mémoire Valve a pu sécuriser en amont. Ce sera donc la surprise le jour de l’annonce.