Le coup de tonnerre violent qui a précipité le départ de Jensen Huang n’est peut-être que l’annonce d’une grosse tempête. Avec le recul, la succession de révélations d’aventures extraconjugales (trois à ce jour) laisse tout de même la place à un drôle de sentiment. Sans sombrer dans le complotisme, j’ai beaucoup de mal avec la soudaineté de tout ça et je ressens un profond sentiment d’inconfort. En plus de ces histoires sentimentales, s’ajoute une problématique de sécurité nationale particulièrement sensible aux États-Unis qui va occuper les politiques locaux. Mais, à cet instant, je ne peux m’empêcher de penser à cette « bulle » de l’IA à laquelle tout le monde pense sans vouloir trop développer pour éviter de se faire peur. Cependant, on ne peut négliger le poids que cette industrie représente sur les marchés US notamment. Et un autre événement va nous le rappeler dans les prochaines heures : l‘introduction en Bourse (IPO) d’Anthropic, qui est l’un des événements financiers majeurs de l’année 2026. Mais revenons-en aux chiffres. Les dépenses liées à l’IA représentent près de 30 % de la croissance du PIB américain entre 2025 et 2026. Personne ne contestera la révolution de l’IA et le bouleversement qu’elle est en train de générer, mais c’est le côté spéculatif de cette économie qui interroge. Pour nous (et pour ceux qui nous lisent), ce sont aussi les répercussions sur les prix de l’industrie du PC et plus généralement de la tech qui nous préoccupent.
Nvidia et les financements circulaires : une pyramide de Ponzi ?
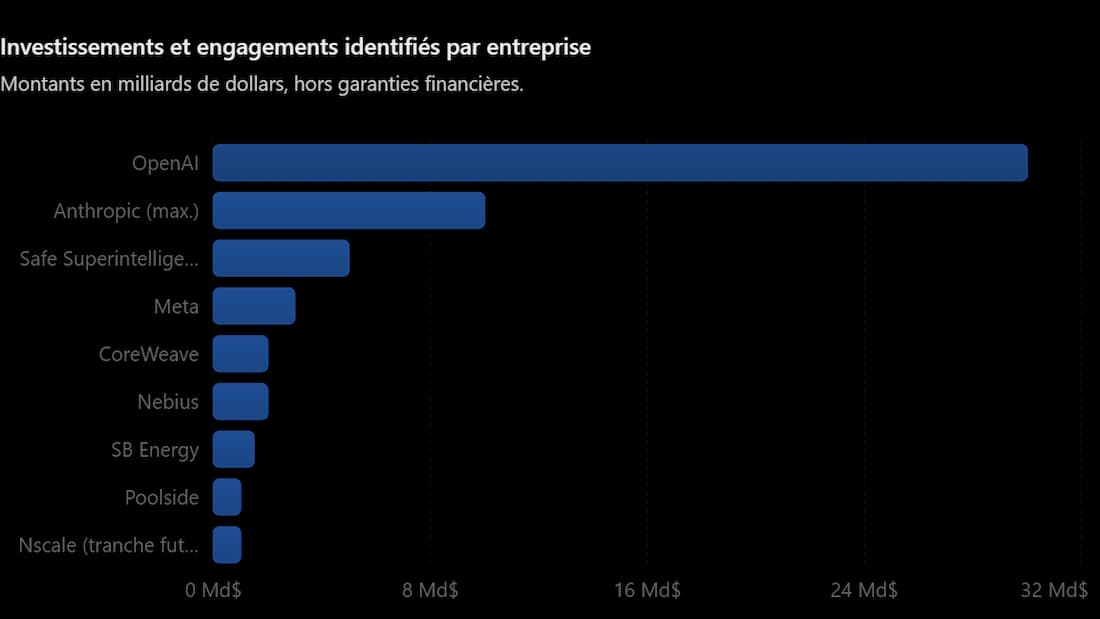
Et voilà d’où pourrait venir le problème. Jusque-là, Nvidia ne se contentait pas de vendre des GPU aux géants du cloud. Il participait également au financement de leurs infrastructures, en investissant dans des entreprises spécialisées dans l’IA et en garantissant certains de leurs engagements financiers (une sorte de crédit fournisseur en fait). Cette stratégie a contribué au développement rapide des datacenters et a permis à Nvidia de faciliter des ventes. Elle soulève désormais plusieurs questions. Selon des informations du Wall Street Journal, Nvidia aurait notamment soutenu certains clients pour leur permettre d’acquérir ses GPU, alors même que les capacités de financement de ces derniers étaient plus qu’incertaines. L’autre facette de cette stratégie, c’est l’explosion des engagements d’approvisionnement de Nvidia, passant de 119 à 279 milliards de dollars en un trimestre. Le groupe aurait donc cherché à sécuriser d’importants volumes de composants, notamment de mémoire, tout en contribuant financièrement au développement de leur marché. Une situation qui a fortement contribué à « assécher » le marché de la mémoire. Pour faire simple, Nvidia investit dans des entreprises qui exploitent des infrastructures d’intelligence artificielle. Ces dernières utilisent ensuite une partie de leurs financements pour acheter des GPU Nvidia et développer leurs capacités de calcul. Ce mécanisme peut accélérer l’adoption des nouvelles architectures, mais il crée aussi une interdépendance entre le fabricant et ses clients. Ce sont aussi ces garanties qui font dire à certains que Nvidia pourrait avoir alimenté une bulle au moyen d’investissements qualifiés de circulaires.
Le projet de centres de données d’OpenAI, dans l’Ohio, illustre l’ampleur des sommes concernées. Nvidia y a accordé des garanties plafonnées à 105 milliards de dollars pour accompagner le développement de ce chantier. Par ailleurs, comme mentionné plus haut, Nvidia a officiellement déclaré 279 milliards de dollars d’engagements d’approvisionnement au 26 juillet 2026, principalement dédiés à la mémoire. La question qui se pose alors est de savoir si une partie des financements accordés par Nvidia à des entreprises d’IA aurait pu contribuer à absorber des volumes commandés en excès.
Ne pas jeter le bébé avec l’eau du bain…
Dans cette histoire de gros sous, aucun élément ne peut écorner la domination technologique de Nvidia. Une domination construite en grande partie grâce à la vision de Jensen Huang alors qu’avant lui, personne ne misait sur cette industrie. La Chine est encore loin, la concurrence d’AMD est là, mais à distance. Le leadership technologique des verts est donc tout sauf menacé. Cependant, si les pratiques risquées et cette « économie circulaire » viennent à se confirmer, certains voudront clairement imputer une bonne partie des perturbations du marché à Nvidia. L’arrivée de Colette Kress à la tête de Nvidia pourrait être le signal d’un retournement de la politique de financement des besoins de ses clients. Alors que la rentabilité des entreprises de l’IA est actuellement un sujet « secondaire » par rapport à la course à l’armement (en GPU), ce changement radical de stratégie pourrait fragiliser plusieurs start-up, notamment celles qui dépendent de capitaux importants pour installer leurs infrastructures. Par ricochet, cela pourrait faire fortement baisser la demande en GPU. Mais nous sommes là sur des hypothèses. Il est évident que beaucoup d’analystes ont ces hypothèses en tête depuis ces dernières heures. Voilà pourquoi l’IPO d’Anthropic est à observer. Si cette opération déçoit, les secousses risquent de s’amplifier.
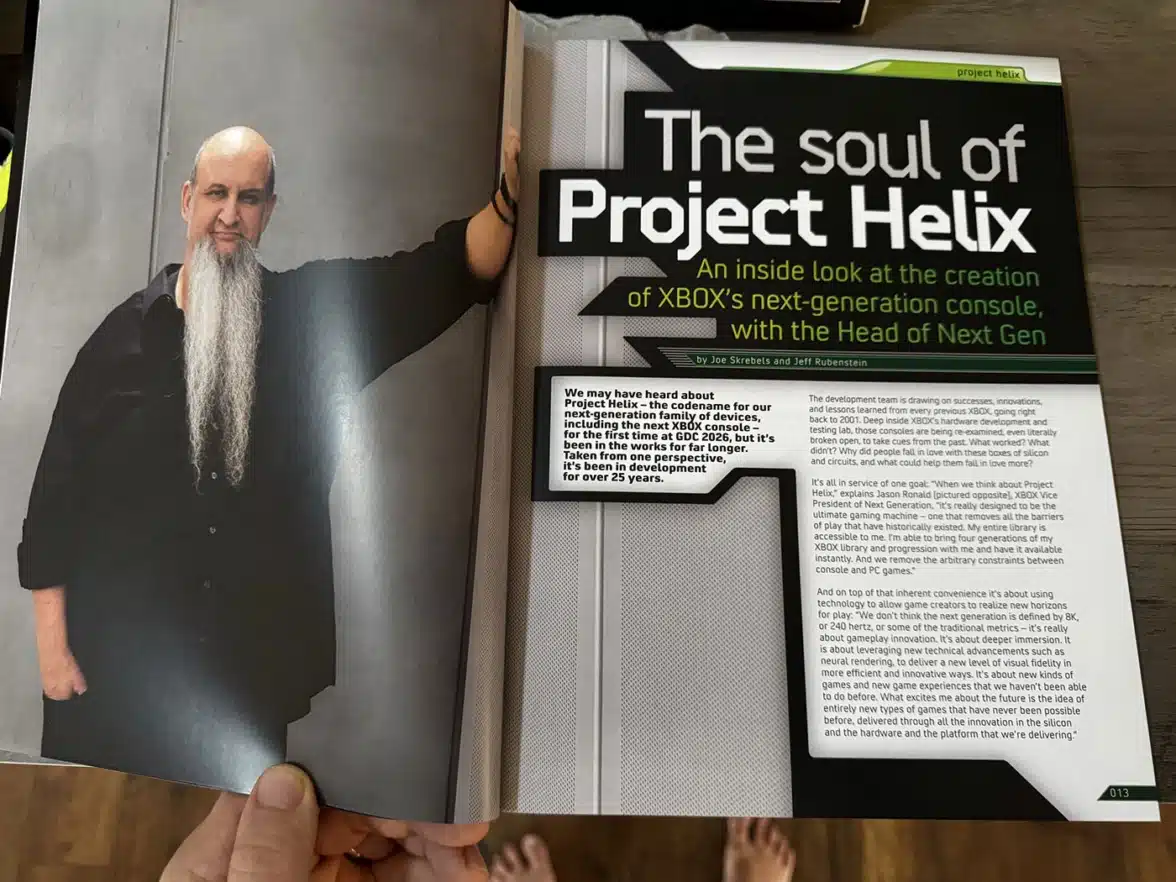
À l’occasion des célébrations marquant le vingt-cinquième anniversaire de la marque Xbox, Asha Sharma, dirigeante de la division Xbox chez Microsoft, a adressé un message à l’ensemble de la main-d’œuvre mondiale. Dans cette communication, elle relie un retour en arrière sur l’histoire du jeu vidéo du groupe à des objectifs stratégiques pour la génération de consoles à venir, actuellement désignée sous le nom de code Project Helix.
Sharma rappelle l’ancrage profond de Microsoft dans le secteur du divertissement interactif, en partant du texte-aventure Microsoft Adventure de 1979, en passant par Minesweeper (le démineur) et Flight Simulator, jusqu’à la sortie de la première Xbox en 2001 et le lancement d’Xbox Live en 2002. Elle illustre l’évolution fulgurante des capacités techniques, citant l’exemple de Flight Simulator qui est passé d’une version aux 16 couleurs et 160 ko de mémoire à un titre ultra-réaliste consommant plus de 2,5 pétaoctets de données. Actuellement, plus d’un milliard de personnes jouent chaque année à des titres développés par Microsoft.
Une cinquième génération confirmée mais floue
En ce qui concerne le matériel futur, Sharma confirme officiellement que la cinquième génération de consoles est en cours de développement, succédant aux quatre générations précédentes. Elle identifie deux missions centrales pour cette nouvelle ère : la mise à disposition de jeux de grande envergure et la création d’un matériel distinctif. Cependant, la communication de l’anniversaire ne fournit aucune spécification technique concrète, aucun prix ni date de publication pour la prochaine console Xbox.
Il est notoire depuis des annonces antérieures de la part de Microsoft que le système, baptisé Project Helix, reposera sur un (SoC) AMD custom. Les premières versions alpha de ce matériel devraient être livrées aux studios de développement au cours de l’année 2027. Aucune information supplémentaire n’a été divulguée dans ce communiqué spécifique. On peut dire que depuis quelques semaines, les pistes se sont brouillées concernant le Projet Helix. pendant un long moment, on a pensé à la fusion entre PC et console avec Windows au centre du jeu. Les choses semblent avoir changé…
Magazine distribué lors de l’évènement Xbox ces dernières heures (Photo DestinLegarie).
Les mots les plus récents officiellement tenus au sein de la division Xbox, n’aident pas à se faire une idée à cet instant. Ainsi, l’équipe Xbox souhaite éliminer les « contraintes arbitraires entre les jeux console et PC » grâce au Project Helix. Cette initiative vise à permettre aux joueurs d’accéder à leurs jeux Xbox, à leur progression et à leur historique sur différentes plateformes, tout en facilitant l’accès aux jeux PC. Il est crucial de noter que le Project Helix n’est donc pas, à priori, un PC de salon déguisé en Xbox, contrairement à certaines rumeurs et interprétations courantes.
L’impact de l’intelligence artificielle sur la création
L’intelligence artificielle joue également un rôle sous-jacent dans ce message. Sharma observe que la capacité à créer de grands jeux dépendait autrefois du nombre de personnes, du capital et des ressources disponibles. Aujourd’hui, une seule personne possède des compétences qui nécessitaient autrefois de vastes équipes ou même de grandes nations. Selon elle, de petits groupes seront capables de créer des mondes qui exigeaient auparavant des centaines de développeurs et des centaines de millions de dollars. Parallèlement, ses plus grands studios pourront poursuivre des ambitions dépassant largement les jeux actuels.
Elle perçoit l’avenir du jeu vidéo dans ces débuts et croit que de petites équipes dotées de grandes idées pourraient à l’avenir révolutionner le paysage du jeu. « Notre responsabilité est de développer d’excellents jeux et un matériel unique », a déclaré Asha Sharma dans le message diffusé.
Il y a quelques jours, nous nous sommes rendus à Paris pour participer à l’événement Enterprise AI, à l’invitation d’ASUS et de NVIDIA. L’objectif était plutôt simple: une exploration de l’univers des infrastructures dédiées à l’intelligence artificielle, comprenant la présentation de nouveaux serveurs, des technologies connexes et des défis auxquels sont confrontées les entreprises. Cette journée nous a également donné l’occasion de découvrir divers cas pratiques de l’IA, dont un, particulièrement captivant, dans le domaine médical.
Pour la majorité de la communauté OCC, ASUS reste avant tout associé aux cartes mères, aux GPU, aux PC portables et, bien entendu, à sa gamme ROG. Ce que l’on sait moins, c’est que le fabricant taïwanais possède aussi une activité conséquente dans les serveurs professionnels et les infrastructures de calcul intensif. Évidemment, par les temps qui courent, cette activité est particulièrement précieuse. En fait, cela tombe plutôt bien puisque c’est justement cette branche de l’entreprise qui était à l’honneur lors de l’événement ASUS with NVIDIA Enterprise AI.
Pour l’occasion, ASUS avait convié plusieurs partenaires de son écosystème, avec NVIDIA évidemment, mais également ALSO, le Français 2CRSi et PrediSurge, une entreprise spécialisée dans les applications médicales de l’intelligence artificielle.
Au-delà des annonces matérielles, cette rencontre avait surtout pour ambition de montrer comment les différentes briques technologiques s’assemblent pour former des solutions utilisables par les professionnels. Car si les modèles génératifs monopolisent aujourd’hui une bonne partie de l’actualité, leur fonctionnement repose sur des moyens matériels considérables. Entraîner ces modèles, les faire fonctionner quotidiennement ou déployer des agents capables d’exécuter des tâches demande des ressources informatiques importantes, mais aussi une organisation technique particulièrement rigoureuse. Autrement dit, il ne suffit pas d’empiler des GPU NVIDIA dans des baies de serveurs pour obtenir une AI Factory opérationnelle. Et c’est précisément ce qu’ASUS souhaitait expliquer.
Alimenter, refroidir, connecter et administrer : les quatre grandes difficultés des AI Factories
ASUS a commencé sa présentation en revenant sur les principaux obstacles rencontrés lors de la création d’une infrastructure IA de grande envergure. Quatre domaines concentrent l’essentiel des difficultés : l’électricité, la dissipation thermique, les communications entre équipements et l’automatisation. Le premier concerne évidemment l’approvisionnement énergétique. À partir du moment où une installation nécessite une puissance de l’ordre du mégawatt, les besoins ne sont plus comparables à ceux d’une salle informatique traditionnelle. Pour donner un ordre de grandeur, 1 MW correspond à 1 000 kW. Or, certaines infrastructures peuvent réclamer plusieurs dizaines de mégawatts. Il faut alors prévoir une distribution électrique dimensionnée en conséquence, capable d’absorber les variations de charge tout en assurant une alimentation continue des équipements. La maîtrise des températures constitue le deuxième point critique. Les accélérateurs graphiques consomment énormément d’énergie, laquelle finit très largement dissipée sous forme de chaleur. Avec la hausse de leur puissance et la concentration toujours plus importante de composants dans chaque rack, la ventilation classique devient progressivement insuffisante. C’est pourquoi le refroidissement liquide occupe désormais une place centrale dans les architectures les plus denses. Cette solution demande toutefois une installation spécifique, comprenant notamment des circuits de circulation du liquide, des échangeurs thermiques, des équipements de distribution et des dispositifs chargés de contrôler les températures en permanence. Vient ensuite la circulation des données, troisième difficulté identifiée par ASUS. Dans une infrastructure IA, les GPU ne travaillent pas isolément. Ils échangent continuellement des informations entre eux, avec les CPU, la mémoire et les unités de stockage. Même avec des accélérateurs extrêmement puissants, une architecture peut perdre une partie de son efficacité si ses communications internes ne suivent pas. La bande passante, le temps de latence et la qualité des interconnexions deviennent donc aussi importants que la puissance de calcul. C’est notamment le rôle de technologies comme NVIDIA NVLink, InfiniBand ou les réseaux Ethernet à très haut débit. Enfin, l’administration automatisée constitue le quatrième enjeu. Avec des installations pouvant réunir plusieurs milliers de composants, impossible d’envisager une supervision entièrement manuelle. Les exploitants doivent disposer d’outils capables de détecter les incidents, surveiller le matériel, installer les logiciels, distribuer les tâches et contrôler la consommation énergétique. Une AI Factory doit donc être pensée pour fonctionner sur la durée. Sa capacité à évoluer, sa fiabilité et ses coûts d’exploitation comptent autant que les performances affichées lors de son installation. Ces quatre contraintes structurent aujourd’hui la stratégie d’ASUS sur le marché professionnel.
ASUS accélère son développement international autour des infrastructures IA
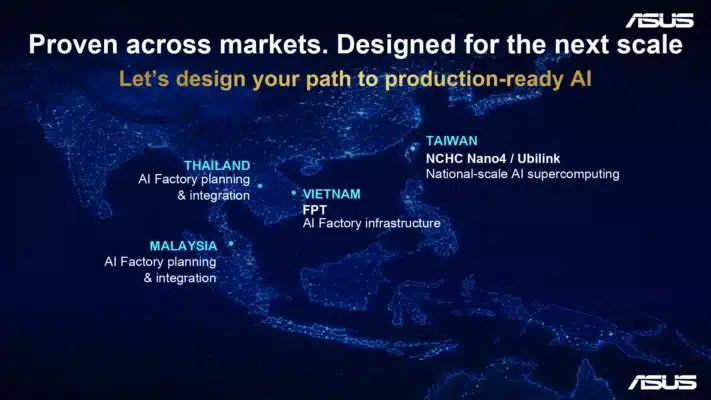
Pour montrer l’ampleur de ses activités, le fabricant nous a présenté plusieurs de ses implantations industrielles, ainsi que des projets menés dans différents pays asiatiques. ASUS ne se contente désormais plus de produire les équipements qui composent les serveurs. L’entreprise intervient également dans la préparation des projets, l’assemblage des systèmes et leur intégration au sein d’infrastructures complètes. En Thaïlande, le groupe dispose d’activités d’intégration et participe au développement d’AI Factories. En Malaisie, des installations comparables sont en préparation. Le Vietnam fait également partie des marchés concernés, avec notamment des projets d’infrastructures IA développés autour du groupe technologique FPT. Cette implantation régionale permet au constructeur de disposer de moyens industriels et techniques plus proches de ses clients, tout en accompagnant la multiplication des projets liés à l’intelligence artificielle. Mais c’est à Taïwan qu’ASUS nous a présenté l’un de ses exemples les plus significatifs. Le constructeur a participé à la réalisation de Nano4, un supercalculateur destiné au National Center for High Performance Computing de Taïwan. Cette machine associe des serveurs ASUS à des accélérateurs NVIDIA H200, reliés par un réseau InfiniBand disposant d’une bande passante particulièrement élevée. Nano4 s’est notamment distingué dans le classement TOP500 des supercalculateurs mondiaux. Une réalisation qui démontre les compétences d’ASUS dans le déploiement de systèmes de grande taille, où il faut concilier performances et efficacité énergétique. Autre projet évoqué pendant la présentation, Ubilink, également implanté à Taïwan et consacré au calcul intensif. ASUS possède par ailleurs un laboratoire spécialisé dans les infrastructures IA, installé à proximité de son siège de Taipei. Cette structure sert à tester les configurations complètes avant leur livraison, notamment pour vérifier leur comportement thermique, le bon fonctionnement du matériel et la fiabilité de l’ensemble. Une démarche indispensable lorsqu’on sait qu’une défaillance sur une installation de cette taille peut avoir des conséquences autrement plus importantes que sur un serveur isolé.
ASUS Infrastructure Deployment Center : bien plus que de simples serveurs
L’un des messages importants de cette présentation concernait la volonté d’ASUS de proposer autre chose que du matériel. L’entreprise travaille en effet sur plusieurs solutions logicielles destinées à accompagner ses infrastructures tout au long de leur utilisation. C’est notamment le rôle de l’ASUS Infrastructure Deployment Center, une plateforme conçue pour simplifier la préparation des installations, leur déploiement et les différentes opérations nécessaires à leur mise en service. À cette première couche viennent s’ajouter des fonctions de supervision, de gestion des ressources et d’orchestration. L’idée est de centraliser un maximum d’opérations afin de faciliter le travail des équipes chargées de l’exploitation. Prenons l’exemple d’une entreprise qui commercialise de la puissance de calcul. Elle doit être capable de réserver des ressources pour ses clients, suivre leur consommation, gérer leurs autorisations et disposer des informations nécessaires à la facturation.Sans outils adaptés, ce type d’exploitation devient rapidement compliqué. ASUS développe également son environnement AI HUB, pensé pour faciliter l’utilisation des modèles et des applications reposant sur l’intelligence artificielle, notamment les agents autonomes. Un autre sujet abordé concerne le Harness Engineering. Ce terme désigne l’ensemble des éléments logiciels qui entourent un modèle d’IA et lui permettent d’agir au sein d’un système réel. Cela comprend l’accès à différents outils, la conservation du contexte, le contrôle des actions effectuées, la gestion des autorisations ou encore la vérification des résultats obtenus. On dépasse donc le simple chatbot capable de produire une réponse. Le but est de disposer d’une IA susceptible d’enchaîner plusieurs opérations de manière cohérente, dans un environnement dont le fonctionnement reste maîtrisé. ASUS cherche ainsi à couvrir toute la chaîne, depuis les composants matériels jusqu’aux logiciels nécessaires pour exploiter les infrastructures.
NVIDIA Vera Rubin, Blackwell Ultra et HGX : ASUS dévoile ses nouvelles plateformes
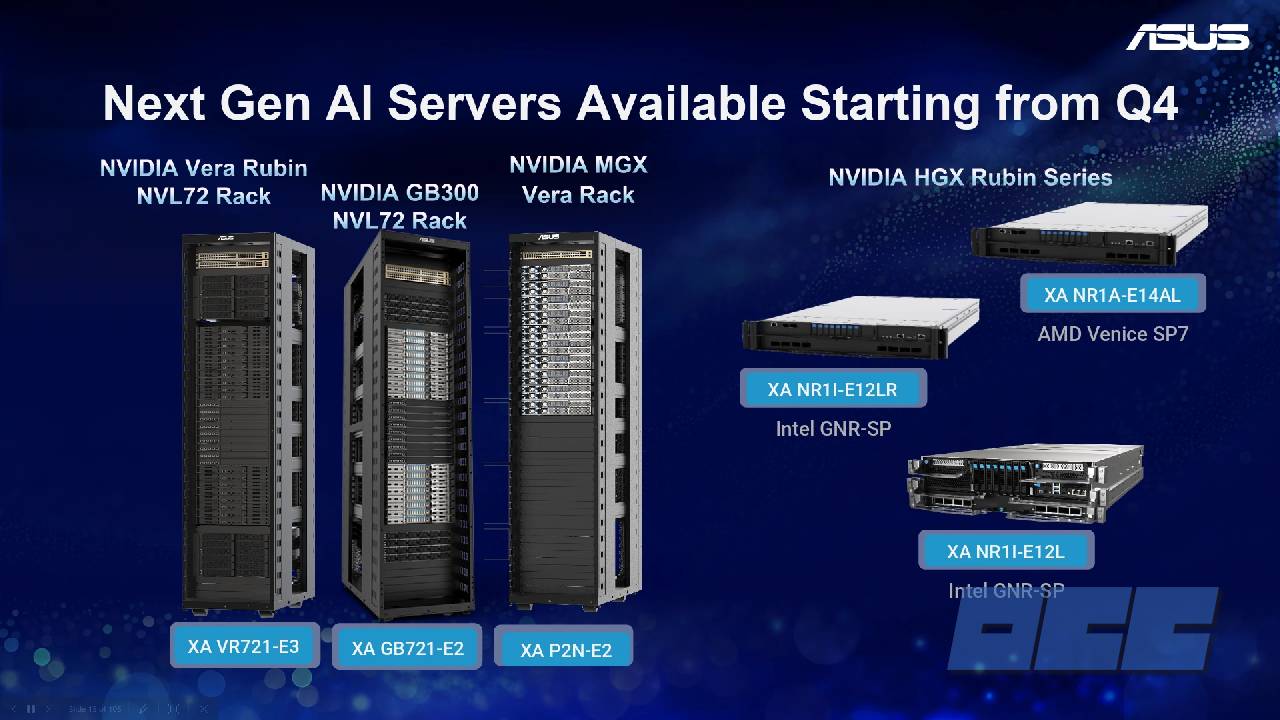
Évidemment, impossible pour nous de participer à un tel événement sans nous intéresser de près aux machines présentées. Et dans ce domaine, ASUS n’est pas venu les mains vides ! Le fabricant a détaillé plusieurs serveurs professionnels faisant appel aux architectures NVIDIA, aussi bien actuelles que futures. Commençons par l’ ASUS XA VR721-E3, qui repose sur la plateforme NVIDIA Vera Rubin NVL72. Nous parlons ici d’une infrastructure réunissant 36 CPU NVIDIA Vera et 72 GPU Rubin, avec des interconnexions permettant aux différents composants de travailler ensemble sur des charges de calcul particulièrement importantes. Ce type de configuration cible naturellement les besoins des grandes infrastructures IA, notamment l’entraînement et l’exploitation de modèles exigeant énormément de ressources. Pour gérer la chaleur dégagée par une telle concentration de composants, ASUS utilise une architecture intégralement refroidie par liquide. Autre référence présentée, le XA GB721-E2, construit autour de NVIDIA GB300 NVL72. Cette plateforme rassemble 36 CPU NVIDIA Grace et 72 GPU Blackwell Ultra. Elle répond notamment aux exigences de l’entraînement de grands modèles et de leur utilisation en inférence à grande échelle. Bien entendu, toutes les entreprises n’ont pas besoin d’une infrastructure de cette dimension. ASUS propose donc également des solutions moins imposantes, basées sur les environnements NVIDIA HGX et MGX. Parmi elles, nous avons notamment retenu les XA NR1I-E12LR et XA NR1I-E12L, deux plateformes fondées sur NVIDIA HGX Rubin NVL8. Le XA NR1I-E12LR privilégie le refroidissement liquide intégral, afin de gérer des composants très denses dans un espace réduit. Le XA NR1I-E12L retient quant à lui un système hybride : les GPU bénéficient d’un refroidissement liquide, tandis que le refroidissement par air reste utilisé pour une partie des autres éléments.
Ces deux approches correspondent à des besoins différents. Le tout liquide favorise une densité de calcul particulièrement importante. Une architecture hybride peut, de son côté, faciliter l’intégration dans des salles existantes et rendre certaines interventions de maintenance moins contraignantes. Pour les entreprises, le choix dépend donc autant des caractéristiques du bâtiment et de l’infrastructure disponible que des performances recherchées. ASUS a également mis en avant le XA P2N-E2, un serveur au format 2U utilisant l’architecture NVIDIA MGX. Il peut recevoir deux CPU NVIDIA Vera, accompagnés de deux GPU professionnels NVIDIA compatibles. Cette plateforme s’adresse notamment aux applications d’intelligence artificielle agentique. Ces dernières doivent souvent combiner des opérations exécutées par les modèles, des traitements réalisés sur les CPU et de nombreux échanges avec les données ou les outils utilisés. Dans la gamme ASUS, plusieurs modèles ESC8000 peuvent également embarquer jusqu’à huit accélérateurs graphiques, selon leur configuration. Ces machines peuvent notamment accueillir des GPU NVIDIA RTX PRO pour des usages comme l’inférence, la simulation scientifique ou le traitement de grands volumes de données. Enfin, le constructeur nous a donné un aperçu des prochaines évolutions attendues en 2027. De nouveaux serveurs sont prévus autour des processeurs AMD EPYC Venice et Intel Xeon Diamond Rapids. ASUS envisage notamment des systèmes 2U accueillant quatre GPU, ainsi que des machines plus volumineuses au format 6U, prévues pour huit accélérateurs et susceptibles d’offrir davantage de possibilités de densification selon leur architecture. Cette multiplication des formats traduit bien l’évolution du marché. Plutôt que de chercher une configuration capable de répondre à tous les usages, les fabricants proposent désormais des plateformes adaptées à des besoins plus précis.
ALSO : accompagner les entreprises dans le choix et le déploiement de leur IA
La présentation suivante nous a permis de découvrir le rôle d’ALSO, un groupe spécialisé dans la distribution de produits et services informatiques. Fortement implanté en Europe, notamment en Allemagne et en Suisse, ALSO intervient aussi bien dans la distribution de matériel que dans les solutions logicielles, le cloud, la cybersécurité et l’intelligence artificielle. Son positionnement est assez différent de celui des fabricants de serveurs. ALSO cherche principalement à accompagner les entreprises qui souhaitent utiliser l’IA, mais qui ne disposent pas nécessairement des compétences nécessaires pour définir seules leur infrastructure. Car adopter l’intelligence artificielle soulève rapidement plusieurs questions. Quel modèle sélectionner ? Faut-il utiliser une solution hébergée dans le cloud ou installer ses propres serveurs ? Quel budget prévoir et comment administrer l’ensemble ? Pour répondre à ces interrogations, ALSO propose un accompagnement articulé autour de trois phases. Tout commence par le conseil et l’évaluation des besoins. Cette étape doit permettre de déterminer les technologies les plus pertinentes et les ressources nécessaires. Une fois l’architecture définie, les équipes passent à sa conception et à son installation. Vient ensuite l’exploitation quotidienne, avec les questions de maintenance, de supervision, d’administration et de gestion des ressources. ALSO a également développé un programme destiné à ses entreprises partenaires, avec plusieurs niveaux de progression et de certification. Au-delà de la formation, cette démarche doit faciliter les échanges commerciaux entre les différents membres de son réseau. Ainsi, une société ayant conçu une application IA pour répondre à une problématique précise pourra potentiellement la proposer à d’autres clients par l’intermédiaire de l’écosystème ALSO. Cette approche rappelle que la démocratisation de l’intelligence artificielle professionnelle passe également par les distributeurs, les prestataires et les entreprises chargées de déployer les solutions sur le terrain.
2CRSi : l’expertise française des serveurs et du refroidissement
Autre acteur présent à cette journée, 2CRSi, une entreprise française créée en 2005 et basée à Strasbourg. Spécialisée dans les serveurs haute performance et les infrastructures de calcul, elle a enregistré un chiffre d’affaires annuel consolidé de 386,5 millions d’euros pour son exercice 2025-2026. Le développement des besoins en puissance de calcul, notamment pour l’intelligence artificielle, contribue à la croissance de cette activité. Mais ce qui distingue particulièrement 2CRSi, c’est sa capacité à adapter ses équipements à des situations qui ne correspondent pas aux environnements habituels des centres de données. Dans de nombreux projets, les serveurs standards remplissent parfaitement leur rôle. D’autres installations imposent cependant des contraintes beaucoup plus délicates. Certains clients doivent installer leurs machines dans des locaux initialement prévus pour d’autres activités. D’autres disposent d’un espace limité, rencontrent des difficultés pour évacuer la chaleur ou doivent respecter des exigences particulières concernant l’alimentation et les performances. C’est précisément sur ce type de projets que 2CRSi apporte son expertise. L’entreprise travaille depuis une vingtaine d’années sur le refroidissement liquide et maîtrise également les technologies d’immersion cooling, ou refroidissement par immersion. Le principe consiste à placer des composants électroniques compatibles dans un liquide diélectrique, qui permet de récupérer efficacement la chaleur qu’ils dégagent. Cette technique peut notamment présenter des avantages pour certaines installations industrielles ou des systèmes de calcul déployés au plus près des équipements, dans le cadre de l’Edge Computing. 2CRSi s’intéresse également à la distribution électrique par busbars, des barres conductrices permettant d’acheminer le courant vers les différents équipements. Autre domaine abordé lors de la présentation : la personnalisation des BIOS afin d’adapter le fonctionnement des serveurs à des applications particulièrement exigeantes. Dans des secteurs comme le trading à haute fréquence, quelques variations de latence peuvent avoir des conséquences importantes. L’optimisation du comportement matériel devient alors un enjeu à part entière. Cette expertise concerne aussi d’autres environnements professionnels nécessitant des systèmes très spécifiques, notamment certaines applications militaires. Avec 2CRSi, nous retrouvons donc une problématique essentielle du calcul intensif : le serveur le plus performant sur le papier n’est pas forcément le plus adapté aux contraintes du client.
PrediSurge : l’IA et les jumeaux numériques au service des chirurgiens
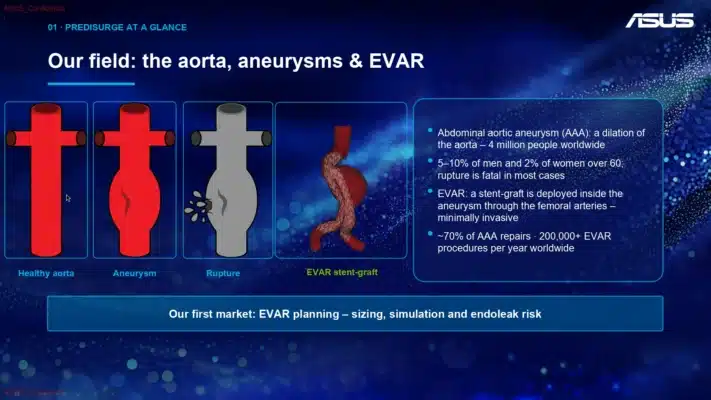
Parmi les différentes interventions de la journée, celle de PrediSurge nous a particulièrement intéressés. Cette société française, fondée en 2017 à Saint-Étienne, développe des outils destinés à accompagner les chirurgiens vasculaires dans la préparation de certaines opérations. Sa technologie associe plusieurs domaines : l’intelligence artificielle, l’analyse d’images médicales, la simulation biomécanique et les jumeaux numériques. L’entreprise réunit aujourd’hui une trentaine de collaborateurs et collabore avec de nombreux établissements médicaux dans le monde. Ses solutions ont déjà servi à simuler plus de 1 700 cas de patients, avec un réseau représentant environ 250 centres cliniques. Pour saisir l’intérêt de ces outils, il faut revenir sur la problématique médicale à laquelle ils répondent. Un anévrisme apparaît lorsqu’une artère présente une dilatation anormale. Quand cette déformation touche l’aorte, les conséquences peuvent être particulièrement graves en cas de rupture. L’une des solutions chirurgicales consiste à installer une endoprothèse, ou stent-graft, à l’intérieur de l’artère afin d’exclure la zone fragilisée de la circulation sanguine sous pression. Mais cette intervention demande une préparation minutieuse. La morphologie de l’aorte varie d’un patient à l’autre. Le diamètre du dispositif, sa longueur ou encore son positionnement doivent être adaptés à cette anatomie. Une mauvaise sélection peut notamment augmenter le risque de complications après l’intervention. PrediSurge cherche justement à apporter aux chirurgiens des informations supplémentaires avant qu’ils ne passent au bloc opératoire.
Une première analyse automatique à partir des images médicales
Tout commence par l’acquisition des données du patient, principalement celles provenant d’un scanner CT. PrediSurge utilise ensuite un algorithme de Deep Learning reposant notamment sur une architecture U-Net, afin de segmenter automatiquement les structures anatomiques qui intéressent le chirurgien. Concrètement, le logiciel analyse les images du scanner pour distinguer les contours de l’aorte et identifier les régions nécessaires à la préparation de l’intervention. Cette segmentation permet d’extraire les dimensions et les caractéristiques géométriques du vaisseau. Le logiciel peut alors proposer plusieurs dimensions d’endoprothèses, à partir des informations recueillies. L’automatisation de cette phase vise à accélérer les mesures et à réduire les différences pouvant apparaître entre plusieurs analyses manuelles.
Un jumeau numérique pour simuler l’implantation
Après cette première étape, les informations anatomiques sont utilisées pour créer un jumeau numérique propre au patient. Il ne s’agit pas simplement de produire une jolie représentation tridimensionnelle de l’aorte. L’objectif est également de modéliser son comportement mécanique et la manière dont une endoprothèse pourrait interagir avec ses parois. Le chirurgien peut alors étudier virtuellement plusieurs scénarios avant l’opération. Il devient notamment possible de modifier les dimensions du dispositif, de comparer différentes endoprothèses ou d’évaluer plusieurs positions d’implantation. Ces simulations servent à déterminer quelle configuration semble la mieux adaptée à la morphologie du patient. L’intérêt est de pouvoir effectuer ces comparaisons avant l’intervention, plutôt que de découvrir certaines difficultés une fois le patient sur la table d’opération.
L’Endoleak Risk Index pour anticiper certaines complications
La troisième fonctionnalité présentée par PrediSurge concerne le calcul de l’ERI, ou Endoleak Risk Index. Cet indicateur a été développé pour évaluer le risque d’endofuite de type IA après la pose d’une endoprothèse aortique. Cette complication apparaît lorsque l’étanchéité entre la prothèse et la paroi de l’aorte est insuffisante au niveau de son ancrage proximal, laissant circuler du sang vers la zone de l’anévrisme. Pour estimer ce risque, la technologie de PrediSurge étudie notamment les caractéristiques géométriques du contact entre l’endoprothèse et les structures anatomiques. Selon l’entreprise, les simulations peuvent exploiter jusqu’à 16 000 points de mesure afin d’analyser les interactions et de contribuer au calcul de l’indicateur. Le chirurgien dispose ainsi d’un élément supplémentaire pour comparer plusieurs stratégies d’implantation. Il faut cependant être clair sur le rôle de cette technologie. L’IA n’a pas vocation à décider seule de la procédure à suivre. Elle fournit des données complémentaires pour éclairer le choix du praticien.
80 % de sensibilité et 83 % de spécificité : des résultats prometteurs
PrediSurge a également communiqué des résultats issus de l’étude rétrospective multicentrique EnduSim, consacrée à la prédiction des endofuites de type IA. Dans ce cadre, l’indicateur ERI a atteint 80 % de sensibilité et 83 % de spécificité. Ces deux valeurs sont importantes, car elles évaluent des aspects différents du comportement du modèle. La sensibilité correspond à sa capacité à identifier les patients qui présentent réellement la complication recherchée. La spécificité mesure, à l’inverse, son aptitude à reconnaître ceux qui ne la présentent pas. Avec ces résultats, le modèle affiche des performances encourageantes dans les deux catégories, sans pour autant éliminer les risques d’erreurs. Attention toutefois à ne pas mal interpréter ces chiffres. Ils ne représentent ni le taux de réussite des opérations ni une garantie sur leur déroulement. Ils traduisent uniquement les résultats obtenus par le modèle dans le cadre de cette évaluation clinique. Comme pour tout outil d’aide à la décision médicale, de nouvelles validations restent nécessaires afin de vérifier que ses performances se maintiennent dans différents contextes et auprès d’autres populations de patients. Cela n’enlève rien à l’intérêt de la démarche. En combinant simulation numérique, analyse d’images et intelligence artificielle, PrediSurge propose un outil susceptible d’améliorer la préparation de certaines interventions.
Deux RTX PRO 6000 et 128 cœurs Zen 5 pour entraîner les modèles de PrediSurge
La partie matérielle de la présentation était évidemment particulièrement intéressante pour nous. PrediSurge a détaillé une partie de son infrastructure informatique, utilisée pour développer et entraîner ses algorithmes. L’entreprise s’appuie notamment sur un serveur ASUS ESC8000A équipé de deux NVIDIA RTX PRO 6000, chacune disposant de 96 Go de mémoire vidéo. La machine offre donc un total de 192 Go de VRAM, répartis entre les deux accélérateurs. Côté processeurs, nous retrouvons deux AMD EPYC reposant sur l’architecture Zen 5. Chaque CPU dispose de 64 cœurs, soit 128 cœurs au total. La configuration embarque également 768 Go de mémoire vive. Nous sommes donc face à une station de calcul particulièrement sérieuse, même si ses dimensions restent modestes face aux énormes installations nécessaires pour entraîner certains modèles de langage. Pour le prototypage et une partie des opérations d’inférence, la société utilise aussi des GPU NVIDIA RTX PRO 4000. Cette différence entre les configurations d’entraînement et celles utilisées pour d’autres tâches est intéressante. Elle rappelle que les besoins matériels d’une application d’intelligence artificielle dépendent fortement de sa nature, de la quantité de données à traiter et des modèles employés. Développer une solution médicale avancée ne nécessite donc pas obligatoirement un cluster comprenant des milliers d’accélérateurs. PrediSurge envisage également de faire évoluer ses logiciels avec des fonctionnalités reposant sur l’IA agentique. L’idée serait, à terme, de permettre au chirurgien de déléguer à un agent certaines opérations, comme le déclenchement d’une analyse, l’exécution des simulations ou la récupération des résultats. Bien entendu, une telle évolution dans le domaine médical suppose des procédures de validation particulièrement strictes, ainsi qu’un contrôle humain permanent sur les décisions importantes. Cette perspective montre néanmoins comment l’IA pourrait progressivement simplifier le travail des équipes médicales, au-delà de la seule analyse des images.
L’IA professionnelle ne se résume plus à une course à la puissance
Au terme de cette journée, plusieurs enseignements se dégagent des interventions auxquelles nous avons assisté. Le premier est que le développement de l’intelligence artificielle repose sur un écosystème beaucoup plus large que les seuls fabricants d’accélérateurs graphiques. ASUS cherche aujourd’hui à fournir des solutions complètes, associant serveurs, infrastructures, logiciels d’administration et outils destinés aux applications IA. De son côté, NVIDIA apporte ses architectures de calcul et ses technologies de communication, indispensables pour faire fonctionner les systèmes les plus exigeants. Des entreprises comme ALSO interviennent ensuite pour conseiller les professionnels, leur proposer les bonnes solutions et accompagner leur déploiement. D’autres, comme 2CRSi, apportent leur savoir-faire dans la conception de machines adaptées à des installations dont les contraintes sortent de l’ordinaire. Enfin, l’exemple de PrediSurge rappelle que toutes ces ressources peuvent servir à développer des applications dont les bénéfices dépassent largement le domaine informatique. Ce que nous retenons surtout, c’est que la puissance des GPU ne constitue qu’une partie de l’équation. La capacité à alimenter les serveurs, à gérer leur dégagement thermique, à faire circuler rapidement les données et à simplifier leur administration va prendre une importance croissante. Les entreprises devront également regarder de près le coût total de leurs installations, leur consommation électrique et les moyens nécessaires pour les maintenir en fonctionnement. Investir dans l’IA ne revient donc plus uniquement à acheter des composants toujours plus performants. Il faut désormais sélectionner une architecture cohérente avec ses besoins, puis être capable de l’exploiter efficacement. Pour les passionnés de hardware que nous sommes, cette transformation est particulièrement intéressante à suivre. Les technologies que nous connaissons à travers nos tests de CPU, de GPU ou de systèmes de refroidissement prennent ici une tout autre dimension. Et certaines applications permettent de mieux comprendre les enjeux de cette évolution. L’exemple de PrediSurge est assez parlant. Derrière les serveurs, les accélérateurs NVIDIA et les algorithmes de Deep Learning, on retrouve une solution qui aide les chirurgiens à préparer des opérations complexes et à mieux évaluer certains risques pour leurs patients.
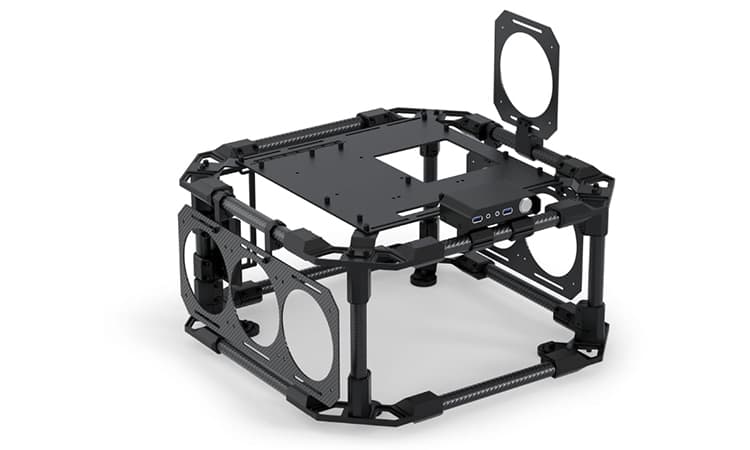
La marque Alphacool annonce une nouvelle table de bench, l’Apex Benchtable. Cette dernière adopte une construction particulièrement premium, notamment par le choix de ses matériaux. En effet, nous retrouvons une table construite à base d’aluminium, mais surtout de carbone que l’on retrouve un peu partout. Par ailleurs, elle s’avère plutôt imposante.
Apex Benchtable : une table de bench Alphacool en carbone et aluminium !
La fiche produit de cette Apex Benchtable :
Vulgairement, il ne s’agit pas d’un boîtier, mais d’une table de benchmark. Si son rôle reste d’accueillir une configuration, elle ne le fait pas de la même manière qu’un boîtier. En effet, tous les composants sont laissés à l’air libre et restent parfaitement accessibles. C’est une configuration idéale pour les overclockers, mais aussi pour les testeurs et les bidouilleurs en tout genre. Au niveau de l’encombrement, il faut compter sur des dimensions de 466,86 (L) x 460,86 (P) x 415,43 (H) mm. La table profite d’un plateau de carte mère en aluminium permettant d’accueillir des modèles au format mini-ITX, micro-ATX, ATX et E-ATX sans backplate. Sous ce plateau, nous retrouvons l’emplacement de l’alimentation qui pourra adopter un format ATX standard. Pour ce qui est du support des radiateurs de watercooling, il sera possible de monter un radiateur en 360 mm, un second en 240 mm et un dernier en 120 mm. Le tout profite de supports en carbone et permettra le montage de six ventilateurs en 120 mm. Enfin, nous retrouvons la présence d’une structure tubulaire en fibre de carbone tout autour du plateau de carte mère en guise de piètement. Un bouton power, deux ports USB 3.0 et deux prises casques et micro Jack 3,5 mm sont présents au niveau du panneau de contrôle.
Le prix qui pique :
Il ne reste plus qu’à parler du prix de vente de cette table qui est tout sauf donné. En effet, la boutique en ligne d’Alphacool l’affiche à 499,98 €, un prix qui tire sa justification dans la présence d’éléments en fibre de carbone véritable : ce n’est pas juste un skin.
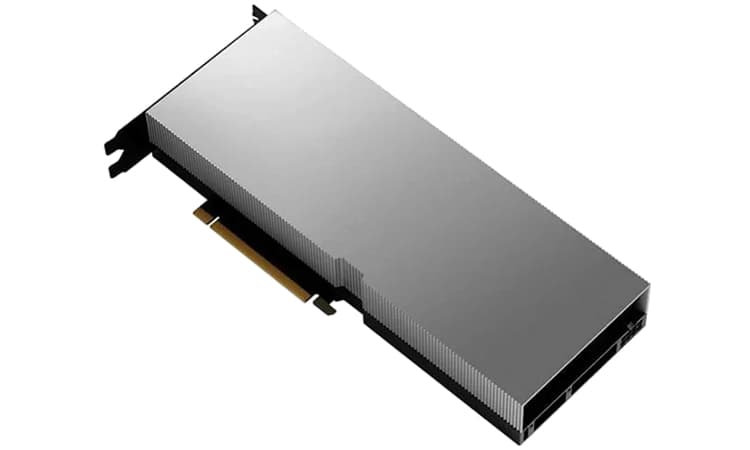
Le monde du matériel informatique offre parfois des opportunités surprenantes pour les passionnés disposant de compétences techniques pointues. Une récente découverte rapportée par Tom’s Hardware illustre parfaitement cette dynamique : un utilisateur a réussi à transformer une carte graphique de minage Nvidia CMP-170HX, vendue environ 2 500 $, en une version complète de la puissante A100 80 Go, dont le prix avoisine les 20 000 $. Cette modification radicale repose sur une technique de glitch de tension qui permet de contourner les restrictions imposées par le fabricant.
Contourner le système de fusibles
La carte de départ est une CMP-170HX équipée de 8 Go de mémoire vidéo, un modèle conçu spécifiquement pour le minage de cryptomonnaies. Bien que moins performante que ses homologues de centre de données, cette puce utilise la même architecture de base que les cartes professionnelles haut de gamme. L’objectif de l’ingénieur, identifié sous le pseudonyme de Kate, était de déverrouiller tout le potentiel de la puce GA100 intégrée, qui contient en réalité les composants nécessaires pour atteindre 80 Go de mémoire HBM2e et des modules de calcul supplémentaires.
Ces composants sont normalement désactivés à l’usine via un contrôleur de fusibles embarqué. Ce système, composé de 16 384 fusibles disposés en grille, sert à désactiver les parties défectueuses ou à segmenter le produit selon le niveau de performance désiré. Dans le cas de la CMP-170HX, ces sections sont simplement coupées pour réduire le coût et la complexité. Kate a conçu un circuit imprimé basé sur un microcontrôleur STM32G4 capable d’intercepter les signaux PWM envoyés aux régulateurs de tension de la carte.
En injectant des perturbations de tension précises, l’ingénieure a réussi à forcer le contrôleur de fusibles dans un état permettant d’avoir accès aux parties désactivées de la mémoire et du GPU. Les tests ont montré que neuf cartes sur dix atteignaient les 80 Go de VRAM fonctionnels, tandis qu’une seule affichait 64 Go. De plus, la réactivation des modules de shaders supplémentaires a augmenté les performances en demi-précision (FP16) de 20 % par rapport à une A100 standard.
Une opération risquée
En contrepartie, cette modification comporte des risques significatifs puisque la méthode implique de « faire sauter » physiquement des fusibles sur la carte, une action irréversible qui peut endommager définitivement le matériel. De plus, bien que la carte modifiée fonctionne désormais en bande passante PCIe 4.0 (au lieu du PCIe 1.0 x4) et offre un ensemble de fonctionnalités complet, elle ne dispose pas de support ECC, NVLink ou de gestion multi-instance GPU, des caractéristiques essentielles pour les environnements de serveurs professionnels.
La modification nécessite également l’utilisation préalable d’un soft-mod appelé CMPUnlocker pour que les pilotes reconnaissent les nouvelles capacités. Cependant, ce logiciel seul ne suffit pas à lever toutes les limitations matérielles. Kate a signalé la vulnérabilité à Nvidia, mais l’entreprise ne peut rien faire pour les cartes déjà commercialisées. Les prix du marché fluctueront probablement à mesure que cette technique se répandra, rendant les cartes de minage d’occasion encore plus attractives pour les constructeurs de clusters d’IA locaux.
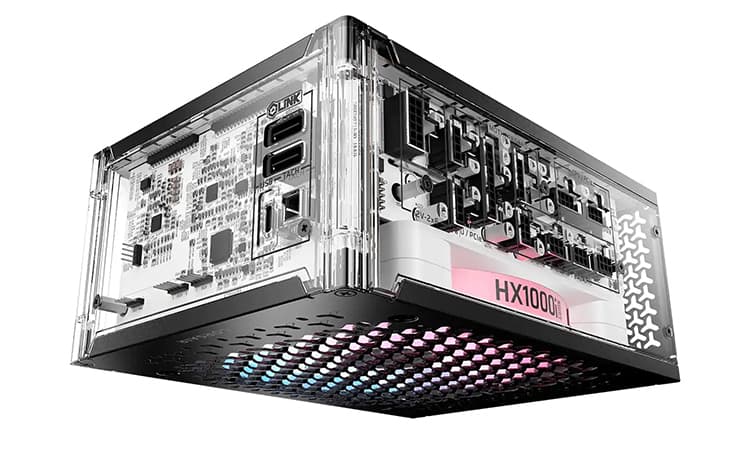
Direction la marque Corsair qui lance un nouveau produit sur le marché avec son alimentation HX1000i Shift Crystal. Elle présente deux particularités : une coque transparente, qui permet aux utilisateurs d’admirer les entrailles du bloc, et une connectique déportée sur le côté de la carcasse pour faciliter le câblage !
HX1000i Shift Crystal : une alimentation Corsair à coque transparente !
Une connectique déportée sur le côté !
Clairement, avec ce bloc, Corsair tente quelque chose en proposant une alimentation entièrement transparente. De plus, l’intérieur est soigné, puisque les différents PCB visibles sont de couleur blanche avec tous les composants électroniques bien visibles. Bref, si vous étiez fan de la coque transparente de votre Game Boy ou de votre Nintendo 64, peut-être que ce modèle fera vibrer une corde sensible. Autre élément à prendre en compte, c’est le côté « Shift » de ce modèle puisque la connectique modulaire migre sur le côté. Cela facilite l’ajout de câbles une fois le bloc dans un boîtier PC. Par contre, il faudra opter pour un boîtier assez large au risque de ne pas pouvoir refermer le panneau latéral.
La partie électrique :
Pour ce qui est de la partie électrique, nous retiendrons une puissance confortable de 1 000 W, tandis que les certifications Cybenetics Platinum et A+ pour le bruit sont présentes. Du côté des protections, nous avons la panoplie complète en plus du PinProtect 12V-2×6 afin d’empêcher la fonte du connecteur d’alimentation de la carte graphique. Sinon, nous retrouvons un unique rail 12 V conçu pour fournir 83,3 A, tandis que nous avons des condensateurs certifiés 105 °C et un bloc conçu pour fonctionner à 50 °C de température ambiante. Enfin, n’oublions pas de parler de la gestion via iCUE qui permettra de surveiller différentes données en lien avec l’alimentation ou de piloter l’éclairage et la vitesse du ventilateur. D’ailleurs, le ventilateur est un modèle de 140 mm avec un mode de fonctionnement semi-passif !
Un prix élevé :
Malheureusement, le montant de la facture sera conséquent puisque l’on parle ici de 289,90 € avec une garantie de 10 ans. Enfin, si ce modèle est esthétiquement intéressant, il est dommage de constater que les alimentations finissent bien souvent derrière des caches dédiés.
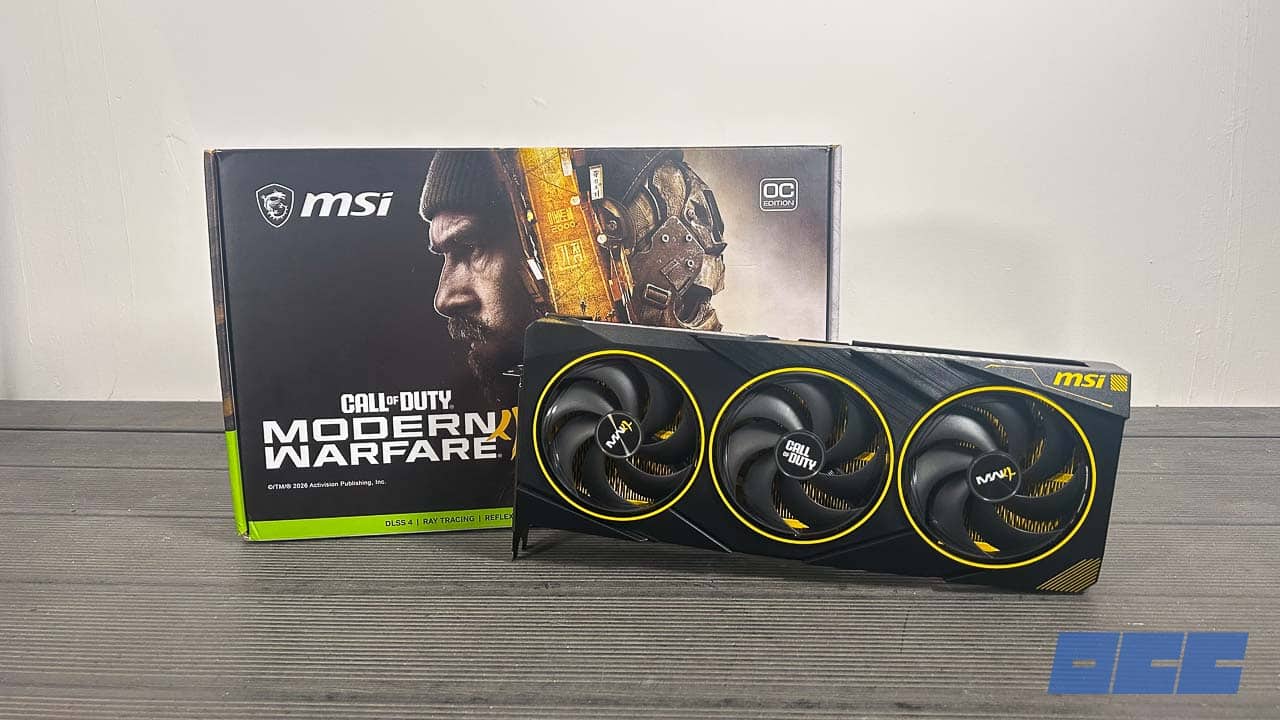
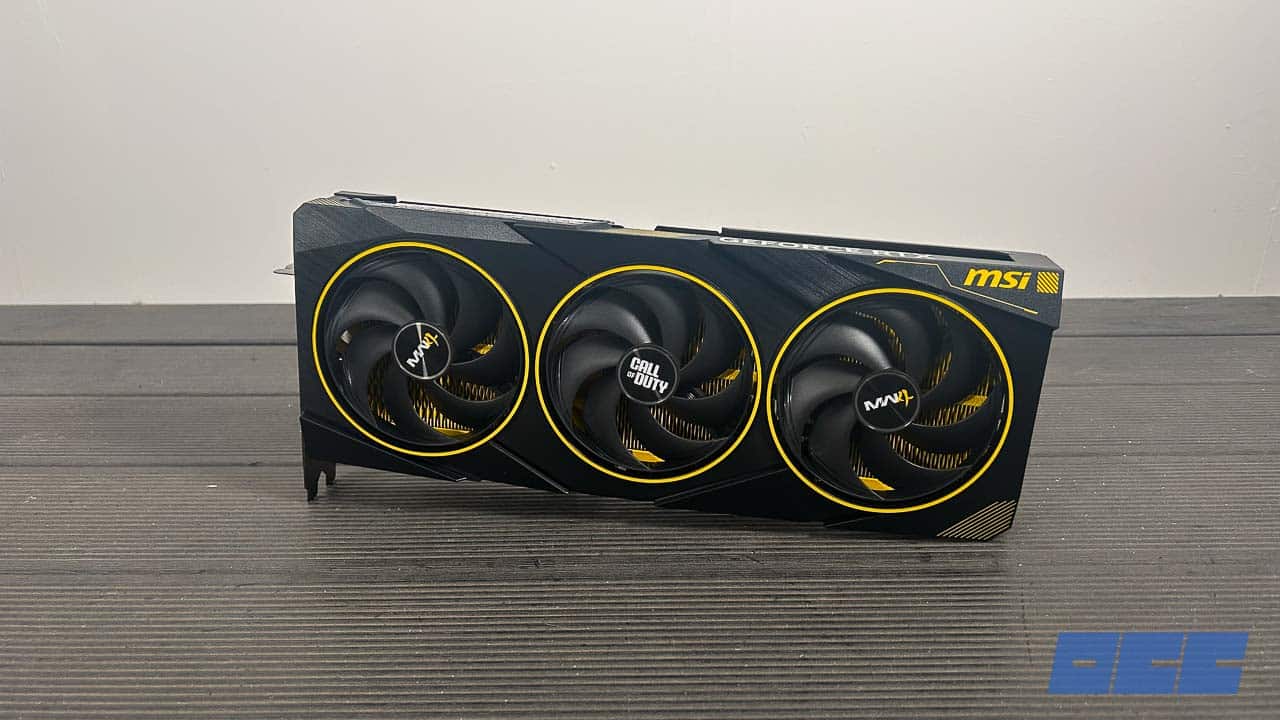
Après la carte Mandalorian and Grogu, MSI remet le couvert avec une nouvelle RTX 5080 en édition limitée, cette fois aux couleurs du tout dernier Call of Duty : Modern Warfare 4. Au programme : un radiateur peint en jaune, Ghost sur la backplate et une zone thermochromique. Une carte que nous avons la chance de pouvoir vous présenter !
Les éditions collector sont décidément devenues une habitude chez MSI. Il y a quelques mois, on vous présentait déjà un autre modèle ainsi qu’un petit build autour de celui-ci. Mais MSI ne compte visiblement pas s’arrêter là sur les collaborations et a choisi pour la sortie de Call of Duty : Modern Warfare 4, le 23 octobre dernier, de s’associer à Activision pour proposer un modèle de GeForce RTX 5080 spécial. Une carte sobre mélangeant du noir, beaucoup de jaune, le célèbre personnage Ghost sur la backplate et un radiateur peint. Une première selon MSI. Merci à MSI France pour la mise à disposition de cette carte !
Un design taillé pour le champ de bataille :
C’est évidemment le gros argument de cette carte. MSI reprend les codes visuels de Modern Warfare 4 avec un carénage noir d’inspiration militaire, rehaussé par le jaune du logo du jeu. Ce jaune se retrouve partout : sur les cerclages des trois ventilateurs, sur le hub central qui arbore le logo Call of Duty, mais aussi sur le radiateur lui-même. MSI a en effet peint l’intégralité des ailettes en jaune, ce que le constructeur présente comme une première mondiale sur une carte graphique (on ne va pas se mentir, c’est un argument marketing). Un détail purement esthétique, visible à travers le carénage et la backplate, qui ne changera rien aux performances.
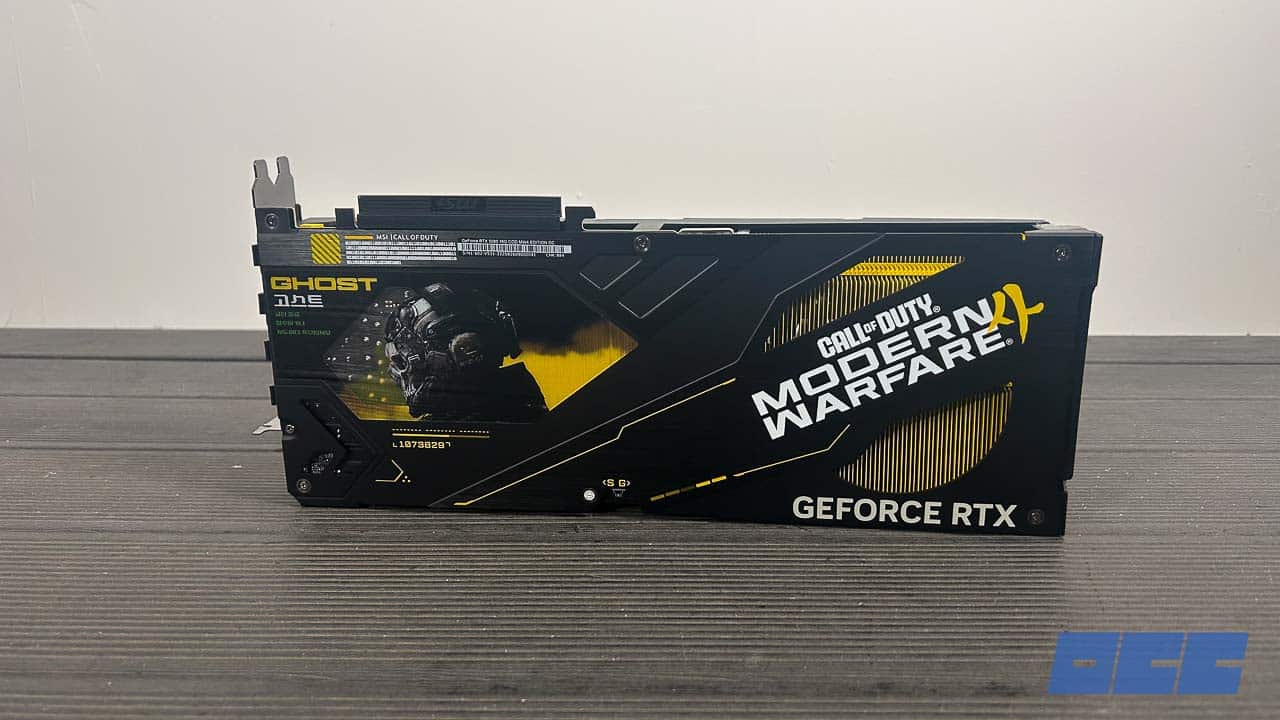
Justement, la backplate en métal est clairement la pièce maîtresse du design. On y retrouve un portrait de Ghost, l’un des personnages les plus emblématiques de la série, placé derrière une section transparente qui laisse apparaître le PCB. Le logo Modern Warfare 4 et plusieurs découpes laissant voir le radiateur jaune complètent l’ensemble. MSI ajoute aussi une zone thermochromique, qui change d’aspect avec la chaleur, ainsi qu’un logo Call of Duty rétroéclairé sur la tranche. L’éclairage RGB est personnalisable via le logiciel MSI Center.
Même le support de carte graphique fourni dans la boîte a droit au traitement Modern Warfare 4. Petite attention bienvenue, d’autant qu’avec ses 1,3 kg, la carte en aura bien besoin pour ne pas s’abîmer avec le temps.
Une base de Gaming Trio :
Sous ce maquillage militaire, la carte reprend la base de la Gaming Trio de MSI et son système de refroidissement Tri Frozr 4. On retrouve donc les trois ventilateurs STORMFORCE à sept pales, une base en cuivre nickelé, des caloducs à section carrée et des ailettes Waved Curved 4.0. La carte dispose aussi d’un double BIOS avec deux modes, GAMING et SILENT, ainsi qu’un fonctionnement semi-passif. C’est-à-dire que les ventilateurs sont à l’arrêt lorsque la carte est peu sollicitée.
Concernant son encombrement, la carte mesure 344 x 144 x 52 mm et occupe 2,5 slots. Elle devrait donc pouvoir s’intégrer dans n’importe quel boîtier au format ATX et Micro-ATX.
Du côté du hardware, rien ne change par rapport aux autres RTX 5080. On a toujours la puce Blackwell avec 10 752 cœurs CUDA, accompagnée de 16 Go de GDDR7 sur un bus 256 bits à 30 Gbps. Le boost est fixé à 2700 MHz, et grimpe à 2715 MHz avec le profil Extreme Performance de MSI Center. Un overclocking d’usine très léger, il ne faut pas s’attendre à des performances différentes d’une RTX 5080 classique.
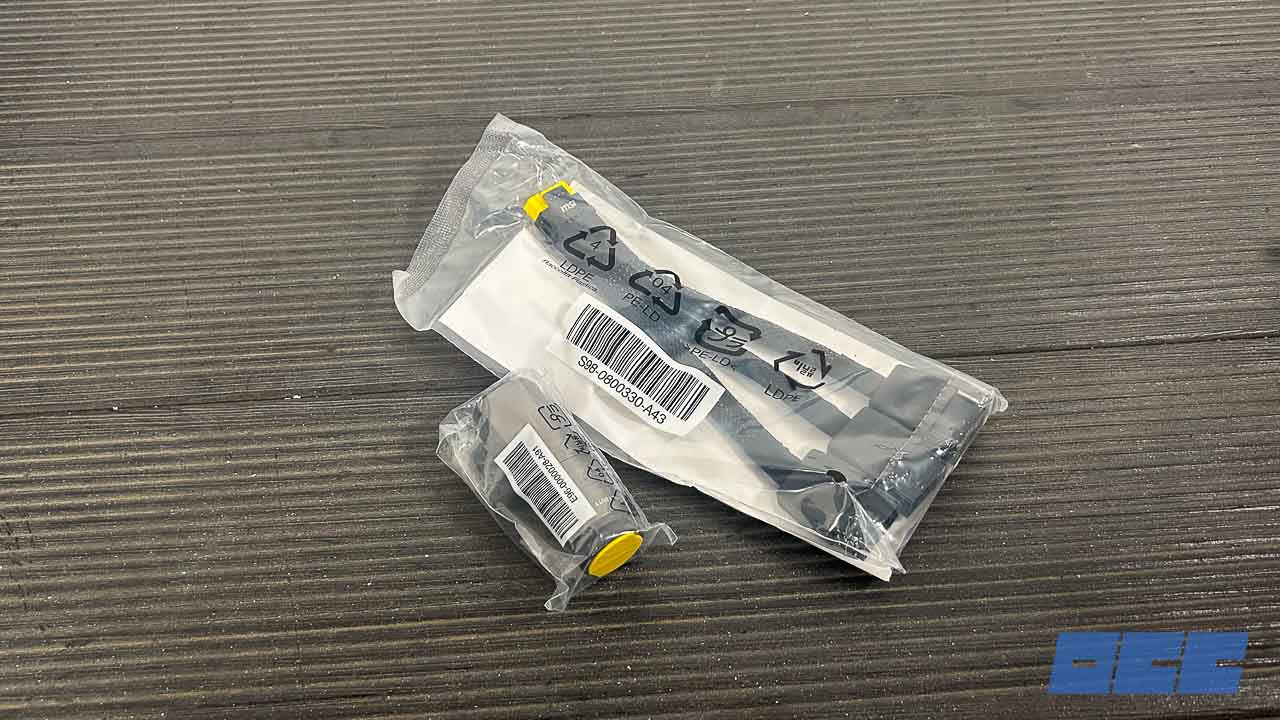
Pour l’alimentation, la carte utilise un connecteur 16 broches 12V-2×6, avec un adaptateur 3x 8 broches fourni. MSI recommande une alimentation avec une puissance minimale de 850 W pour une consommation totale annoncée de 360 W.
Les caractéristiques techniques :
Caractéristique
MSI RTX 5080 16G COD MW4 EDITION OC
GPU
NVIDIA GeForce RTX 5080 (Blackwell, 4 nm)
Cœurs
10 752 CUDA, 336 Tensor, 84 RT
Fréquence de base
2295 MHz
Fréquence boost
2700 MHz (2715 MHz en mode Extreme Performance)
Mémoire
16 Go GDDR7, 256 bits, 30 Gbps
Interface
PCI Express 5.0 x16
Sorties vidéo
3x DisplayPort 2.1b, 1x HDMI 2.1b
Refroidissement
Tri Frozr 4, 3 ventilateurs STORMFORCE, semi-passif
Support de carte graphique aux couleurs de MW4, adaptateur d’alimentation
Prix
environ 2 500 €
Prix et disponibilité :
Reste la question qui fâche : le prix. En France, la carte est référencée à un prix d’environ 2 500 €. Un prix très élevé justifié en partie par sa rareté puisque seulement 200 exemplaires ont été distribués en Europe. De plus, il faut dire que le contexte n’aide pas. Avec la flambée du prix de la mémoire, portée par la demande de l’IA, le prix des cartes graphiques ne cesse d’augmenter. Et couplé à son statut d’édition limitée, sous la licence Call of Duty et avec un design fait sur mesure, on arrive à un tarif tout simplement délirant pour une carte qui offre les mêmes performances qu’une RTX 5080 standard. À nos yeux ce n’est peut-être pas le bon moment d’acheter ce type d’édition limitée, bien que celle-ci soit globalement réussie !
Toujours en lien avec la Chine, nous apprenons qu’AMD réduirait (notez le conditionnel) ses approvisionnements en cartes graphiques gaming dans l’Empire du Milieu. C’est sur ChannelGate que la rumeur circulait initialement avant d’être reprise par d’autres confrères. Évidemment, aucune annonce officielle de la part des rouges, nous restons donc dans la pure rumeur spéculative.
Des approvisionnements en GPU RADEON réduits chez AMD en Chine !
Un approvisionnement réduit de 20 à 50 % !
Si cette nouvelle rumeur rapportée sur ChannelGate se révèle vraie, les prix des cartes graphiques AMD en Chine pourraient être tirés vers le haut par deux phénomènes :
La pénurie de mémoire qui rend les cartes plus chères à produire
Le déséquilibre qui va continuer de se creuser entre l’offre et la demande
Dans tous les cas, le consommateur chinois n’est pas près de payer son matériel moins cher. Par ailleurs, cette baisse des approvisionnements pourrait n’être que temporaire. Effectivement, il est évoqué que ce phénomène pourrait durer jusqu’en janvier 2027.
Mais on n’en sait pas plus :
Malheureusement, nous n’en savons pas plus sur cette baisse des approvisionnements… On sait seulement que moins de GPU arriveraient entre les mains des partenaires de la marque. Dès lors, nous ne savons pas si certains modèles seront plus touchés que d’autres. Dans ce contexte de pénurie de mémoire, les rouges pourraient réduire davantage l’approvisionnement de cartes en 16 Go comme les RX 9070 et RX 9070 XT. De plus, il est précisé que cette baisse concerne avant tout la Chine et que des observations différentes peuvent être faites dans d’autres régions du monde comme l’Europe, l’Amérique, etc. Enfin, il n’est pas à exclure que les rouges priorisent temporairement la production de GPU pour l’IA au détriment des cartes grand public suite à un quelconque pic de demande dans ces secteurs. Bref, un phénomène à surveiller pour en mesurer les conséquences éventuelles.
Les récents événements entourant Jensen Huang ont fait des remous en Chine où il est rapporté que les entreprises de la tech et de l’IA se ruent sur les cartes NVIDIA. Effectivement, les récents événements pourraient pousser le gouvernement américain à resserrer la vis autour des exportations de cartes graphiques du caméléon plus tôt que prévu. Les entreprises se tourneraient vers les centres de données d’Asie du Sud-Est pour s’approvisionner en cartes !
Les entreprises chinoises cherchent à sécuriser des cartes NVIDIA rapidement !
Le gouvernement américain pourrait resserrer la vis autour des exportations de cartes NVIDIA !
Évidemment, la Chine continue d’avoir accès à du matériel de pointe de NVIDIA par des moyens légaux et d’autres qui restent plus… flous. En effet, si l’exportation de matériel atteignant un certain seuil de performance est illégale, les entreprises chinoises peuvent toujours avoir accès à ce type de matériel en se tournant vers des plateformes cloud. Cependant, cette voie, déjà dans le collimateur des autorités américaines, pourrait se refermer plus rapidement que prévu à la suite des révélations entourant l’ancien PDG de NVIDIA, Jensen Huang. Dans ce contexte, il est rapporté que les entreprises de la tech chinoise contacteraient des centres de données d’Asie du Sud-Est pour s’approvisionner en cartes NVIDIA. On pense à la Malaisie qui n’est pas sanctionnée par les Américains. D’ailleurs, c’est par ce biais que du matériel sous sanctions arrivait en Chine, notamment via le financement de Speedmatrix par Apex Enterprise Solution (une filiale singapourienne d’Alibaba), une entité malaisienne de MegaSpeed à laquelle Alice Huang était liée. Le but étant de faire rentrer un maximum de marchandise avant de devoir passer par des moyens plus complexes pour continuer de s’approvisionner en cartes. On peut aussi s’attendre à ce que les autorités américaines redoublent de vigilance pour limiter les exportations frauduleuses via le marché noir par exemple. Bref, l’importation de matériel sous sanctions américaines s’annonce plus compliquée pour les entreprises chinoises. Il n’est pas impossible que ces dernières doivent davantage recourir à des puces Huawei.
Du côté d’AMD, nous retrouvons la publication du pilote graphique en version 26.11.1, une version visant principalement à corriger le bug d’écriture des SSD causé par le processus atieclxx.exe. Pour rappel, ce dernier pouvait générer des écritures en permanence sur le disque. C’est un problème qui inquiète les propriétaires de SSD principalement à cause de la réduction de leur durée de vie, surtout à une époque où les coûts liés à la mémoire ont flambé !
RADEON Software 26.11.1 : les écritures SSD sont corrigées !
Les correctifs :
Malheureusement, il n’y aura pas grand-chose à se mettre sous la dent avec cette version puisque l’entreprise ne propose que deux correctifs avec cette nouvelle version. Effectivement, nous retrouvons la correction de :
Écritures excessives sur le disque système qui peuvent être observées lorsque le système est en idle avec une RX 7000 ou plus récente.
Écritures excessives sur le disque système qui peuvent être observées lors du déplacement ou du redimensionnement des fenêtres d’application.
Et c’est tout, le pilote n’apporte pas de prise en charge d’un nouveau jeu, de nouveaux gains de performance ni de nouvelle fonctionnalité. Dans le doute, c’est une version que nous vous conseillons d’installer pour éviter tout problème sur votre stockage.
Petit rappel du bug :
Dans les grandes lignes, le bug en question était lié à atieclxx.exe qui se copiait lui-même en boucle dans un répertoire spécifique de Windows. Bien que plutôt léger (660 ko), l’exécutable, à force de tourner, pouvait générer jusqu’à 56 Go d’écritures par jour à un débit compris entre 0,3 et 5 Mo/s en continu. Rappelons qu’un correctif non officiel avait été publié par un modder et que ce dernier interdisait au système de supprimer l’exécutable afin de casser la boucle d’écriture infinie. Enfin, un mécanisme analysait le système pour couper le correctif avec la nouvelle version du pilote d’AMD.








 Cette implantation régionale permet au constructeur de disposer de moyens industriels et techniques plus proches de ses clients, tout en accompagnant la multiplication des projets liés à l’intelligence artificielle. Mais c’est à Taïwan qu’ASUS nous a présenté l’un de ses exemples les plus significatifs. Le constructeur a participé à la réalisation de Nano4, un supercalculateur destiné au National Center for High Performance Computing de Taïwan. Cette machine associe des serveurs ASUS à des accélérateurs NVIDIA H200, reliés par un réseau InfiniBand disposant d’une bande passante particulièrement élevée. Nano4 s’est notamment distingué dans le classement TOP500 des supercalculateurs mondiaux. Une réalisation qui démontre les compétences d’ASUS dans le déploiement de systèmes de grande taille, où il faut concilier performances et efficacité énergétique. Autre projet évoqué pendant la présentation, Ubilink, également implanté à Taïwan et consacré au calcul intensif. ASUS possède par ailleurs un laboratoire spécialisé dans les infrastructures IA, installé à proximité de son siège de Taipei. Cette structure sert à tester les configurations complètes avant leur livraison, notamment pour vérifier leur comportement thermique, le bon fonctionnement du matériel et la fiabilité de l’ensemble. Une démarche indispensable lorsqu’on sait qu’une défaillance sur une installation de cette taille peut avoir des conséquences autrement plus importantes que sur un serveur isolé.


 Concrètement, le logiciel analyse les images du scanner pour distinguer les contours de l’aorte et identifier les régions nécessaires à la préparation de l’intervention. Cette segmentation permet d’extraire les dimensions et les caractéristiques géométriques du vaisseau. Le logiciel peut alors proposer plusieurs dimensions d’endoprothèses, à partir des informations recueillies. L’automatisation de cette phase vise à accélérer les mesures et à réduire les différences pouvant apparaître entre plusieurs analyses manuelles.