
[nextpage title= »Introduction »]
NVIDIA vient de dévoiler sa nouvelle architecture à destination des cartes graphiques : Ampere. Celle-ci a pour but de venir remplacer l’architecture Turing des GeForce RTX 20xx lancée il y a un peu plus de deux ans. NVIDIA a présenté lors de cette conférence de presse les trois premiers modèles Ampere : les RTX 3070, 3080 et 3090. Il s’agit de modèles Founders Edition (FE) conçus par NVIDIA.

Au niveau de la gravure, on passe finalement d’un process 12 nm (Turing) à du 8 nm (Ampere) réalisé par Samsung. Même si le 7 nm de TSMC aurait été envisagé, c’est son coût qui semble avoir décidé NVIDIA de se tourner vers Samsung. Au final, au vue des tarifs annoncés par la marque, c’est une bonne chose pour les futurs acheteurs, peut-être moins pour la consommation des cartes graphiques. Ce dossier se base sur les informations dont nous disposons à l’heure actuelle et celui-ci sera donc très certainement mis à jour dans les jours à venir selon les nouvelles informations disponibles. Nous ajouterons une page dédiée au PCB Ampere afin de vous expliquer les différents emplacements des VRM, de la mémoire et du GPU.
Avant de débuter la lecture de ce dossier, nous vous invitons à jeter un œil à nos précédents dossiers traitant des GPU :
[nextpage title= »RTX 3070, RTX 3080 et RTX 3090″]
Les slides de présentation de NVIDIA laissent sous entendre que la RTX 3070 aurait des performances proches, voire supérieures à la RTX 2080 Ti. Oui, vous avez bien lu. La RTX 3080, quant à elle, disposerait de performances deux fois supérieures à la RTX 2080 Super comme semble l’attester cette vidéo de Doom Eternal en 4K.
La RTX 3090 fait office d’ovni avec des performances annoncées comme plus élevées que la carte Titan RTX. Elle semble s’orienter vers le monde des professionnels alors que les deux autres sont clairement à destination des gamers.
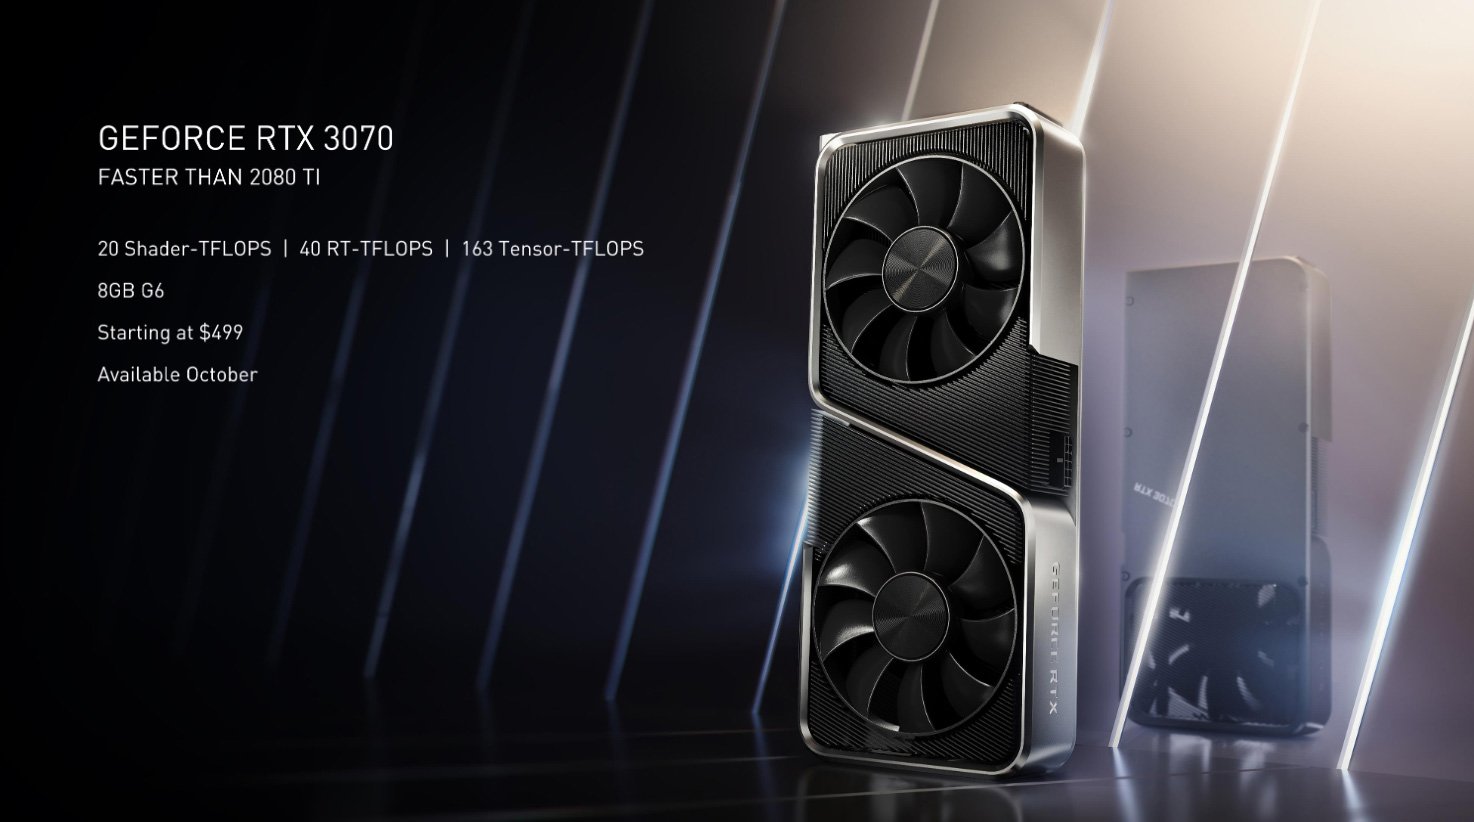
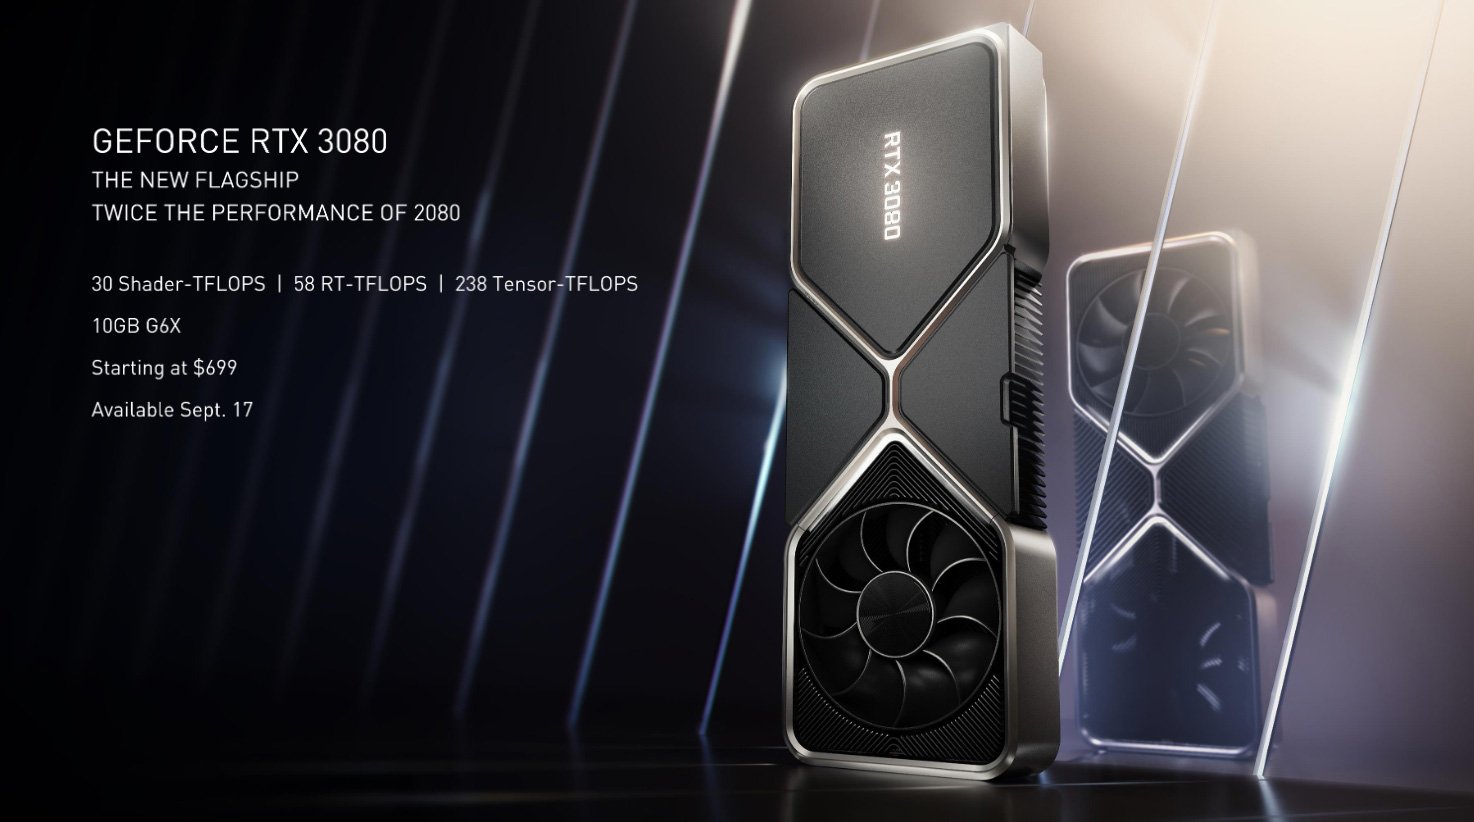
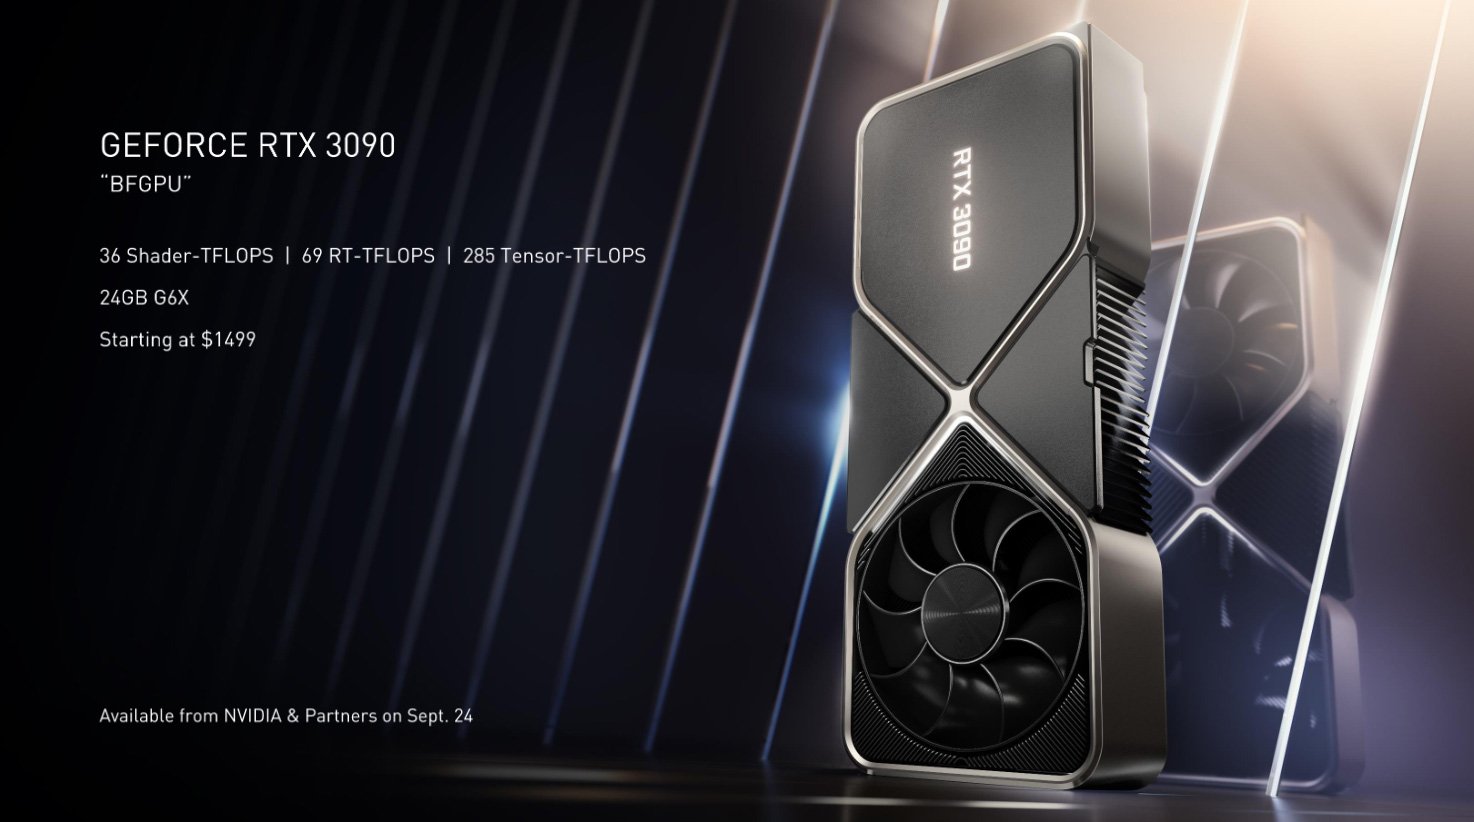
Les trois modèles cités ci-dessus ont comme particularité de disposer d’un connecteur d’alimentation PCIe à 12 broches spécifiques et dont la taille est réduite face à un modèle 8 broches. NVIDIA fournira dans le bundle de ses cartes un adaptateur 8+8 broches afin de rendre compatible votre alimentation. Nous ne pouvons que vous conseiller d’opter pour une alimentation de marque, oubliez les no name, et au minimum de 650 watt pour la RTX 3070.
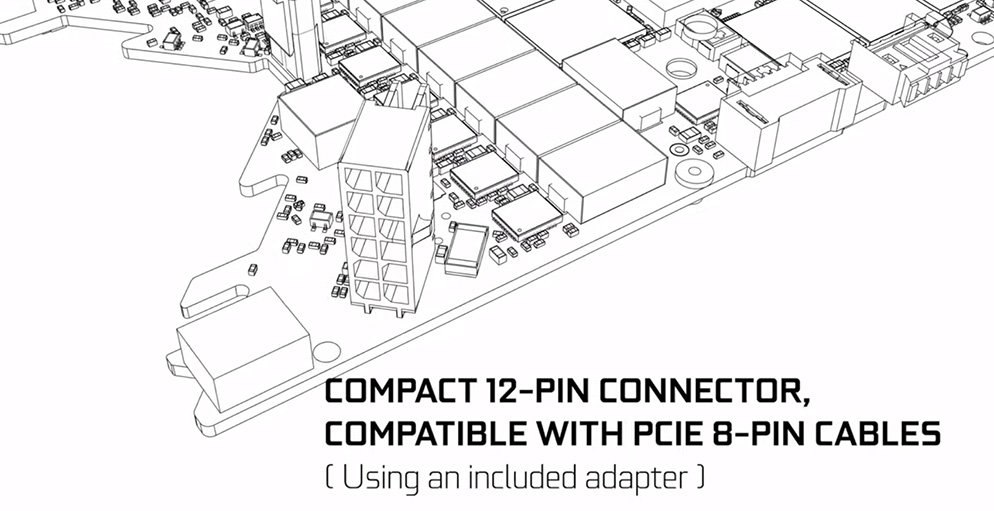
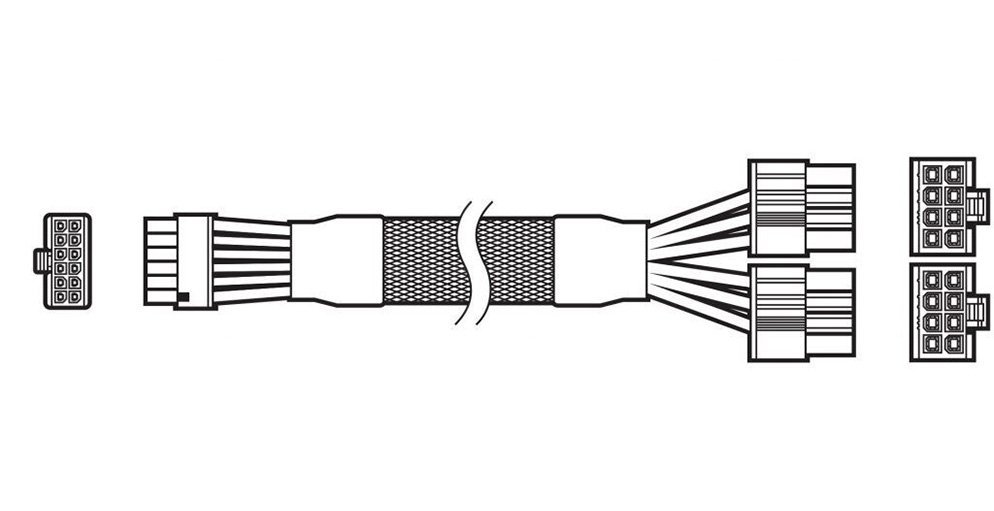
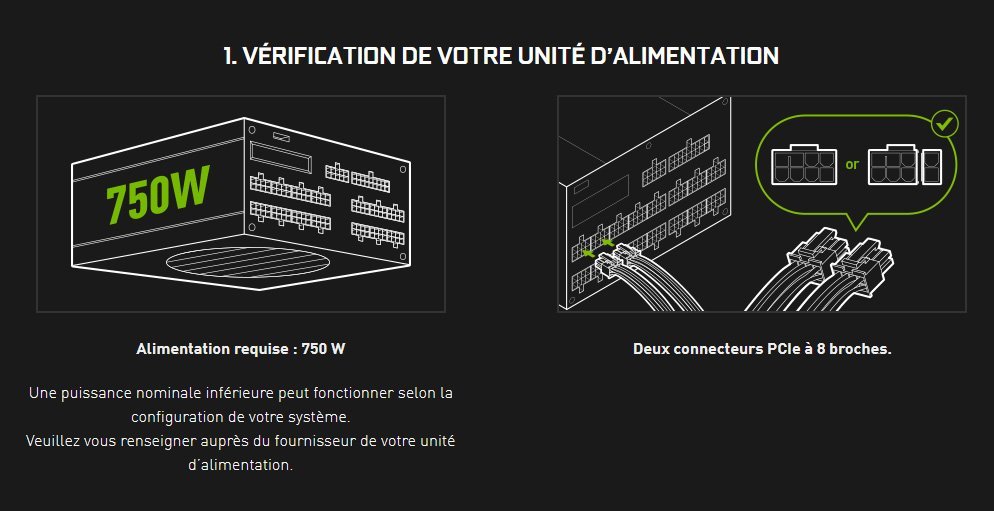
Les partenaires de NVIDIA proposeront eux des cartes customs disposant des traditionnels connecteurs 8 broches et selon le modèle, ils seront au nombre de 1, 2 ou 3. Bien entendu, NVIDIA proposera par la suite d’autres modèles afin de compléter sa gamme avec très certainement une RTX 3060 ainsi que des versions Ti ou Super.
Alors que la RTX 3070 sera équipée de mémoires GDDR6, les deux autres modèles se verront pourvus de GDDR6X de la marque Micron. Cette dernière devrait permettre de doubler la quantité d’information transmise et d’atteindre une bande passante jusqu’à 1 To/s, avec une vitesse de 19 à 21 Gbps par broche (et même au-delà dans de futures évolutions), contre 14 à 16 Gbps pour la GDDR6.
Enfin, pour terminer, sachez que seul le modèle RTX 3090 dispose d’un connecteur NVLink permettant de coupler plusieurs cartes.
[nextpage title= »Un nouveau système de refroidissement »]
Dès le mois d’août, de premières photos de ce qui devaient être les futures RTX 30xx ont fuité. Ces photos ont énormément fait parler d’elles puisque le système de refroidissement ne ressemblait à rien de ce que nous connaissions jusqu’à présent. La conférence de presse a confirmé la véracité de ces photos volées et nous a ainsi permis de comprendre le principe et le fonctionnement de ce nouveau système de refroidissement.
Celui-ci équipera uniquement les versions Founders Edition des RTX 3080 et RTX 3090. La RTX 3070 conserve elle une ventilation plus traditionnel. Ce choix s’explique par l’utilisation de puces mémoires GDDR6X qui auraient tendance à dégager plus de chaleur et surtout, qui se trouvent de part et d’autres du PCB sur la RTX 3090.


L’objectif est, comme pour tout système de refroidissement, de maintenir le GPU au frais tout en produisant des nuisances sonores acceptables. NVIDIA a donc eu l’idée d’utiliser deux ventilateurs mais placés de part et d’autre de la carte graphique. Celui de gauche aspire l’air au sein de votre boitier et est ensuite expulsé par l’arrière de la carte. L’autre ventilateur, situé à droite, aspire lui aussi l’air de votre boitier afin de dissiper la chaleur de la chambre à vapeur avant d’être expulsé en position haute, toujours au sein de votre boitier. Inutile de dire que vous devrez opter pour une bonne circulation de l’air au sein de votre boitier si vous désirez maintenir vos composants à de fraîches températures.
[nextpage title= »Les prix, la première bonne surprise »]
Actuellement, nous ne connaissons que les prix des modèles Founders Edition proposés par NVIDIA et déjà référencés sur leur site.
Le prix des modèles customs RTX 3080 seront annoncés à partir du 17 septembre, date du lancement officiel de ce modèle. Il faudra attendre le 24 septembre pour les RTX 3090 et le mois d’octobre pour les RTX 3070. La disponibilité devrait être effective le jour J mais en nombre ? Telle est la question.
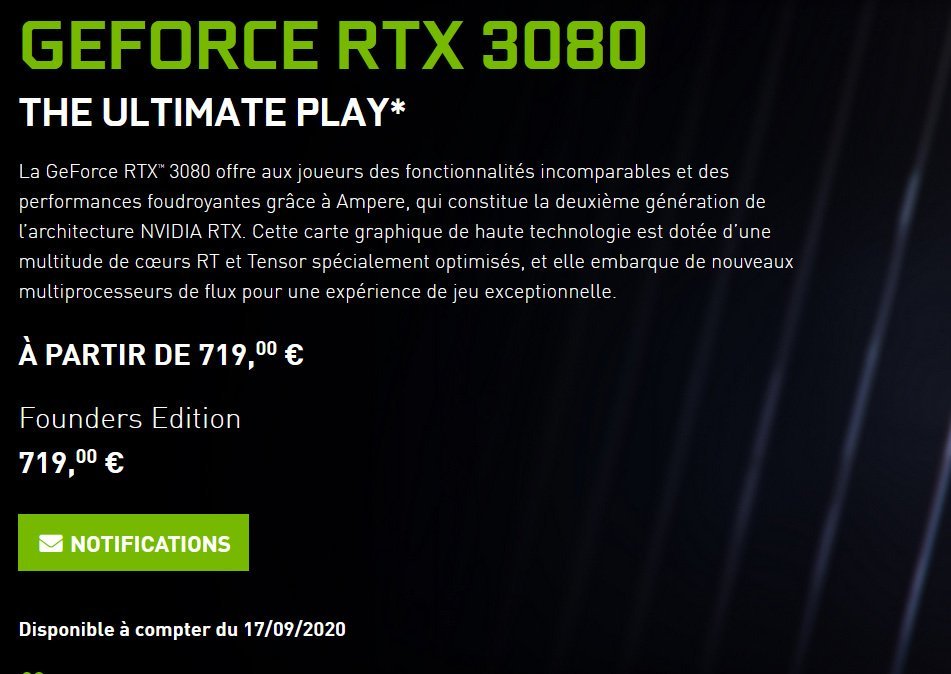
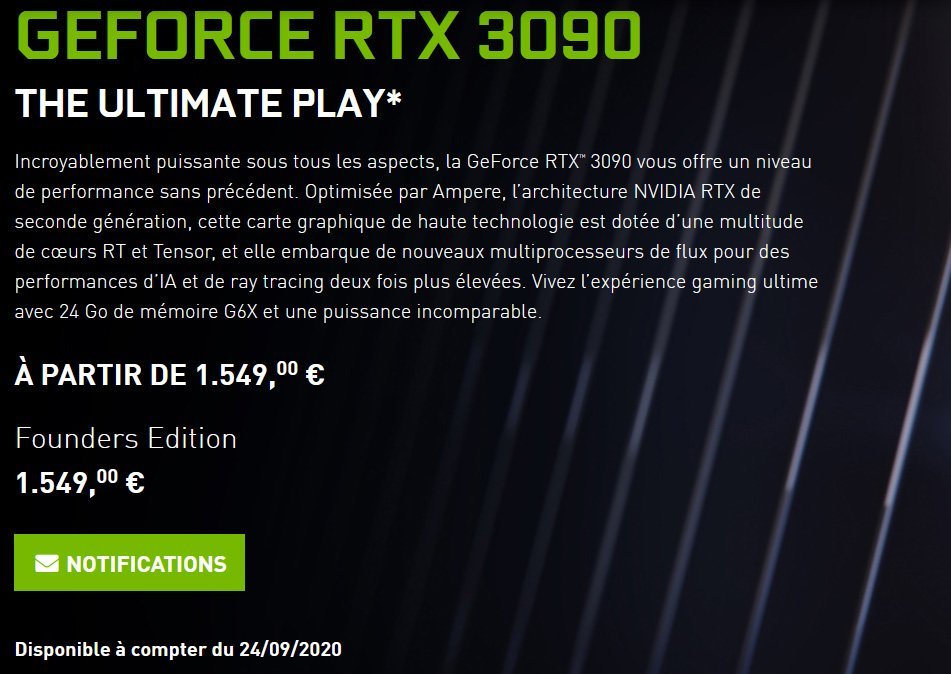
Du côté de NVIDIA, la RTX 3070 FE est annoncée à 519 euros, la RTX 3080 FE à 719 euros et enfin la RTX 3090 à 1549 euros. Selon les performances annoncées dans les slide de NVIDIA, ces prix sont tout bonnement très intéressants pour les deux premiers modèles ! Ce sont d’ailleurs les possesseurs de RTX 2080 Ti qui doivent être un peu refroidi, mais ça, nous y reviendrons par la suite.
On peut constater en se baladant sur la toile ou sur notre Discord que l’engouement pour ces nouvelles cartes est très important. Nombreux sont ceux qui affirment prendre une RTX 3080 ce 17 septembre, jour de son lancement. Cependant, le nombre de cartes devrait être très limité dans un premier temps et il ne faudra donc pas vous posez trop de questions si vous voulez être dans les premiers servis.
[nextpage title= »Détaillons l’architecture Ampere »]
Et pour commencer, voici un tableau, presque complet, qui reprend les différentes caractéristiques que nous connaissons déjà sur les nouvelles cartes. Nous y avons ajouté volontairement la RTX 2080 Ti ainsi que la RTX 2080 Super afin que vous puissiez juger de l’évolution. Nous avons choisi de mettre ces deux modèles Turing en avant puisque NVIDIA compare ses nouvelles cartes justement avec eux.

Attardons-nous à présent sur les slides proposés par NVIDIA et à l’organisation interne au sein d’un SM (Streaming Multiprocessors). L’organisation y est différente par rapport à Turing et cette modification va permettre de doubler le nombre de FP32. Si vous observez bien la photo ci-dessous, vous pouvez apercevoir 4 blocs de 32 unites dans un SM. Dans chacun de ces blocs, on retrouve 16 FP32 ainsi que 16 FP32/INT32. Dans la pratique, soit le bloc peut gérer 32 instructions FP32 par cycle soit 16 instructions FP32 et 16 instructions INT32 par cycle. Si maintenant on regarde l’entièreté du SM, on dispose de 4 blocs permettant d’atteindre soit 128 instructions FP32 par cycle (32 x 4) soit 64 instructions FP32 (16 x 4) et 64 instructions INT32 par cycle (16 x 4).
C’est cela qui permet à Ampere de doubler le nombre de FP32 par rapport à Turing sans devoir augmenter la surface de la puce GPU. Le fait de doubler la vitesse de traitement du FP32 va améliorer les performances d’un grand nombre d’opération !

On peut également situer les 4 emplacements Tensor Core et celui du RT Core. Nous reviendrons par la suite sur leur rôle respectif.
Prenons à présent comme exemple la RTX 3080 afin de mettre en application ce dont nous avons parlé ci-dessus. Observez bien la photo ci-dessous.

Si l’on reparle des SM (Streaming Multiprocessors) dont nous avons détaillé la structure ci-dessus, ils sont au nombre de 68. Les 8704 CUDA Cores de la RTX 3080 se calcule en multipliant le nombre de SM (68) par les 128 instructions FP32 par cycle, ce qui nous donne un total de 8704.
Enfin, les Flops sont une unité de calcul utilisée pour les cartes graphiques. Pour être clair, il s’agit du nombre d’opérations pouvant être effectuées en une seconde sur des nombres à virgule flottante (source). Elle s’exprime la plus part du temps en TeraFLOPS (TFLOPS).
Pour obtenir la puissance de calcul d’une carte graphique, il suffit de réaliser ce calcul : nombre de CUDA Cores x Fréquence GPU (en GHz) / 1 000 x 2 = valeur (en TFLOPS).
Prenons l’exemple de la RTX 3080 : 8704 x 1.71 GHz : 1000 x 2 = 29,767 TFLOPS.
Les plus attentifs auront remarquer que les Tensor Cores sont eux au nombre de 68 x 4 par SM, c’est-à-dire 272. Mais quoi ? La RTX 2080 Ti en possédait 544 ! Cette RTX 3080 serait donc moins performante ? Non, et on vous explique ci-dessous pourquoi.
Quand au nombre de RT Core, il est de 68 comme sur la 2080 Ti, mais eux aussi, sont de nouvelle génération.
Les Tensor Cores de 3e génération :
Les Tensors Cores sont des unités dédiées aux calculs de l’IA (Deep Learning et Inférence) en usant de précisions de calculs faibles comme le FP16. Au contraire des unités shaders qui calculent en 2x par cycle (1 Addition et 1 Multiplication), les unités Tensors calculent sous forme de matrice 4×4, donc 16 additions et 16 multiplications par cycle.
NVIDIA a recourt au DLSS qui permet un gain en terme de FPS en remplaçant l’antialiasing TAA. L’idée est de permettre un affichage plus rapide tout en conservant une qualité de rendu quasiment identique. Lors de la conférence de presse, nous avons pu apprendre que le DLSS passait en version 2.1 et prenait en charge le 8K.


Comme nous vous le disions plus haut, sur une RTX 3080, ils sont moins nombreux (272) que sur la RTX 2080 Ti (544) mais ceux-ci évoluent et sont de 3e génération. Malgré cela, ils parviennent à doubler la puissance de calcul sur les matrices denses et de la quadrupler sur les matrices creuses. Une matrice dense contient peu de 0 et une matrice creuse beaucoup de 0.
Les RT Cores de 2e génération:
Les RT Core sont utilisés par l’API Ray Tracing, une solution pour l’éclairage, les reflets et les ombres réalistes. Chaque SM dispose d’un RT Core, donc 68 unités au total. Turing était la première architecture à le proposer en temps réel. Comme pour les Tensor Cores, les RT Cores évoluent aussi ! NVIDIA les annonce plus efficaces et surtout capables de réaliser des calculs plus rapidement.


[nextpage title= »De nouveaux outils à disposition de la presse »]
L’arrivée prochaine des cartes graphiques RTX 3080, RTX 3090 et RTX 3070 coïncide certainement avec la mise à jour par NVIDIA de son logiciel FrameView. Celui-ci vient de passer en version 1.1 (lien de téléchargement). Si vous ne connaissez pas encore ce programme, FrameView est une application qui vous permet de mesurer la fréquence d’images, les délais d’image, la consommation et les performances par Watt d’une grande variété de cartes graphiques. Cette nouvelle version apporte plusieurs nouveautés détaillées sur cette page. De notre côté, nous avons installé cette nouvelle version dont nous vous donnerons nos impressions d’ici quelques jours.
Dans un autre temps, nous avons appris que NVIDIA allait fournir à certains journaliste un « NVIDIA Reviewer Toolkit for Graphics Performance ». Il se compose de deux éléments dont le but est de vous permettre de réaliser deux types de mesure :
- Latency and Display Analysis Tool (LDAT) : utilisé pour mesurer la latence du système de bout en bout.
- Power Capture Analysis Tool (PCAT) : utilisé pour mesurer uniquement la puissance totale du/des GPU.
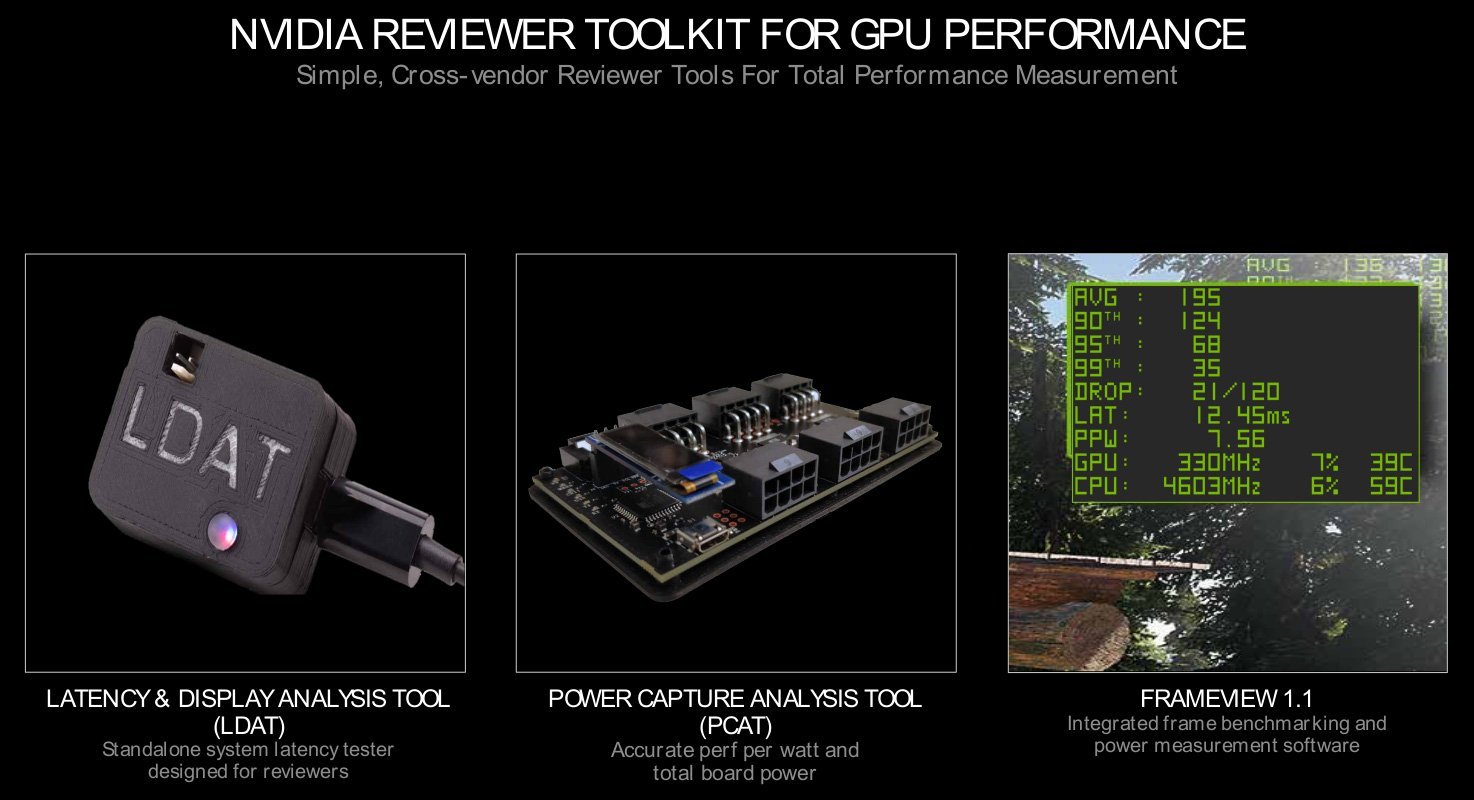
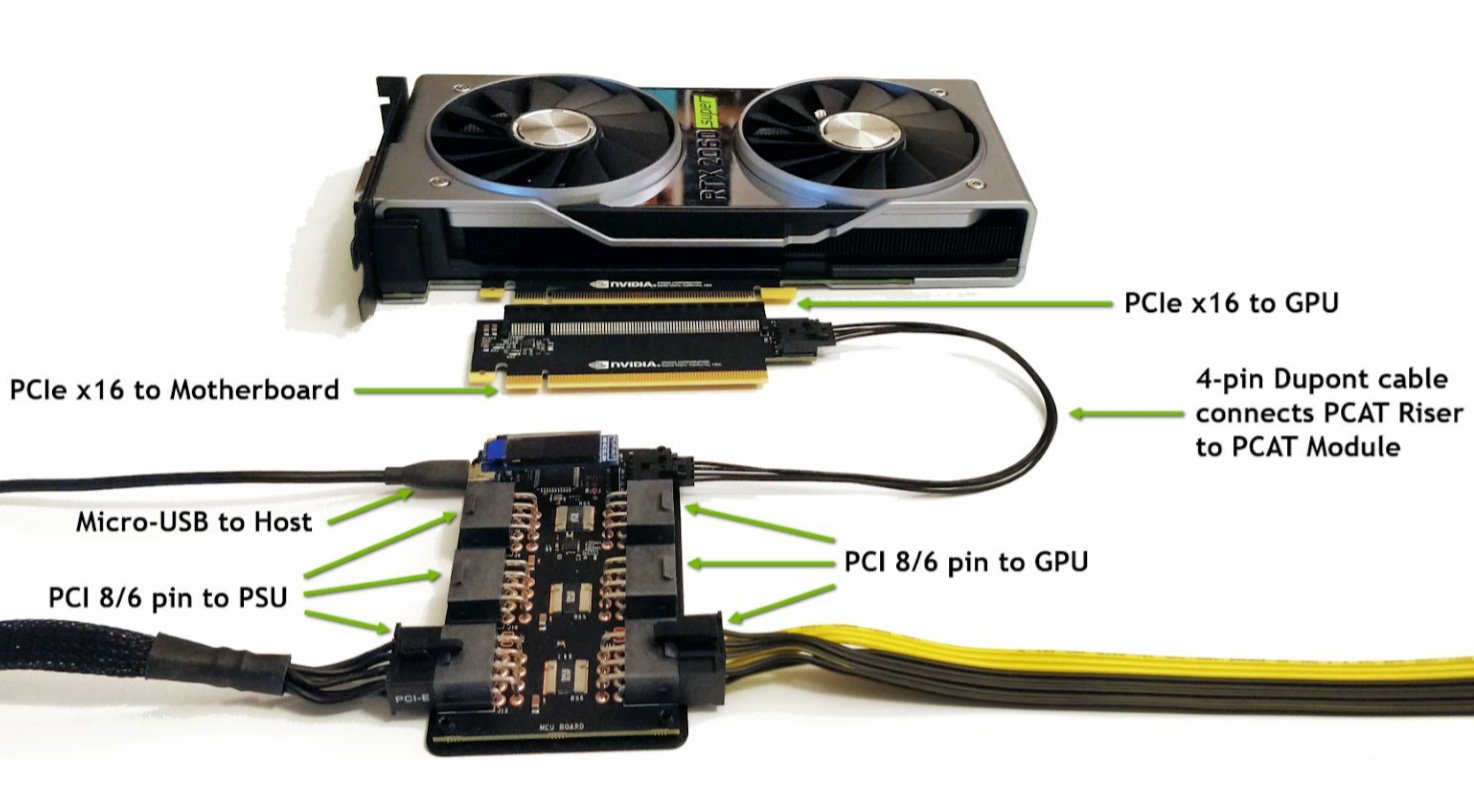
Ces mesures sont bien entendues compatibles avec la nouvelle version de Frameview. Il s’agit là d’une boite à outils qui pourrait se montrer rudement intéressante pour mesurer notamment la consommation du GPU. Nous devrions aussi avoir accès à cet outil afin de vous faire part de nos impressions.
L’arrivée de cette nouvelle architecture et le lancement par AMD du RDNA2 va nous inciter à mettre à jour notre plateforme de tests afin de pouvoir évaluer au mieux ces nouvelles cartes graphiques. Nous vous en reparlons très bientôt.